
DeepEval 4.0がAIコーディングエージェント評価を変える
要約
DeepEval 4.0がリリースされ、Claude CodeやCursorなどのAIコーディングエージェント向けの評価機能が大幅に強化されました。CLI統合やCI/CDパイプラインへのPytest連携など、LLMOpsを実装するうえでの具体的な手立てと、開発現場への影響を整理します。
AIコーディングエージェントを開発現場に持ち込む企業が増えています。「エージェントが正しく動いているか」を継続的に確かめる仕組みへの関心が高まっています。
そうした流れの中、LLM評価フレームワークのDeepEvalがバージョン4.0をリリースしました。Claude CodeやCursorといったコーディングエージェントの評価に特化した機能強化が中心です。
LLMOpsの実装コストを下げる具体的な手立てが揃っています。
この記事の対象読者
- Claude CodeやCursorなどのAIコーディングエージェントを業務に導入している、または検討中のエンジニア・開発チーム
- LLMの出力品質をCI/CDパイプラインで管理したいと考えているMLエンジニア・DevOps担当者
- LLMOpsの整備を進めたいが、どこから手をつければよいか迷っているプロダクト責任者
DeepEval 4.0で追加された機能
強化の中心はコーディングエージェント評価
DeepEvalの公式ブログによると、バージョン4.0では評価機能が大幅に強化されました。
Claude CodeやCursorのような「vibe coding agents」向けの機能が中心になっています。
今回の主な追加機能は以下のとおりです。
追加された5つの機能
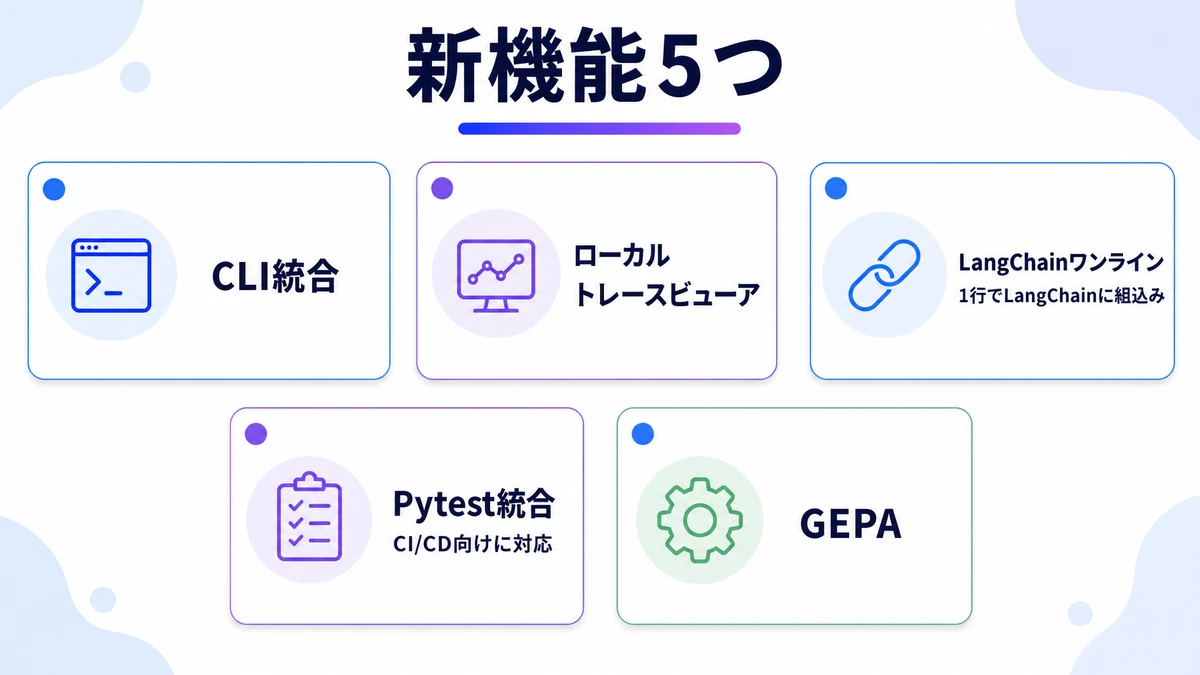
- CLI統合: コマンドラインから直接評価を実行できるようになり、開発ワークフローへの組み込みがシンプルになった。
- ローカルトレースビューア: エージェントの推論ステップをローカル環境で可視化し、問題箇所の特定が速くなった。
- LangChainへのワンライン統合: 既存のLangChainプロジェクトに1行追加するだけで評価を開始できる。
- CI/CD向けPytest統合: Pytestの仕組みをそのまま使い、LLMの出力品質チェックをCIパイプラインに組み込める。
- GEPA(ベータ版): プロンプト最適化機能。評価スコアをもとにプロンプトを自動的に改善するサイクルを提供する。

「動く」から「品質を保証して動く」へ、何が変わったのか
導入初期に起きやすいこと
私たちが接してきた範囲では、AIコーディングエージェントの導入初期は「とにかく動かしてみる」フェーズが多い傾向にあります。
まずは手元で動かして手応えを確かめる段階でしょう。
しかし開発チームがエージェントをプロダクションに組み込み始めると、プロンプトを少し変えただけで出力が大きく変わる「regression」問題が表面化します。
手動確認だけでは追いきれなくなるのです。
Pytest統合が出す実務的な答え
DeepEval 4.0のCI/CD向けPytest統合は、こうした課題に対して実務的な答えを出しています。コードのテストと同じ感覚で、LLMの出力品質を自動的にチェックするゲートを設けられるからです。
| フェーズ | 主な課題 | DeepEval 4.0の対応 |
|---|---|---|
| PoC・試験導入 | 動作確認が手作業・属人的 | CLIでシンプルに評価を実行 |
| 開発・統合 | フレームワークへの組み込みコストが高い | LangChainへのワンライン統合 |
| 本番稼働・運用 | プロンプト変更による品質劣化の検知が遅い | CI/CD向けPytest統合でregressionを自動検知 |
| 継続的改善 | 評価スコアを改善に活かす仕組みがない | GEPAでプロンプトを自動最適化(ベータ) |
開発組織がDeepEval 4.0を試す際の進め方
後付けだとつまずきやすい
評価ハーネスを後付けで整備しようとすると、テストケースの設計がボトルネックになりがちです。
DeepEval 4.0を開発ワークフローに組み込む際は、以下の順序が現実的だと私たちは見ています。
現実的な導入ステップ
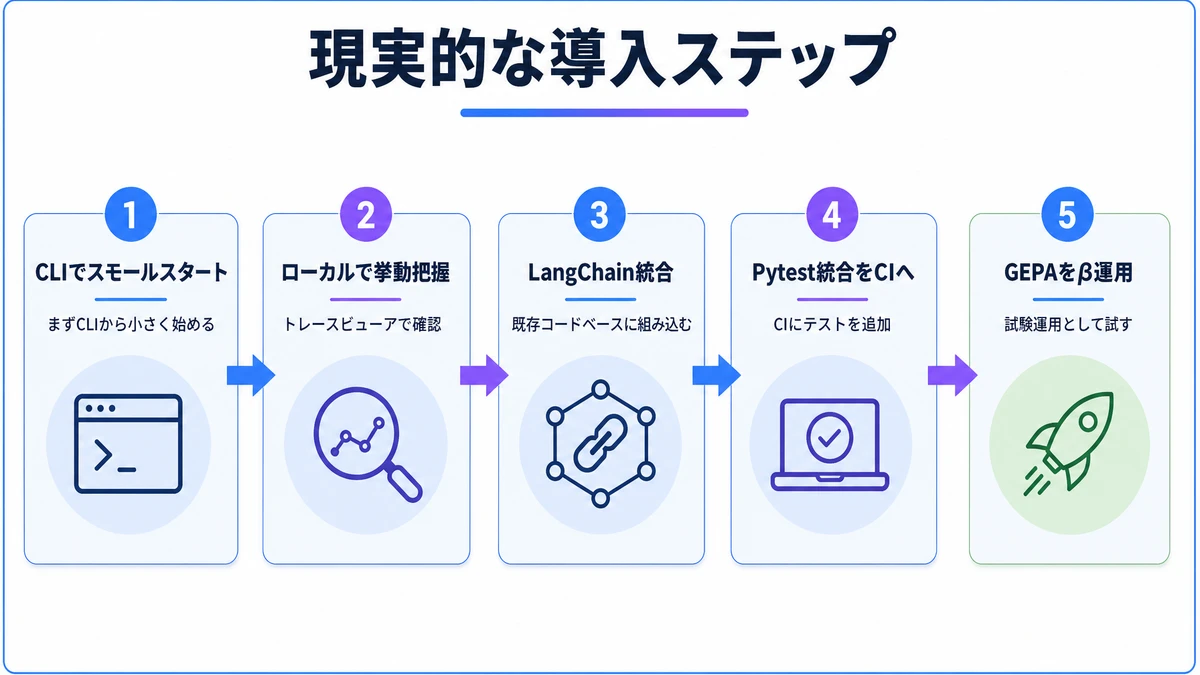
- まずCLIでスモールスタート: エージェントの主要なユースケースを3〜5件選び、期待する出力と評価基準を言語化する。
- ローカルトレースビューアで挙動を把握: エージェントがどのステップで判断を誤るかを可視化し、評価指標の設計に活かす。
- LangChain統合で既存コードベースに組み込む: 既にLangChainを使っているチームは1行追加から始められるため、移行コストが低い。
- Pytest統合をCIに追加: pull requestのたびに品質チェックが走る状態にする。最初は1〜2件のテストから始め、徐々に拡充する。
- GEPAはβとして試験運用: 評価スコアが安定してからプロンプト自動最適化を試す。本番投入前に十分な検証を行う。

よくある質問
DeepEvalはオープンソースで使えますか?
DeepEvalはオープンソースのLLM評価フレームワークとして公開されています。コアの評価機能はPyPI経由でインストールして利用可能です。
Claude CodeやCursorを使っていない場合も活用できますか?
Claude CodeやCursorはDeepEval 4.0が焦点を当てたユースケースです。とはいえLangChainなど他のフレームワークとも統合できます。コーディングエージェント以外のLLMアプリケーションの評価にも適用できます。
CI/CDへのPytest統合は既存のテストと共存できますか?
Pytestの仕組みをそのまま使うため、既存のユニットテストや統合テストと同じパイプライン上で動かせます。LLM評価のテストケースをPytestのファイルとして追加するだけで、既存の構成を大きく変える必要はありません。
GEPAのプロンプト最適化は本番環境でそのまま使えますか?
GEPAは現時点ではベータ版です。自動生成されたプロンプトが期待どおりに機能するかは事前に十分なテストが必要でしょう。そのまま本番投入するには慎重な検証が欠かせません。
評価ループをいつ整備すればよいですか?
私たちが見てきた範囲では、本番稼働後に整備しようとするケースがあります。すでに発生しているregressionの原因特定に時間がかかる傾向が多いです。
エージェントの設計段階から評価指標と自動チェックの仕組みを決めておく方が、後のコストを抑えやすいです。
「完璧な評価セットができてから」と待たないことをお勧めします。粗くても自動化された評価が1件動いている状態を早期に作ることが、実際の品質管理につながります。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
JiraがAIエージェントの司令塔になる。要件定義自動化とClaude Code連携の意味
アトラシアンがJiraにAI要件定義の自動作成・タスク自動割り当て・Claude CodeやGitHub Copilotとの連携機能を発表した。プロジェクト管理ツールがAIエージェントのオーケストレーション基盤へと役割を拡張するこの動きが、開発現場の実務にどう影響するかを整理します。
メルカリがClaude Code全社展開 非エンジニア1000人を対象に
メルカリがClaude CodeとClaude Coworkを全社展開し、非エンジニア1,000人以上がAIエージェントを体験しました。シャドーAI対策と活用促進を両立するための対象者設計、権限管理、社内展開の進め方を整理します。

GPT-5.6が問いかける「LLM選定は一度で終わり」という思い込みの危うさ
OpenAIが約3か月でGPT-5.5からGPT-5.6ファミリーへ主要モデルを刷新したとみられる動きは、企業のLLM選定・運用設計に何を迫るのか。モデル更新サイクルへの追随を前提としたLLMOps運用設計の必要性を、現場の視点から整理します。















