AIエージェントの分岐判断を軽量モデルへ移す方法Jevが示す推論コスト分担の設計

要約
TypeSafe AIが発表したJevは、文章生成ではなく分類や操作選択に特化したモデルです。AIエージェントの推論コストを見直すため、公開情報の読み方、人の確認へ戻す基準、複数モデルの分担方法を解説します。
AIエージェントの費用を下げるとき、生成部分だけを安いモデルへ置き換える方法が注目されがちです。今回のJevは、文章を生成するのではなく、次に何をするかという小さな判断に焦点を当てています。
この発想では、問い合わせの分類、担当先の振り分け、利用する操作の選択を軽量モデルが受け持ちます。高性能LLMは、判断の難しい案件や説明文の作成に絞る設計です。
この記事の対象読者
次のような課題を持つ企業や組織を想定しています。
- AIエージェントの推論費用を下げたい企業
- 分類や振り分けを自動化したい組織
- 高価なLLMの利用範囲を見直す企業
- 業務判断に確率値を使いたい企業
- 複数モデルを組み合わせたい企業
TypeSafe AIがJevを発表
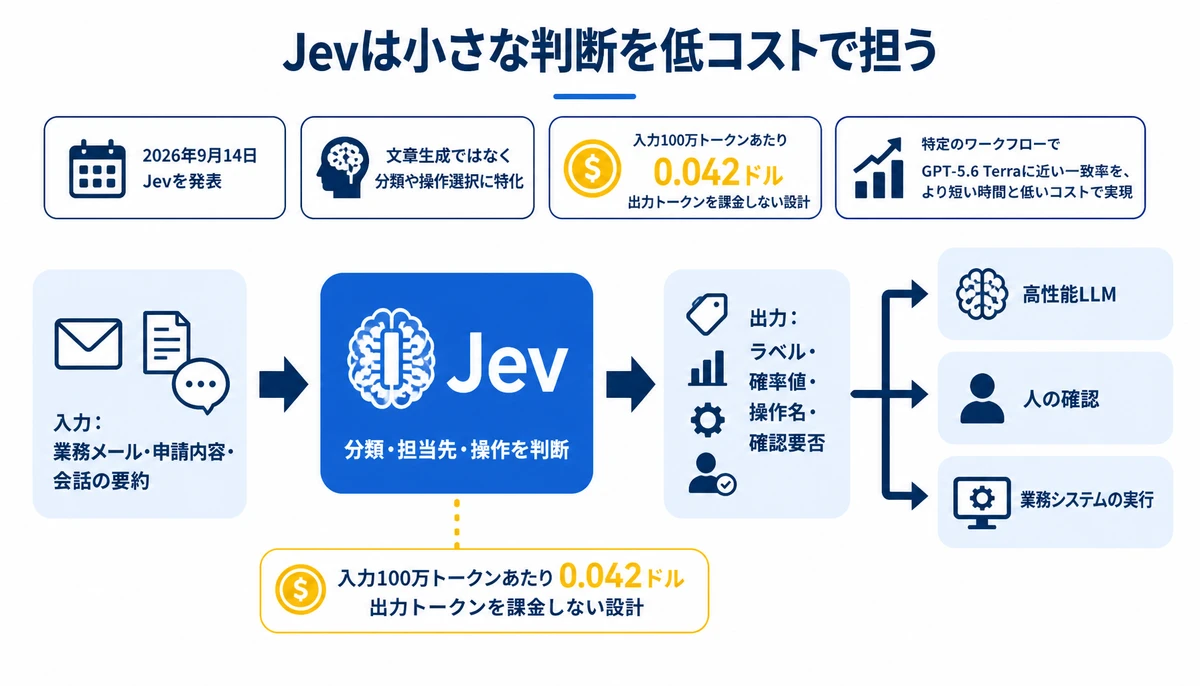
TypeSafe AIは2026年9月14日、AIモデルのJevを発表しました。公開情報では、Jevは文章生成ではなく、分類や操作選択などの小さな判断に特化したモデルと説明されています。
Jevの料金設計は、入力100万トークンあたり0.042ドルです。出力トークンを課金しない設計を掲げており、判断結果を短いラベルや操作として返す用途を意識した構成と読めます。
TypeSafe AIは、公開した特定のワークフローで、JevがGPT-5.6 Terraに近い一致率を、より短い時間と低いコストで実現したと説明しています。これは特定条件の結果であり、すべての業務にそのまま当てはまる数字ではありません。
- 入力: 業務メール、申請内容、会話の要約など
- 判断: 分類、担当先、次に呼び出す操作の選択
- 出力: ラベル、確率値、操作名、確認要否
- 後段: 高性能LLM、人の確認、業務システムの実行

生成しないモデルの使い道
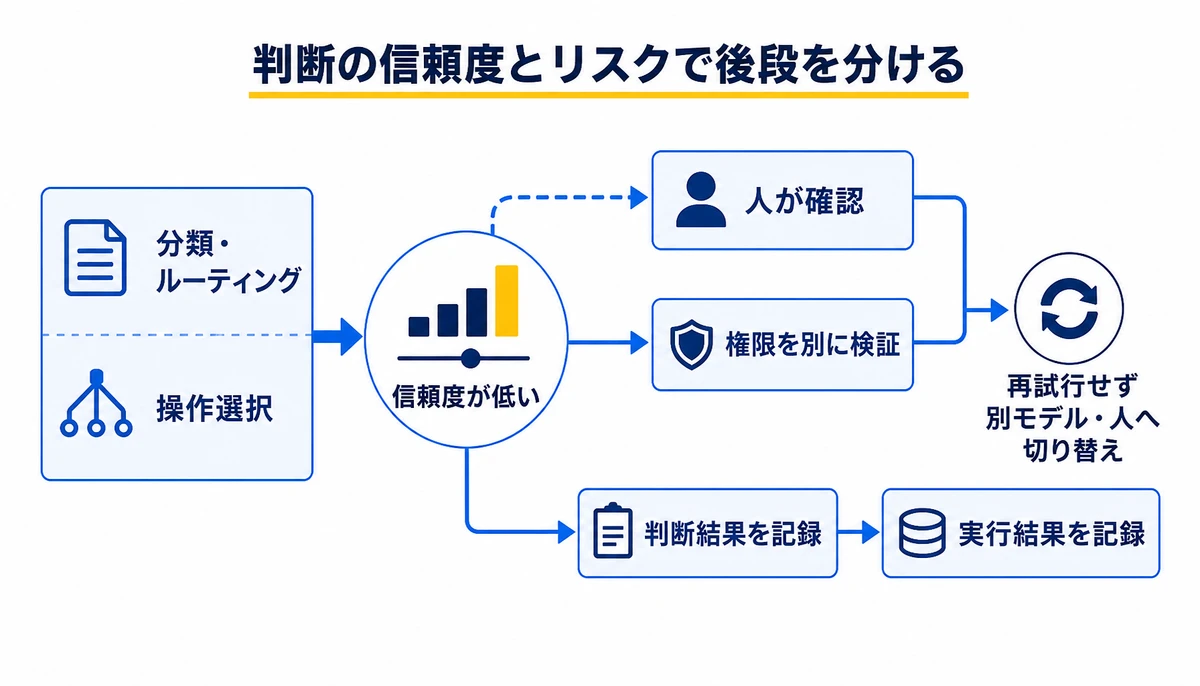
AIエージェントの処理を、生成と判断に分けて考えます。判断が定型化しやすい部分を軽量モデルへ移せば、高性能LLMの呼び出し回数や入力する文脈を減らせる可能性があります。
| 処理 | 担当候補 | 確認する観点 |
|---|---|---|
| 分類 | 軽量モデル | ラベルの定義が業務上ぶれないか |
| ルーティング | 軽量モデル | 担当先の誤りが処理へ与える影響 |
| 操作選択 | 軽量モデルまたはLLM | 実行前に権限と引数を検証できるか |
| 文章生成 | 高性能LLM | 正確性、表現、説明責任を確認できるか |
BinxAIが現場で見る限り、軽量モデルの導入はモデル単体の比較で終わりません。信頼度が低いときに人へ戻す条件を決め、誤った分岐が起きた後の再試行や記録まで含めて設計します。
たとえば、軽量モデルが「経費申請」と判断しても、金額や権限に関わる操作は自動実行しない構成にできます。確率値をそのまま正しさとみなさず、業務上のリスクと組み合わせて確認要否を決める考え方です。
- 信頼度が低い判断は、人が確認してから次へ進める
- 重要な操作では、信頼度が高くても権限を別に検証する
- 失敗時は同じ入力を無限に再試行せず、別モデルや人へ切り替える
- モデルのバージョンとプロンプトを固定し、変更後に同じ評価を行う
- 判断結果と実行結果を分けて記録する
推論コストを分担で見直す
費用見積もりで見るべき範囲
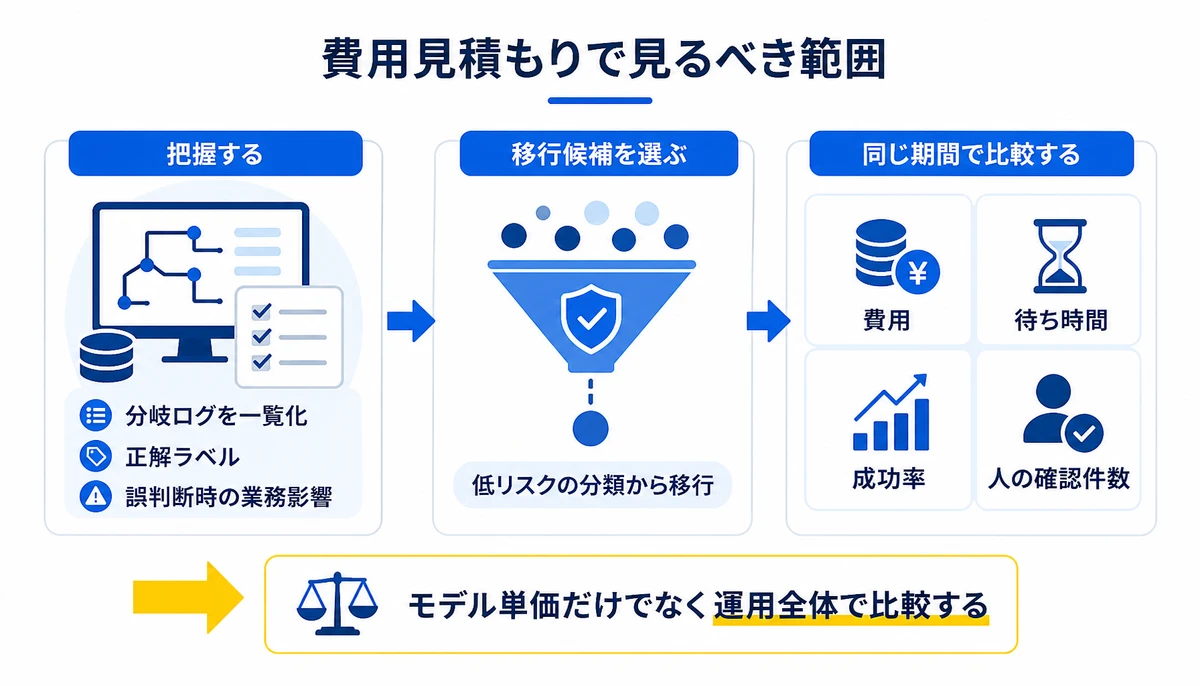
Jevの料金設計は、判断処理を専用モデルへ切り出す発想を検討する材料になります。費用削減の見積もりでは、モデル単価だけでなく、再試行、人の確認、失敗後の復旧にかかる処理も含めます。
最初から全体を置き換える必要はありません。既存のAIエージェントで分岐ログを集め、判断の種類ごとに軽量モデルへ移せる範囲を確認すると、影響を限定して比較できます。
- 高性能LLMが判断している分岐を一覧化する
- 正解ラベルと誤判断時の業務影響を整理する
- 軽量モデルへ移す候補を低リスクの分類から選ぶ
- 費用、待ち時間、成功率、人の確認件数を同じ期間で比べる
ベンチマークの確認ポイント
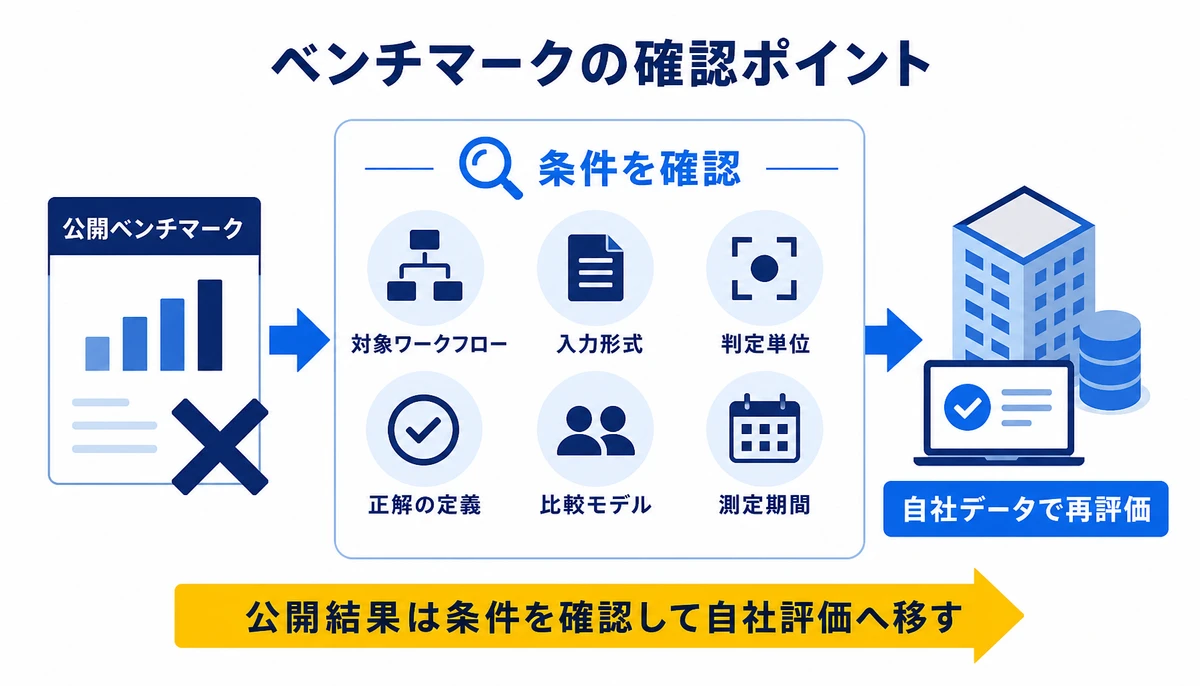
公開ベンチマークは、モデルの優劣を一列に並べる資料ではありません。自社の入力に近いか、判定単位が同じか、失敗をどのように数えたかを確認してから、PoC(概念実証)の評価項目へ落とし込みましょう。
自社で進める際の判断材料
判断ログの整理と業務ルールの確認
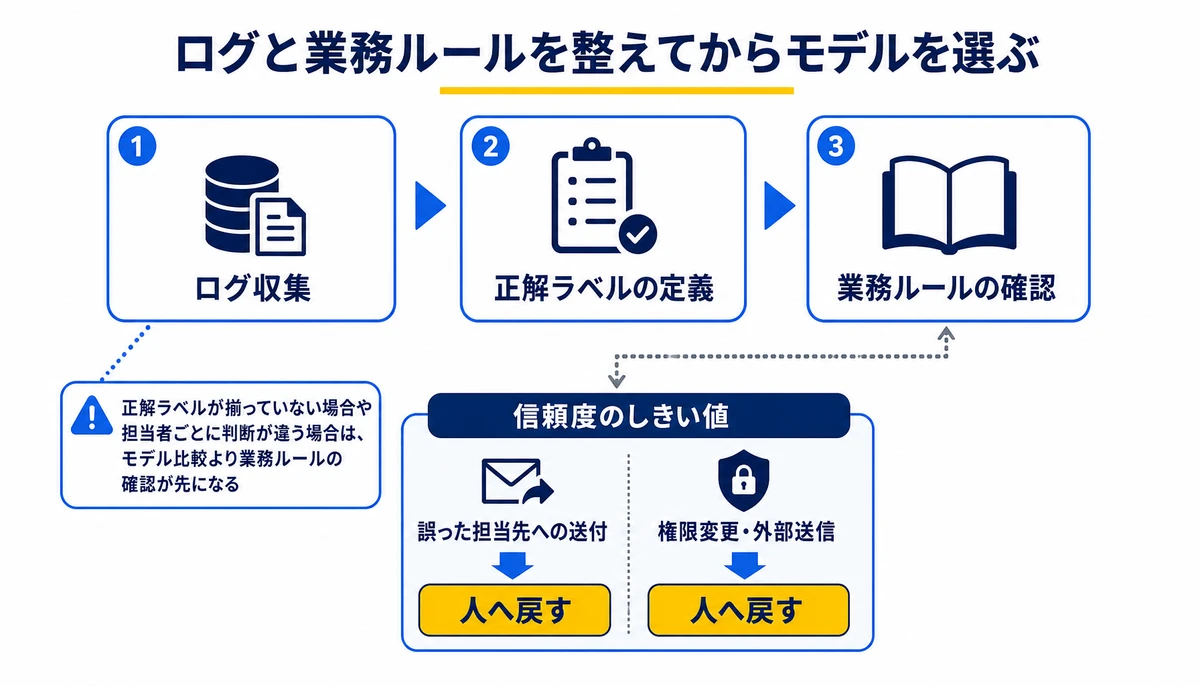
自社で分岐判断を移すときは、まず判断ログの整理に時間がかかります。正解ラベルが揃っていない場合や、担当者ごとに判断が違う場合は、モデル比較の前に業務ルールの確認が先決です。
次に、信頼度のしきい値を決める必要があります。誤った担当先へ送るだけの処理と、権限変更や外部送信を伴う処理では、人へ戻す条件を分ける設計が現実的です。
みっちゃくんが進める支援の流れ
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく、整理した要件に沿った詳細な見積を出す方針です。
契約後に要件が動いても決めた範囲で優先順位を入れ替えて進めます。企画や課題整理、要件整理から開発までを同じ担当が受け持ち、運用の引き継ぎと内製化まで支援します。
料金は公式ページと無料相談で案内し、案件ごとに対象範囲を確認します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Jevは文章生成にも使えますか?
公開情報では、Jevは文章生成ではなく分類や操作選択などの小さな判断に特化したモデルです。回答文の作成は、高性能LLMなど別のモデルへ分担させる構成を検討します。
軽量モデルへ移すと必ず安くなりますか?
必ず安くなるとは限りません。再試行、人の確認、誤分岐からの復旧を含めたワークフロー全体で、移行前後の費用を比べてから判断しましょう。
信頼度は何に使えばよいですか?
信頼度は自動実行と人の確認を分ける材料になります。しきい値は一律に決めず、誤判断が権限変更や外部送信につながるかで分けます。
公開ベンチマークで高評価なら導入できますか?
そのまま導入できるとは限りません。対象ワークフロー、入力形式、正解の定義、比較モデル、測定期間が自社と近いかを確認し、自社データで再評価するのが先決です。
最初にどの判断を移すべきですか?
誤った分岐の影響が限定的で、正解ラベルを作りやすい分類から始めるのがおすすめです。結果を記録し、人の確認件数や再試行まで確認してから対象を広げます。
あわせて読みたい
Jevが示したのは、AIエージェントを1つの高性能LLMだけで構成しない選択肢です。分類や操作選択を軽量モデルへ分担し、信頼度が低い判断を人へ戻す設計から、自社のワークフローを見直せます。
本記事の情報は2026年9月19日時点の公開情報に基づきます。他社サービスの仕様、価格、性能は変更される可能性があるため、契約や導入の前に各社へ確認してください。記載した構成や効果が、特定の成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
同じ品質で費用が5倍変わるAI推論コストを下げる企業の設計と運用
AI API料金やAIエージェント費用が膨らむ企業に向け、モデルルーティング、キャッシュ、オフピーク実行、再試行を含むタスク単位のTCO管理を解説します。

100万トークンと音声・動画対応Qwen3.8 Omni Flashを企業はどう使うか
AlibabaのQwenチームが公開したQwen3.8 Omni Flashは、テキスト・画像・音声・動画と最大100万トークンの文脈に対応します。企業が会議録や現場映像で試す際の評価項目と、API・オンプレミス運用の見極め方を整理します。

Step 5 Previewの性能とコスト 企業のAIエージェント運用に使えるか
StepFunのStep 5 Previewが発表されました。600B規模のMoEモデルを企業のAIエージェントで使うとき、API利用と重みを使った自社運用をどう比較するか、GPU費用やライセンス確認を含めて整理します。