同じ品質で費用が5倍変わるAI推論コストを下げる企業の設計と運用
要約
AI API料金やAIエージェント費用が膨らむ企業に向け、モデルルーティング、キャッシュ、オフピーク実行、再試行を含むタスク単位のTCO管理を解説します。
この記事の対象読者
- AI利用量の増加で費用が膨らむ企業
- 複数のLLMを使い分けたい企業
- AIエージェントの予算超過を防ぎたい組織
- API費用を業務単位で管理したい企業
- 特定ベンダーへの依存を減らしたい企業
技術責任者やプロダクト責任者が、モデル構成と運用費の設計を見直す場面を想定しています。単価表を比べるだけでなく、業務の完了条件まで含めて判断したい方に向く内容です。
5倍差を生む推論経済圏
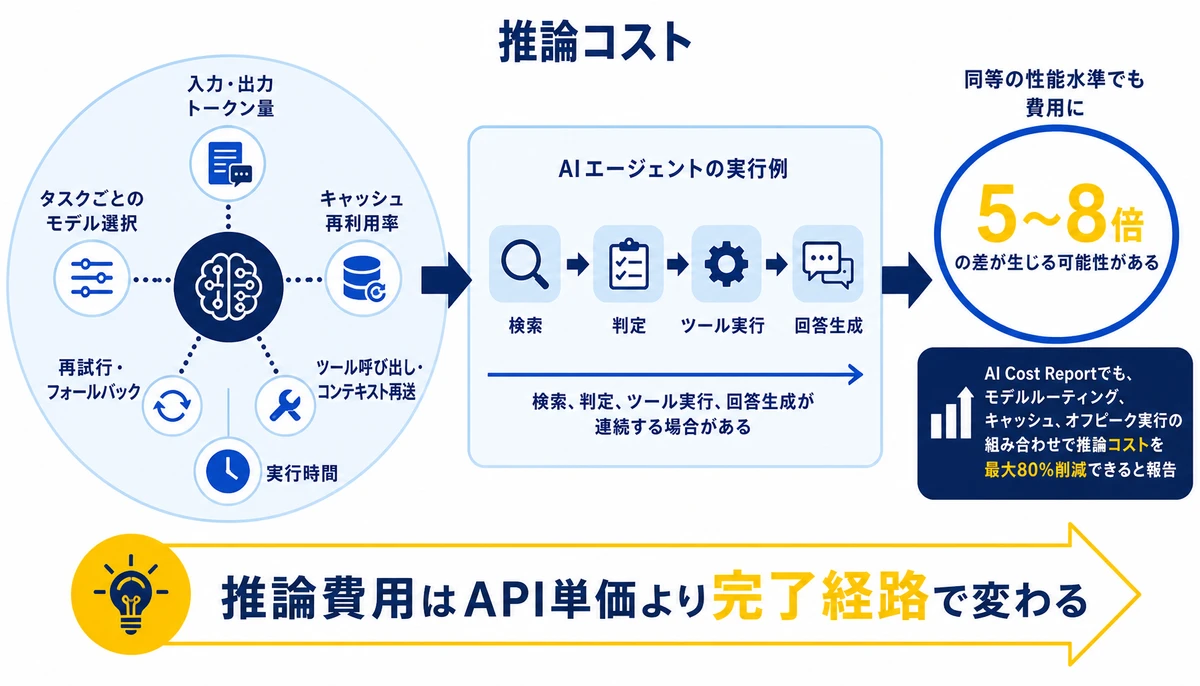
海外では、複数モデルの使い分けやキャッシュによる推論コスト最適化が議論されています。AI Cost Reportでは、同等の性能水準を狙う場合でも、タスクや実行条件によって費用に5〜8倍の差が生じる可能性が示されています。
BinxAIが企業の現場で見てきた範囲では、費用差はモデルのトークン単価だけで決まりません。どの処理をどのモデルに送り、いつ実行し、失敗時に何回やり直すかまでを含めた設計で差が広がります。
AI推論コストは、モデルの価格表ではなく業務を完了させる仕組みの費用です。
- 入力と出力のトークン量
- タスクごとのモデル選択
- キャッシュの再利用率
- 再試行とフォールバックの回数
- ツール呼び出しとコンテキスト再送の量
たとえば分類や定型要約まで高性能モデルに固定すると、単価の差が全リクエストに反映されます。反対に、低コストモデルへ一律に寄せると、誤回答の確認や再実行が増えて完了コストが上がるかもしれません。

品質を守るモデル振り分け
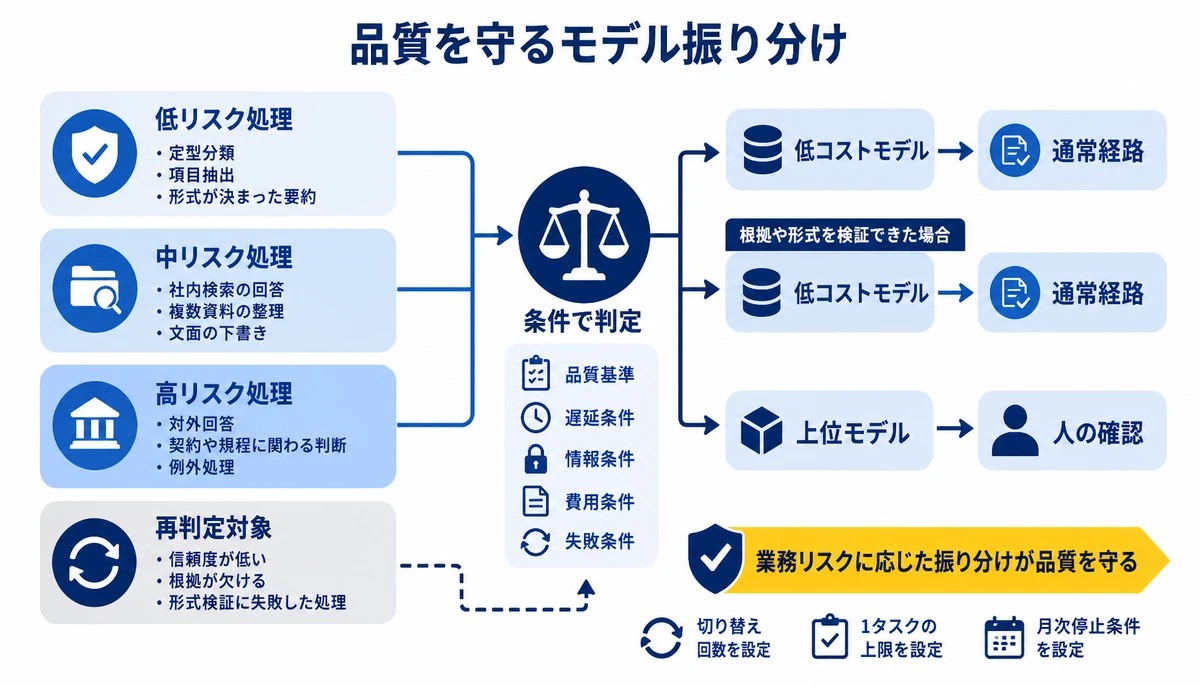
モデルルーティングは、入力内容や業務条件に応じて利用モデルを切り替える仕組みです。単価の安いモデルへ送るだけではなく、品質、遅延、情報管理、失敗時の処理を同時に判定するもの。
日本企業で導入するなら、モデル名から決めるより先に業務を分類するとよいでしょう。定型処理と判断の重い処理を同じ経路に載せないだけでも、費用と品質の検証単位が明確になります。
- 低リスク処理、定型分類、項目抽出、形式が決まった要約
- 中リスク処理、社内検索の回答、複数資料の整理、文面の下書き
- 高リスク処理、対外回答、契約や規程に関わる判断、例外処理
- 再判定対象、信頼度が低い、根拠が欠ける、形式検証に失敗した処理
低リスク処理は低コストモデルを基本経路に、高リスク処理は上位モデルや人の確認へ送るのが基本方針です。中リスク処理は、回答の根拠や形式が検証できた場合だけ通常経路で完了させる設計が考えられます。
振り分け条件には、入力文字数だけを使わないでください。業務の重要度、許容遅延、誤りの修正費用、データ保管条件を組み合わせる必要があります。
- 品質基準、正解率だけでなく根拠提示や形式遵守も確認する
- 遅延条件、即時回答と夜間処理を分ける
- 情報条件、送信可能なデータと禁止データを分ける
- 費用条件、タスクごとの上限と月次予算を設定する
- 失敗条件、再試行回数と上位モデルへの切り替え条件を定める
品質評価では、平均スコアだけを見ないことが大切です。失敗が許されない業務では、少数の重大な誤りを別指標にして、安価なモデルの採用範囲を決めます。
キャッシュと時間帯の設計
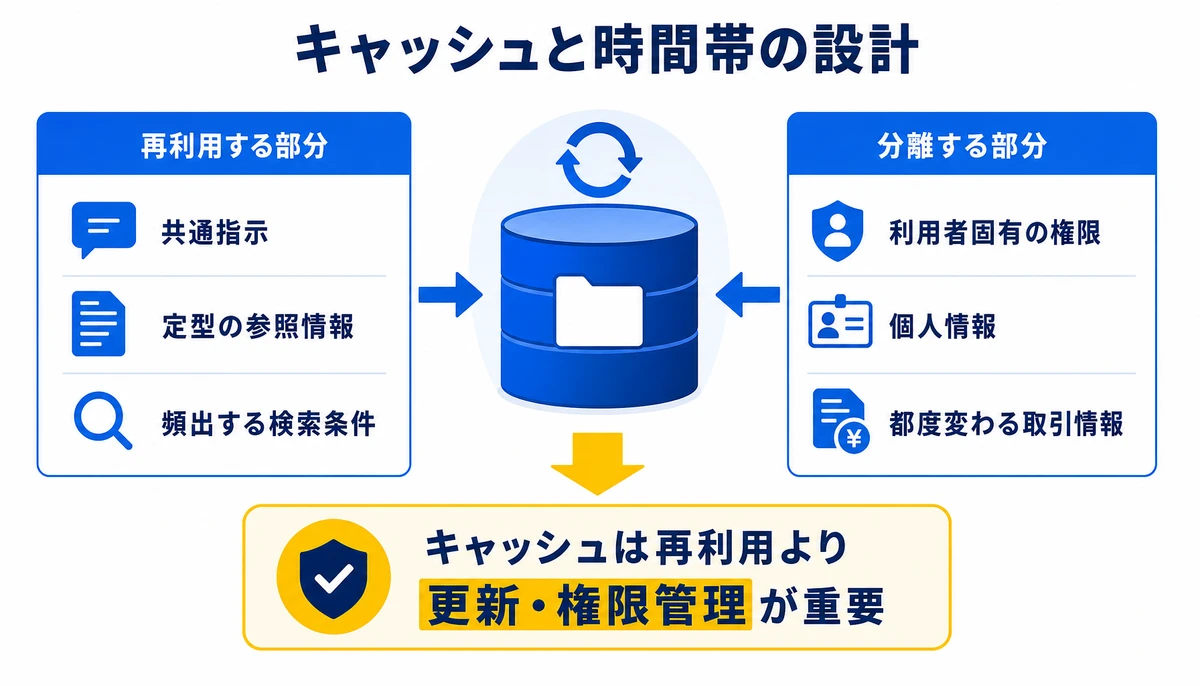
同じ指示文や共通コンテキストを何度も送る業務では、キャッシュの再利用が費用に大きく影響します。社内規程の共通部分や検索条件の固定部分を毎回生成し直していないか、まず確認するとよいでしょう。
キャッシュは保存すれば終わりではありません。内容の更新頻度、利用者ごとの権限、失効条件を決めないと、古い情報や別部署の情報が回答に混ざるおそれがあります。
- 再利用する部分、共通指示、定型の参照情報、頻出する検索条件
- 分離する部分、利用者固有の権限、個人情報、都度変わる取引情報
- 更新条件、規程改定、マスタ更新、権限変更
- 検証項目、キャッシュ利用時の回答品質、参照元、失効後の挙動
オフピーク実行は、即時性が不要な処理を混雑しにくい時間帯へ移す考え方です。日次集計、文書の事前要約、翌営業日に使う分類結果などが候補になります。
ただし、時間帯を変えるだけで費用が下がるとは限りません。利用するAPIの料金体系や契約条件に左右されるため、実際の請求と処理時間を照合して判断するのが確実です。
タスクTCOの計測と予算管理
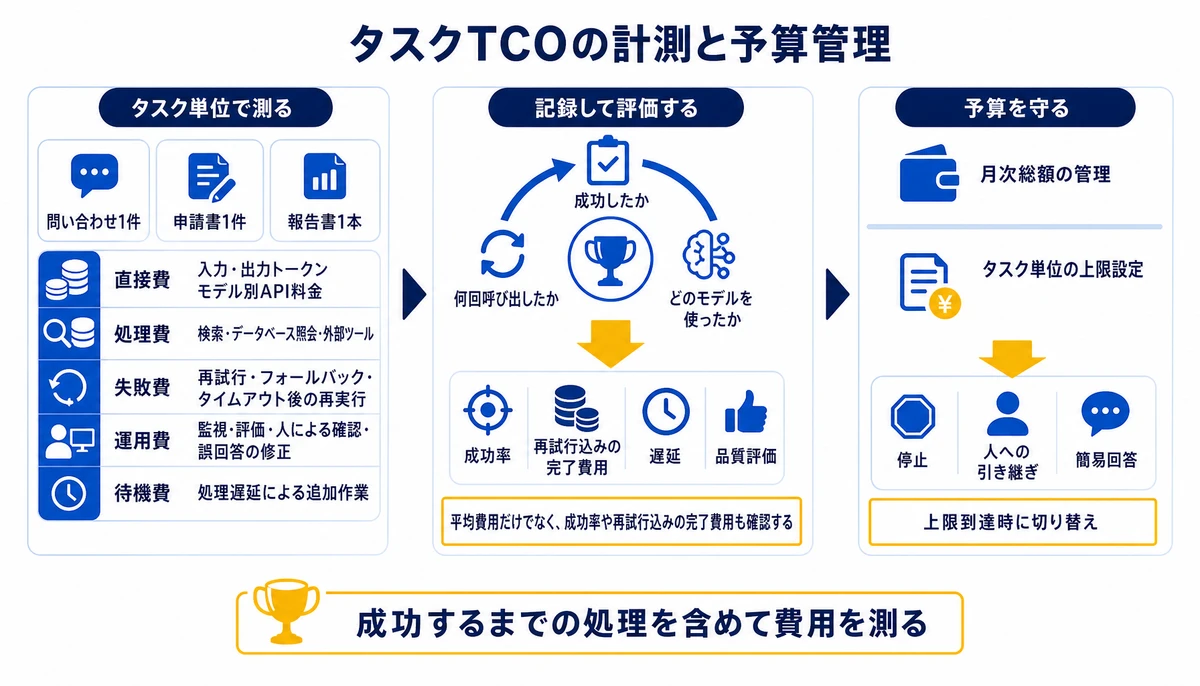
TCOはTotal Cost of Ownershipの略で、導入費だけでなく運用中に発生する総保有コストを指します。AIでは、1回の生成費ではなく、業務を成功させるまでに必要な処理を含めて測るもの。
計測単位は、リクエストよりタスクが扱いやすい場合があります。問い合わせ1件、申請書1件、報告書1本のように、利用部門が理解できる単位へそろえましょう。
- 直接費、入力・出力トークン、モデル別のAPI料金
- 処理費、検索、データベース照会、外部ツール呼び出し
- 失敗費、再試行、フォールバック、タイムアウト後の再実行
- 運用費、監視、評価、人による確認、誤回答の修正
- 待機費、処理遅延による追加作業や業務停止の影響
タスクごとに、成功したか、何回呼び出したか、どのモデルを使ったかを記録します。平均費用だけでなく、成功率や再試行込みの完了費用も並べると、安価なモデルの実力を判断できます。
- タスクIDと業務種別
- 入力・出力トークン数
- モデル名とルーティング理由
- キャッシュの利用状況
- ツール呼び出し数と再試行数
- 完了時間と品質評価
- 人による修正や承認の有無
ダッシュボードでは、モデル別の平均単価だけを大きく表示しないでください。業務種別ごとに、完了率、完了までの費用、遅延、品質評価を並べると、経路変更の影響を追えます。
予算管理では、月次総額に加えてタスク単位の上限を置くのがおすすめです。1件の処理が無限に再試行される設計を防ぎ、上限到達時には停止、人への引き継ぎ、簡易回答のどれかへ切り替えます。

設計で起きるコスト逆流と実装の判断手順
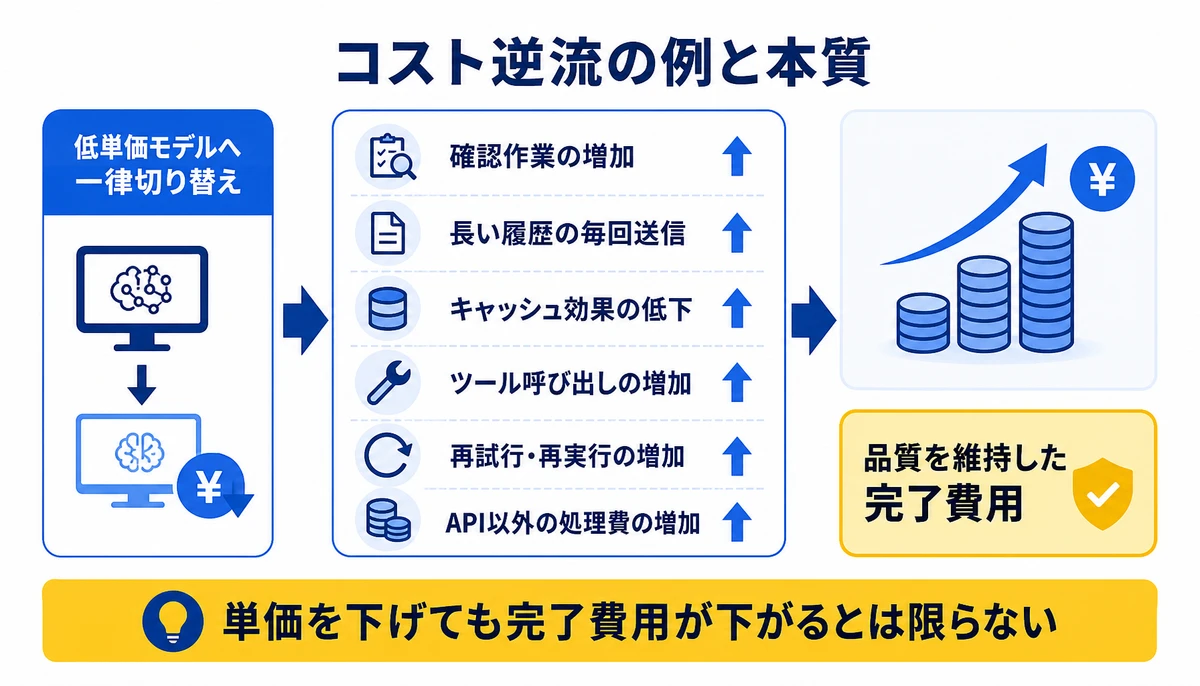
AIコスト削減では、単価を下げた後に別の費用が増えることがあります。モデルを安くしても、出力の修正や再実行が増えれば、タスクTCOは下がりません。
- 低単価モデルへ一律に切り替え、確認作業が増える
- 長い履歴を毎回送信し、キャッシュの効果を失う
- エージェントのツール呼び出しが増え、API以外の処理費が膨らむ
- 失敗時の再試行が同じ条件で繰り返される
- 複数ベンダーを増やした結果、監視と品質評価が分散する
特にAIエージェントでは、1回の回答を安くする発想だけでは不十分です。計画、検索、実行、検証の各段階で、どのモデルを使うかと停止条件を設計します。
単一ベンダーから複数モデルへ移る場合も、接続先を増やすだけでは依存が減りません。共通の評価基準と切り替え可能なインターフェースを用意し、特定モデルの出力形式に業務が固定されないようにします。
削減額ではなく、品質を維持した完了費用でモデル構成を比較します。
最初から全社のLLMを統合する必要はありません。費用が見えやすく、処理件数が安定し、品質評価を置きやすい業務から始めるのがおすすめです。
- 費用の大きい業務を、タスク単位で洗い出す
- 現在のモデル、トークン、再試行、ツール呼び出しを記録する
- 品質、遅延、情報管理、予算の許容条件を決める
- 低リスク処理で複数モデルを比較する
- フォールバックと上限を設定して段階的に本番へ広げる
比較時は、同じ入力データと同じ評価基準を使います。モデルを変えた後に品質が落ちた場合は、プロンプト、検索結果、出力形式、後処理のどこが原因かを分けて確認しましょう。
運用開始後は、モデル単価の改定や利用量の変化を前提に監視します。月次の費用レビューでは、総額だけでなく、タスク別の完了費用とフォールバック率を確認してください。
業務種別: 問い合わせ分類
品質基準: 正しい分類と必須項目の欠落なし
通常経路: 低コストモデル
昇格条件: 信頼度不足、形式エラー、禁止語の検出
上限: タスク単位の再試行回数と費用
終了条件: 上位モデルまたは担当者へ引き継ぎ自社で詰まる境界線とBinxAIの支援範囲
BinxAI株式会社では、こうした設計を特定のモデル導入だけで終わらせず、業務の要件と運用責任まで含めて整理します。提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めるのが基本方針です。
一式いくらの見積にせず、要件を整理したうえで詳細な見積を出します。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められる形を取ります。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修
自社で進める場合、最初に詰まりやすいのは費用の集計単位です。APIの請求情報と、問い合わせや申請といった業務データが別れていると、タスクTCOを作れません。
次に、品質基準の決め方で止まりやすくなります。正解率だけでなく、根拠の有無、許容遅延、再試行回数、人への引き継ぎ条件まで業務部門と合意が必要でしょう。
外部の支援を使うと、現場の業務整理、費用計測、品質基準、実装範囲を同じ計画に置きやすくなります。モデルの採用を先に決めるのではなく、診断結果から必要な構成を絞り込める点が判断材料です。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。AIコストの計測単位やモデル振り分けを、実際の業務フローに合わせて整理するのが強みです。
要件を整理したうえで詳細な見積を出し、契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進めます。開発後は運用の引き継ぎ、内製化の支援、担当者向けの研修まで対応範囲に含めます。

よくある質問
最安のモデルに統一すればAIコストは下がりますか?
必ずしも下がるとは限りません。回答の修正、人の確認、再試行が増えると、API単価を下げてもタスクの完了費用が上がる可能性があります。
モデルルーティングはどの業務から始めるべきですか?
定型分類や項目抽出のように、入力と正解の判定条件をそろえやすい業務から始めます。対外回答や契約判断は、品質基準と人の確認経路を先に定めてください。
キャッシュを使うときに確認する条件は何ですか?
再利用する情報の更新頻度、利用者の権限、失効条件を確認します。規程やマスタが更新された後に古い情報が使われない仕組みも必要です。
AIエージェント費用は何を単位に測ればよいですか?
問い合わせ1件や申請1件など、業務が完了する単位で測ります。検索、ツール呼び出し、再試行、フォールバック、人の修正まで含めて、成功1件あたりの費用を確認します。
複数のLLMを使うと管理が複雑になりませんか?
接続先を個別に増やすだけなら複雑になりやすいでしょう。共通の評価基準、ルーティング条件、ログ項目、停止条件を先にそろえると、モデル追加時の判断を標準化できます。
AI推論コストを下げる起点は、単価の安いモデルを探すことではありません。業務をタスクに分け、品質基準と予算上限を置き、モデル、キャッシュ、実行時間、再試行を一つの運用設計として管理します。
まずは費用の大きい業務を1つ選び、成功1件あたりのTCOを記録してください。その数字を基準に、モデルルーティングとフォールバックを小さく試し、品質を保てる範囲を確認してから広げます。
本記事の情報は2026年8月23日時点の内容です。料金、提供条件、モデル仕様は変更される可能性があるため、契約前に各社へ確認してください。記載した削減効果や成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

AIエージェントの分岐判断を軽量モデルへ移す方法Jevが示す推論コスト分担の設計
TypeSafe AIが発表したJevは、文章生成ではなく分類や操作選択に特化したモデルです。AIエージェントの推論コストを見直すため、公開情報の読み方、人の確認へ戻す基準、複数モデルの分担方法を解説します。
安いだけでは選べないDeepSeek V4.1 Flashの企業導入条件
DeepSeek V4.1 Flashは低価格と高速性で注目されています。V4-Proからの置き換えを検討する企業に向けて、長文処理、日本語品質、API安定性、ライセンス、自社GPUを含む評価方法と切り替え条件を整理します。

100万トークンと音声・動画対応Qwen3.8 Omni Flashを企業はどう使うか
AlibabaのQwenチームが公開したQwen3.8 Omni Flashは、テキスト・画像・音声・動画と最大100万トークンの文脈に対応します。企業が会議録や現場映像で試す際の評価項目と、API・オンプレミス運用の見極め方を整理します。