
Gemini 3.6 Flash正式リリース。出力トークン17%減がエージェント運用を変える
要約
Google DeepMindがGemini 3.6 Flashを正式公開した。出力トークン消費を前世代比17%削減し、ツール連携・多段階ワークフローの処理効率が向上している。AIエージェントの全社展開でトークンコストが予算超過の主因になっている企業にとって、導入判断に直結する変更点を整理する。
「AIエージェントをもっと広げたいが、トークンコストが読めない」。PoCを終えた企業から、この声が繰り返し聞こえてきます。
2026年8月、Google DeepMindがGemini 3.6 Flashを正式にリリースしました。
前世代のGemini 3.5 Flashから出力トークン消費を17%削減したとされています。AIエージェント運用のコスト構造に直接影響する変更です。
この記事の対象読者
- AIエージェントのPoCを終え、全社展開のコスト試算を進めている技術担当者・CTO
- LLMのランニングコストを経営判断の材料に使いたい事業責任者・情報システム部門のリーダー
- Gemini系モデルの採用を検討しており、前世代との性能・コスト比較を探しているエンジニア
Gemini 3.6 Flashに何が起きたか
後継モデルとしての位置づけ
Google DeepMindは2026年8月、後継モデルのGemini 3.6 Flashを正式公開しました。前世代はGemini 3.5 Flashにあたります。
最大の変更点は出力トークン削減
今回の変更で最も注目されるのが、出力トークン消費量の前世代比17%削減です。モデルの性能を維持しながらトークン消費を抑える設計変更は、単なる価格改定とは性質が異なります。
同時発表されたFlash-Lite
高スループット用途を主なターゲットとしたGemini 3.5 Flash-Liteも発表されました。
処理量が多いバッチ処理や高頻度API呼び出しが想定されるユースケース向けの位置づけです。主要プラットフォームでの提供が始まっています。

多段階ワークフローでトークン削減が積み重なる仕組み
見落としやすいトークンの積み重なり
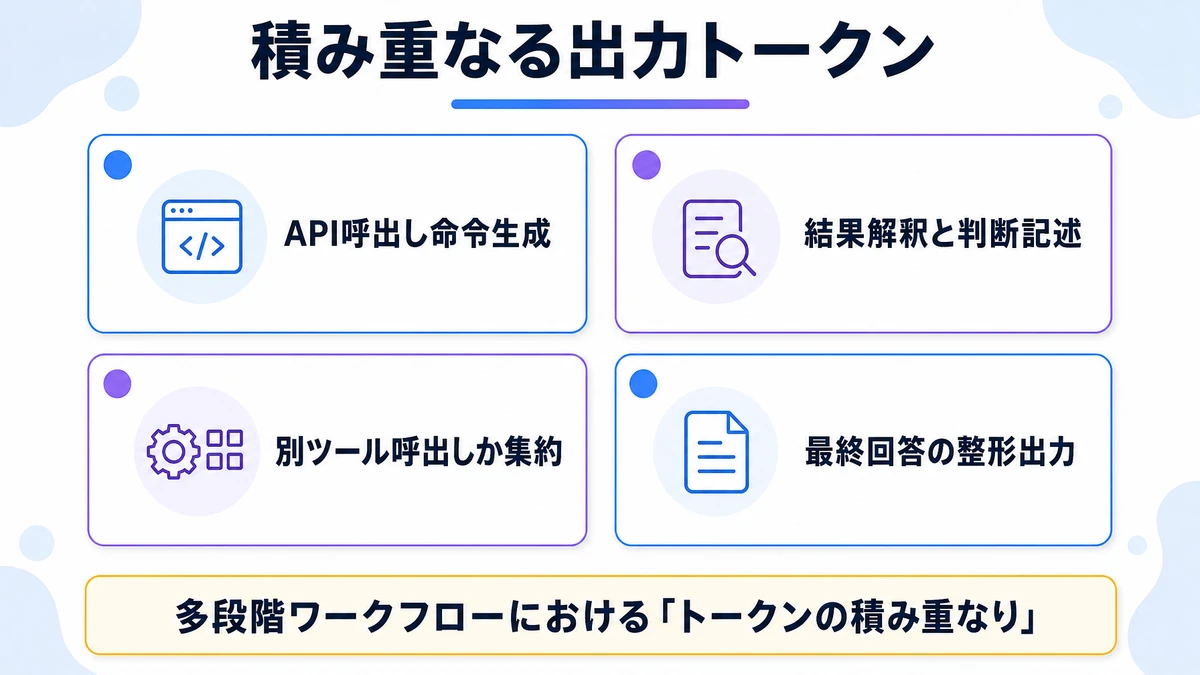
AIエージェントのコスト構造を理解するうえで見落としやすいのが、多段階ワークフローにおける「トークンの積み重なり」です。
単発の質問応答であれば、出力トークンは1回分です。
一方、エージェントは「ツール呼び出し→結果解釈→次アクション決定→ユーザーへの報告」という流れを1タスクで繰り返します。各ステップの出力トークンが積み上がる構造です。
- ステップ1:外部APIを呼び出すための命令文生成(出力トークン発生)
- ステップ2:取得した結果を解釈し、次の判断を記述(出力トークン発生)
- ステップ3:さらに別のツールを呼び出す、または結果をまとめる(出力トークン発生)
- ステップ4:最終回答をユーザー向けに整形して出力(出力トークン発生)
削減効果が積み上がる理由
このような構造では、1ステップの出力トークンを17%削減できるとします。すると4ステップのワークフロー全体では、削減効果がそのまま積み重なります。
月に数万回のエージェント実行が走る運用環境では、この差が予算に直結します。
私たちがこれまで見てきた範囲では、PoCを本番展開に進める際の壁の一つがコストでした。「スケールしたときのトークンコスト予測が立てられない」という点です。
具体的な削減率が公開されると、試算の精度が上がり、稟議を通しやすくなる面があります。
AIエージェント展開の意思決定にどう影響するか
3つの意思決定への影響
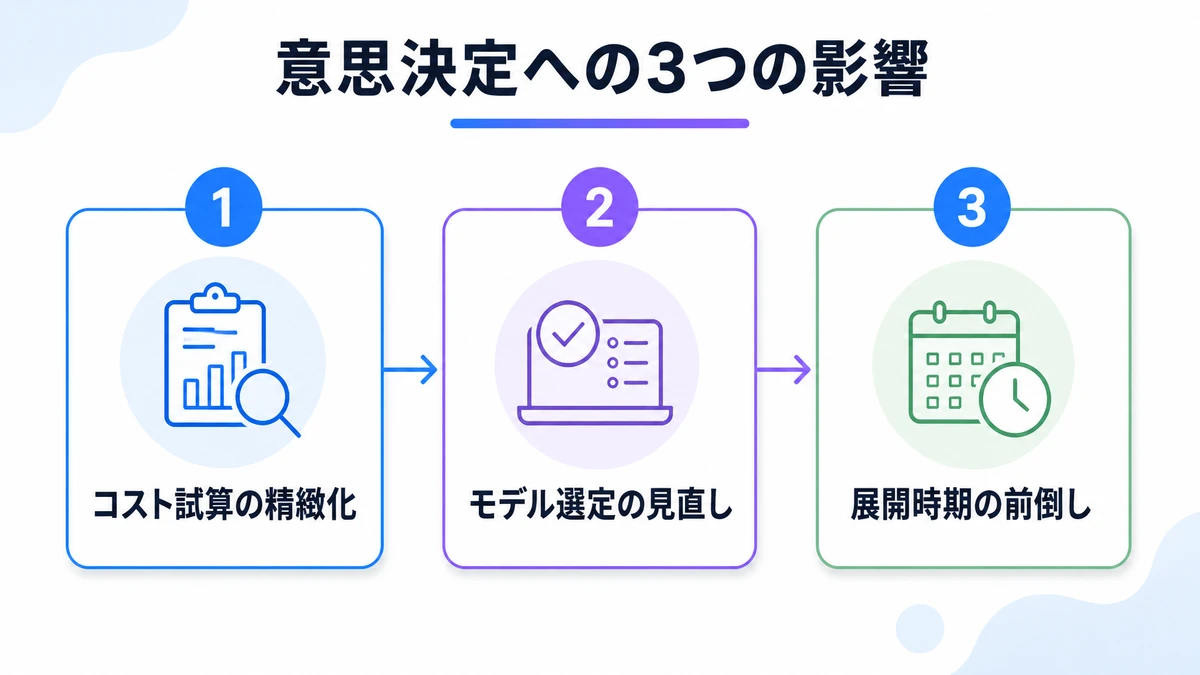
Gemini 3.6 Flashのリリースは、大きく3つの場面で意思決定に影響する可能性があります。
- コスト試算の精緻化:17%という具体的な数値を使って、現行運用からの切り替えコスト差分を試算できる
- モデル選定の見直し:同等性能でランニングコストが下がるなら、より高性能なモデルに割り振っていた予算を再配分できる
- 全社展開タイムラインの前倒し:コスト不透明性が解消されると、段階的展開から一括展開への切り替えを検討しやすくなる
17%削減を過信しないための注意点
ただし、17%削減はあくまで出力トークンの削減率です。入力トークンのコストやモデルの推論速度・精度との総合評価が欠かせません。
自社のワークフローで入力が大半を占める場合は、体感できるコスト差が小さくなる可能性があります。
よくある質問
Gemini 3.6 FlashはGemini 3.5 Flashとどう違うのですか?
Gemini 3.6 FlashはGemini 3.5 Flashの後継モデルです。
最も大きな変更点は出力トークン消費量の前世代比17%削減です。あわせてツール連携・多段階ワークフローの処理効率も向上したとされています。性能水準を維持しながらコストを下げる方向の改善が中心です。
Gemini 3.5 Flash-LiteはGemini 3.6 Flashと何が違うのですか?
Gemini 3.5 Flash-Liteは、高スループット・高頻度呼び出しに最適化されたモデルです。Gemini 3.6 Flashと同時に発表されました。
バッチ処理や大量のAPI呼び出しが発生するユースケースを主な想定としています。Gemini 3.6 Flashとは用途の棲み分けがある形です。
出力トークン17%削減は実際の請求額にどの程度影響しますか?
影響の大きさは、ワークフローにおける入力トークンと出力トークンの比率によって変わります。出力トークンが総コストの半分を占める構成なら、全体で約8〜9%の削減になる計算です。多段階エージェントでは出力が相対的に多いため、削減効果が体感しやすい傾向があります。
現在GPT-4oやClaude Sonnetを使っています。Gemini 3.6 Flashに切り替える理由はありますか?
モデルの切り替えは、コスト・精度・レイテンシ・ベンダーロックインリスクの総合評価で判断するのが妥当です。
Gemini 3.6 Flashはコスト効率の面で一定の優位性が期待できます。ただし自社タスクでの精度評価なしに切り替えを決めると、後戻りが発生しやすくなります。まずA/Bでベンチマークを取ることを検討してみてください。
日本語での利用に制約はありますか?
Gemini 3.6 FlashおよびGemini 3.5 Flash-Liteに関する日本語の公式情報は、執筆時点(2026年8月)でまだ少ない状況です。日本語タスクでの出力品質や文字数あたりのトークン消費は、英語と異なる場合があります。
実際の運用前にテストデータで確認することをお勧めします。

あわせて読みたい
AIエージェントのコスト構造を根本から見直すタイミングは、新モデルのリリース直後が最も動きやすい時期です。
第一歩として、まず現行ワークフローの直近1週間分のトークン消費ログを取り出してみてください。そこから1タスクあたりの平均出力トークン数を確認するとよいでしょう。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
GoogleがGemini 3モデル同時投入。AIの使い分けが本格化する
2026年7月、GoogleはGemini 3.6 Flash・3.5 Flash-Lite・3.5 Flash Cyberの3モデルを同時発表した。コスト削減から限定提供のセキュリティ特化まで、用途別ポートフォリオの設計思想が鮮明になった今回の発表が、AIエージェント導入企業の運用設計にどう影響するかを整理する。
全身制御ヒューマノイドの基盤モデルGemini Robotics 2が示す新局面
Google DeepMindが発表したGemini Robotics 2は、脚・胴体・腕・指先を単一ポリシーで動かすVLAモデルとして注目を集めています。この記事では発表の事実と技術的な位置づけを整理し、製造業・物流業の自動化投資判断への影響を具体的に読み解きます。
DeepMind中核2人が同時離脱。Geminiロードマップと日本企業の問い
Demis HassabisとJeff Deanという2人の中核人材が同時期にGoogleを去ったと報じられています。この経営シグナルが示すGeminiロードマップへのリスクを整理し、Google CloudやGemini APIに依存する日本企業がマルチLLM・マルチクラウド戦略をどう具体化すべきか、実務的な観点から考察します。















