GLM-5.3が更新 エージェントの性能とコストはどう変わるか
要約
Z.aiが発表したGLM-5.3は、コーディングだけでなく長時間エージェントタスクやサイバーセキュリティ分析を評価対象にしています。発表内容を整理し、日本企業が実データで性能と運用コストを検証する観点を解説します。
AIエージェントの選定では、ベンチマークの順位だけを見ても判断しにくくなっています。実務では、長いタスクを最後まで進める力と、途中で失敗したときの復旧負荷が結果を左右します。
この記事の対象読者
GLM-5.3をコーディング支援や社内エージェントの候補として調べている方に向けた記事です。API利用だけでなく、公開予定のモデルウェイトも含めて比較したい担当者を想定しています。
- コーディングAIの候補を見直している開発責任者
- AIエージェントの導入条件を整理する情シス担当者
- 海外APIと公開モデルを比較したい経営企画担当者
- セキュリティ分析への適用可能性を確認したい担当者
Z.aiが8月14日に発表したGLM-5.3の中身
発表で示された強化領域
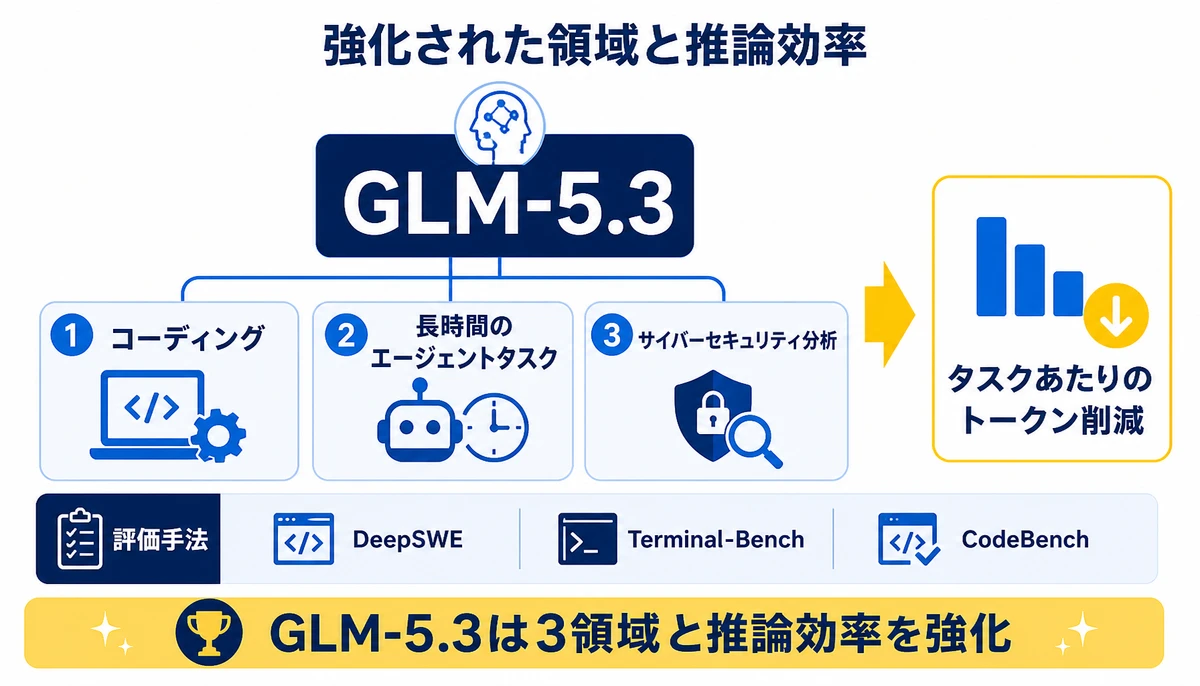
中国のAI企業Z.aiは、2026年8月14日にGLM-5.3を発表しました。Cybersecurity Newsによると、強化領域はコーディング、長時間のエージェントタスク、サイバーセキュリティ分析の3点です。
発表では、ソフトウェア開発とエージェント実行能力を主要な評価軸として扱っています。評価手法として、DeepSWE、Terminal-Bench、CodeBenchが紹介されました。
- コードの生成や修正を含むソフトウェア開発
- ターミナルを使う複数工程のエージェント実行
- 長時間タスクを継続する完遂能力
- サイバーセキュリティ分析への適用
- タスクあたりのトークン消費を抑える推論効率

GLM-5.3で性能とコストを同時に見る理由
エージェントの費用はAPI単価だけでは決まらない
海外では、AIモデルを単発の回答精度だけで比べる議論から、長時間タスクの完遂能力へ軸を広げる動きが見られます。GLM-5.3の発表も、コーディングとエージェント実行を一体で評価する流れに位置づけられます。
BinxAIが現場で見る限り、エージェントの費用はAPIの単価だけでは決まりません。連続実行時のトークン消費、失敗時の再実行、出力を確認する担当者の時間も、タスク単位で見積もる必要があるでしょう。
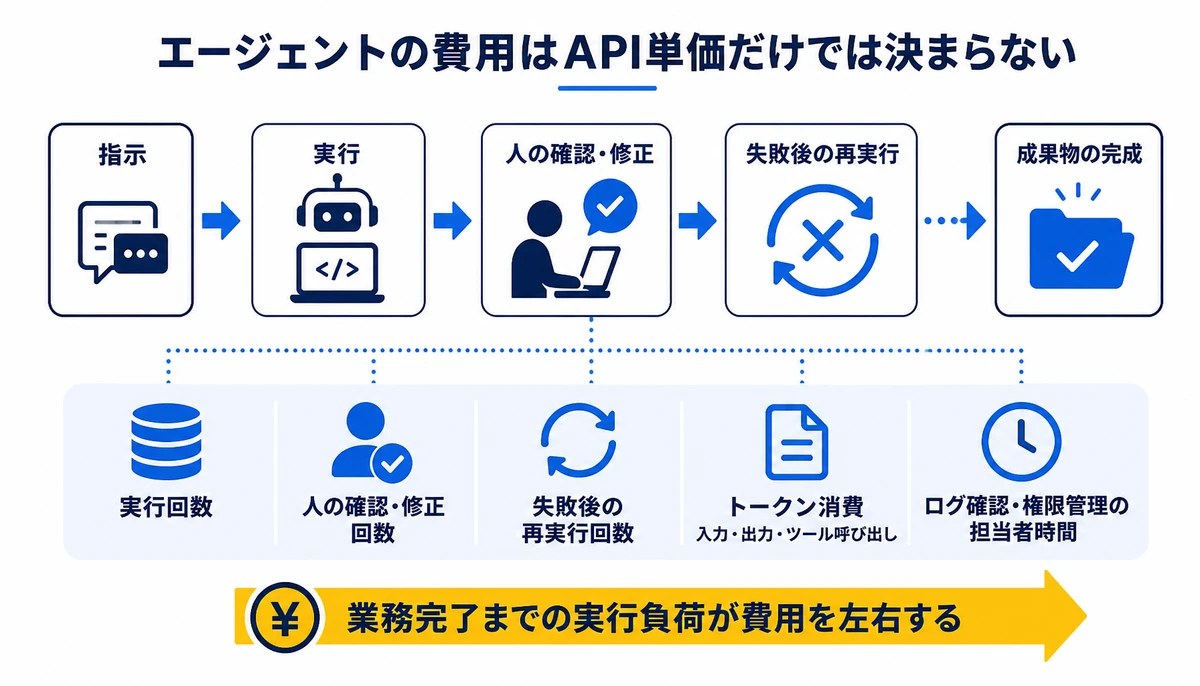
GLM-5.3を比較するなら、1回の回答ではなく1件の業務が終わるまでを測ってください。
- 最初の指示から成果物の完成までに必要な実行回数
- 途中で人が確認や修正を入れた回数
- 失敗後に同じタスクを再実行した回数
- 入力、出力、ツール呼び出しで消費したトークン
- ログ確認や権限管理にかかった担当者の時間
この測り方なら、ベンチマーク上の性能と自社の運用負荷を分けて確認できます。コーディング支援で高い結果が出ても、社内リポジトリや独自ルールで完遂できるとは限りません。
日本企業が実データで確かめるべき比較項目
検証タスクの設計と記録の残し方
公開ベンチマークは候補を絞る材料です。導入判断では、自社のコード、業務データ、権限設計を使った小さな検証に落とし込むと、モデル間の違いが見えやすくなります。
- 自社のコード規約に沿って修正できるか
- 複数ファイルや複数ツールをまたぐ作業を完遂できるか
- 誤った操作を検知して停止できるか
- 失敗した実行を再開し、原因を説明できるか
- 機密データ、ログ、モデルの利用条件が社内規程に合うか
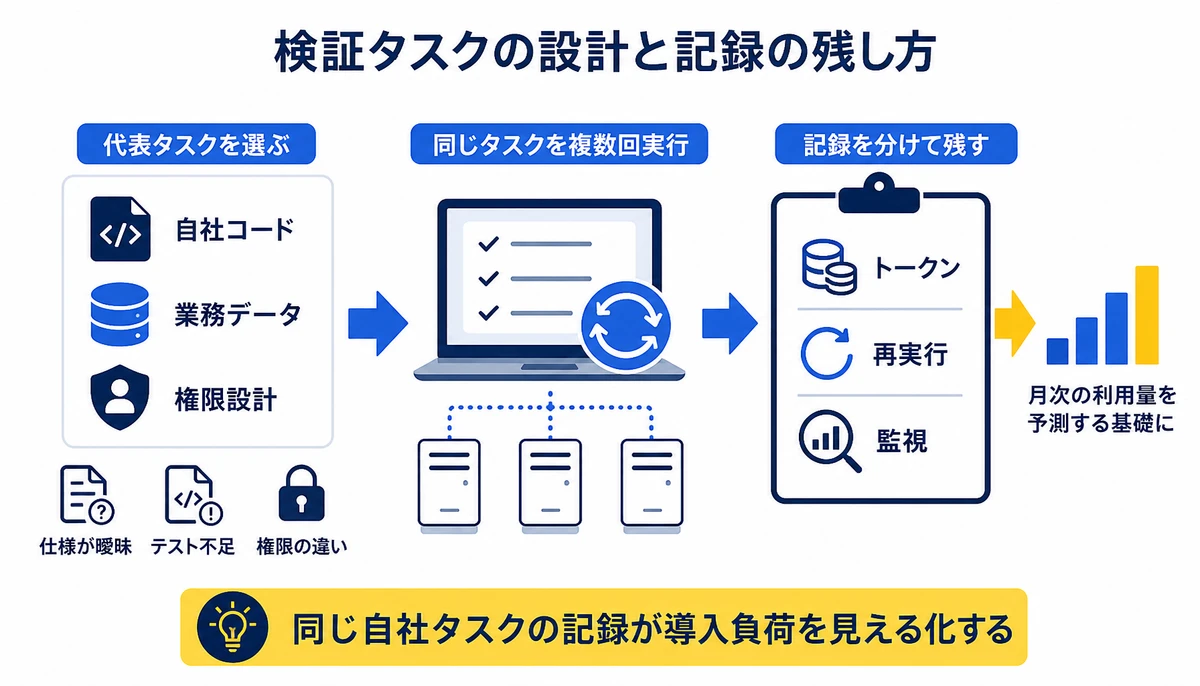
検証用タスクは、成功しやすい例だけで構成しないことがポイントです。仕様が曖昧な依頼、テストが不足したコード、権限の異なる環境を含めると、監視負荷や復旧性も確認できます。
| 比較する場面 | 確認する結果 | 記録する項目 |
|---|---|---|
| コード修正 | テストを通過する成果物 | 修正回数とレビュー時間 |
| 長時間タスク | 最終成果物までの完遂 | 実行回数と再開の可否 |
| セキュリティ分析 | 指摘の妥当性と説明 | 誤検知と確認工数 |
| 社内データ利用 | 規程に沿った処理 | 権限、ログ、保持条件 |
コストは、モデルごとの見積書だけで比べない方法もあるでしょう。まず同じタスクを複数回実行し、トークン、再実行、監視の記録を分けて残してください。その記録が、月次の利用量を予測する基礎になります。
自社検証で詰まりやすい点と外部支援の使い分け
評価設計で止まりやすい3つのポイント
GLM-5.3を自社で試す場合、モデルを動かすことより評価設計で止まるケースがあります。発表で示された評価軸を、そのまま自社業務の合否に置き換えられないためです。
- 長時間タスクの終了条件が決まっていない
- トークンと再実行の記録方法がない
- 機密データを使う検証範囲を決めにくい
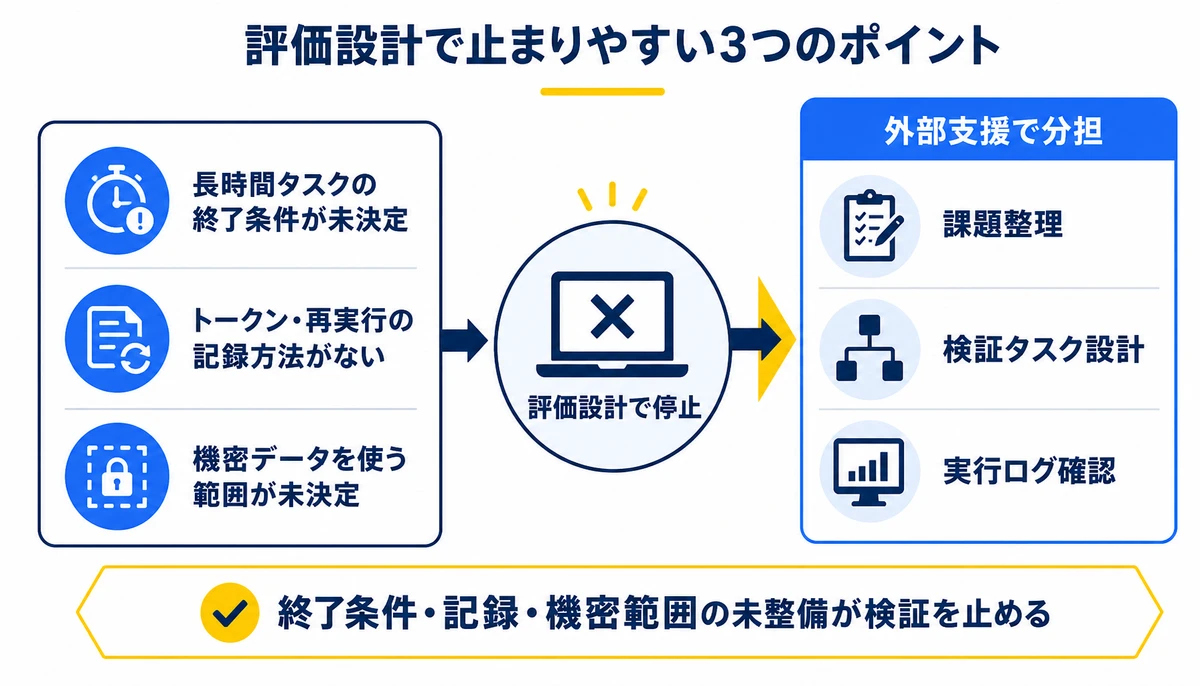
外部の支援を使うと、課題整理、検証タスクの設計、実行ログの確認を分担できます。自社の担当者は、精度だけでなく業務に残すか止めるかの判断に集中しやすくなるでしょう。
BinxAIのみっちゃくんは、AIアドバイザー、定例会、月1回60分の研修、研修資料の作成などを提供しています。期間中の相談やプロトタイプ構築も含まれており、料金は月額5万円からです。
初期費用と追加費用はなく、API・サーバー・ツールの費用は実費です。
データ基盤構築・改善、業務アプリ開発、機能開発は、上位プランで別途ご相談となります。企画や要件整理から開発、内製化と社内定着まで一気通貫で支援します。

よくある質問
GLM-5.3はいつ発表されましたか?
Z.aiは2026年8月14日にGLM-5.3を発表しました。発表内容では、コーディング、長時間のエージェントタスク、サイバーセキュリティ分析の強化が示されています。
GLM-5.3はコーディング専用のモデルですか?
コーディング専用と断定できる発表ではありません。DeepSWE、Terminal-Bench、CodeBenchを使った評価が紹介され、ソフトウェア開発とエージェント実行の両方が主要な評価軸です。
GLM-5.3でAPIコストは必ず下がりますか?
必ず下がるとは言えません。タスクあたりのトークン削減は示されていますが、料金、実行回数、監視時間、再実行の有無は自社タスクで確認する必要があります。
モデルウェイトは公開されますか?
安全性評価を経た後に公開される予定とされています。公開時期やライセンス、商用利用の条件は、正式な公開情報を確認してください。
最初の検証では何を用意すべきですか?
自社のコード修正、複数工程の業務、セキュリティ分析から代表タスクを選びます。完遂、再実行、監視、データ管理を同じ記録様式で比べると、導入後の負荷を見積もりやすくなるでしょう。
GLM-5.3の更新は、モデルの順位だけでなく、長時間タスクの完遂と推論効率を同時に比べる流れを示しています。まずは自社の代表タスクで、成果物、トークン、再実行、監視負荷を一つの表に記録するところから始めてください。
本記事は2026年8月18日時点で確認できる情報をもとにしています。モデルの公開条件、ライセンス、料金、各サービスの提供条件は契約前に各社へご確認ください。記事の内容やモデル選定による成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Cursor Origin登場 コードホスティングまで広げるAI開発基盤の確認点
Cursor Originは、AIコーディングとコードホスティングを近い導線で扱う新しい基盤です。Cursorが発表した内容を整理し、GitHub運用との関係、権限管理、監査、移行性を企業が確認する手順まで解説します。
Google Antigravity企業向けに提供開始AIエージェント駆動開発がさらに加速か
Google AntigravityがGemini EnterpriseのStandardとPlusに組み込まれ、IDE拡張や自律的な開発タスクに対応しました。企業が確認すべき権限、サンドボックス、予算管理、監査ログの考え方を整理します。

ChatGPT EnterpriseのGPT終了に備えて企業が今やること
ChatGPT EnterpriseとEduでは、9月25日から新規GPTの作成が止まり、12月11日に既存GPTの機能停止が予定されています。作成者や利用者、共有設定、連携機能を棚卸しし、移行先と運用責任を決める手順を整理します。