
GLM-5.3がClaudeやChatGPT超えのベンチマークCursorの脆弱性も確認を
要約
GLM-5.3がClaudeやChatGPTを上回ると紹介されたベンチマーク結果と、Cursorの脆弱性報告を整理します。企業がコーディングAIを導入する際に、自社コードや権限、情報流出、検証環境をどう確認すべきかを具体的に解説します。
コーディングAIの比較で、モデルの順位だけを見る判断が揺らいでいます。GLM-5.3をめぐり、ClaudeやChatGPTを上回るベンチマーク結果が紹介されました。
一方で、Cursorに関する脆弱性報告も話題になっています。2026年8月16日時点では、性能の高さと開発環境の安全性を分けて見る必要があります。
この記事の対象読者
対象は、コーディングAIの選定やセキュリティ確認を担当する方です。開発者だけでなく、情報システム部門や経営層にも関係するでしょう。
- GLM-5.3、Claude、ChatGPTの比較情報を読む方
- AIにコード生成やレビューを任せようとしている方
- Cursorなどの開発ツールを社内で使う方
- 生成AIの導入条件をセキュリティ部門と整理する方
GLM-5.3はClaudeやChatGPT超えの結果が紹介された
ベンチマーク結果の概要
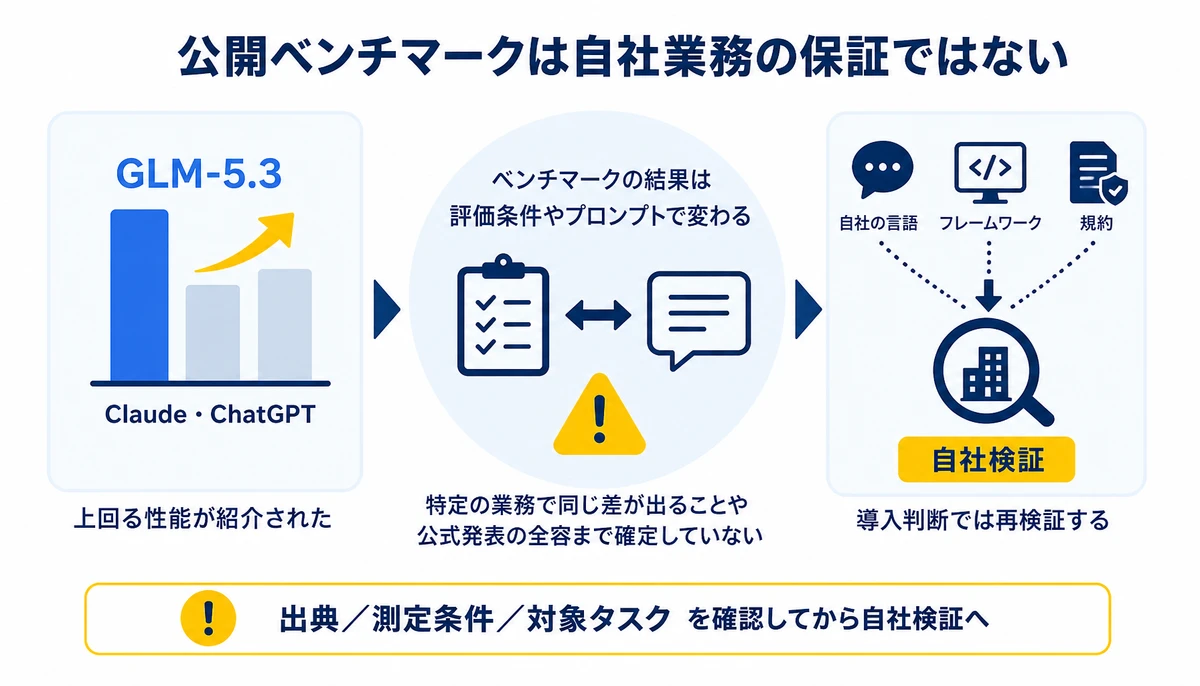
海外のAI動向を発信するX投稿では、GLM-5.3について、ClaudeやChatGPTを上回る性能を示すベンチマーク結果が紹介されています。投稿者は、モデル比較の材料として複数の評価結果を提示しています。
この情報から確認できるのは、公開ベンチマーク上で優位な結果が紹介されたことです。特定の業務で同じ差が出ることや、公式発表の全容まで確定したわけではありません。
ベンチマークを読むときの4つの確認点
- 誰が評価した結果なのかを確認する
- コード生成、修正、レビューのどの作業かを分ける
- ClaudeやChatGPTとの比較条件をそろえる
- 自社の言語、フレームワーク、規約で再検証する

コード生成の順位だけではサイバー防御を判断できない
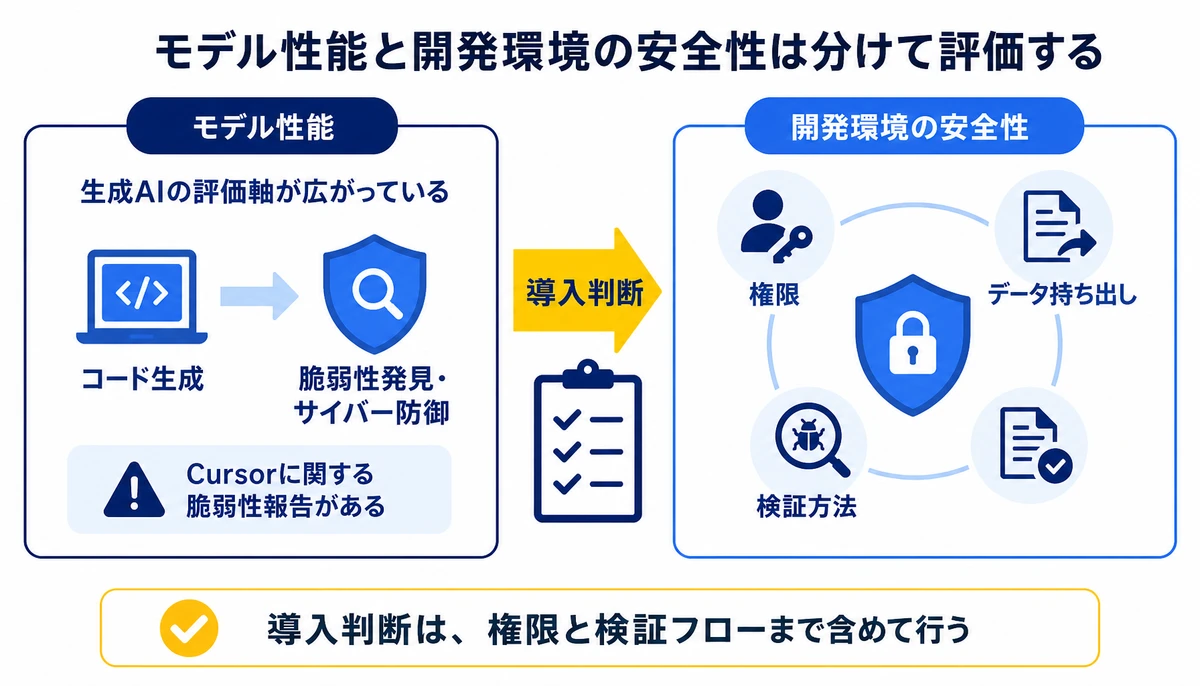
海外では、生成AIの評価軸がコード生成から脆弱性発見やサイバー防御へ広がっています。GLM-5.3のベンチマーク結果とCursorの脆弱性報告は、同じ導入判断の中で検討される論点です。
BinxAIが現場で見る限り、導入時に詰まりやすいのはモデルの順位より運用条件です。AIが作ったコードを誰が確認するのか、どの権限で実行するのかが曖昧なまま進むケースがあります。
- 生成コードに秘密情報や危険な処理が含まれていないか
- AIがリポジトリ、クラウド、チケットへ持つ権限は適切か
- 脆弱性検出の結果を静的解析やテストで確認できるか
- 入力データやソースコードが外部へ送られる条件は何か
- 商用利用や学習利用に関する許諾を確認できるか
モデルの性能比較は入口であり、実際の導入判断は権限と検証フローまで含めて行います。
自社コードで試すときに確認したい導入条件
検証の進め方
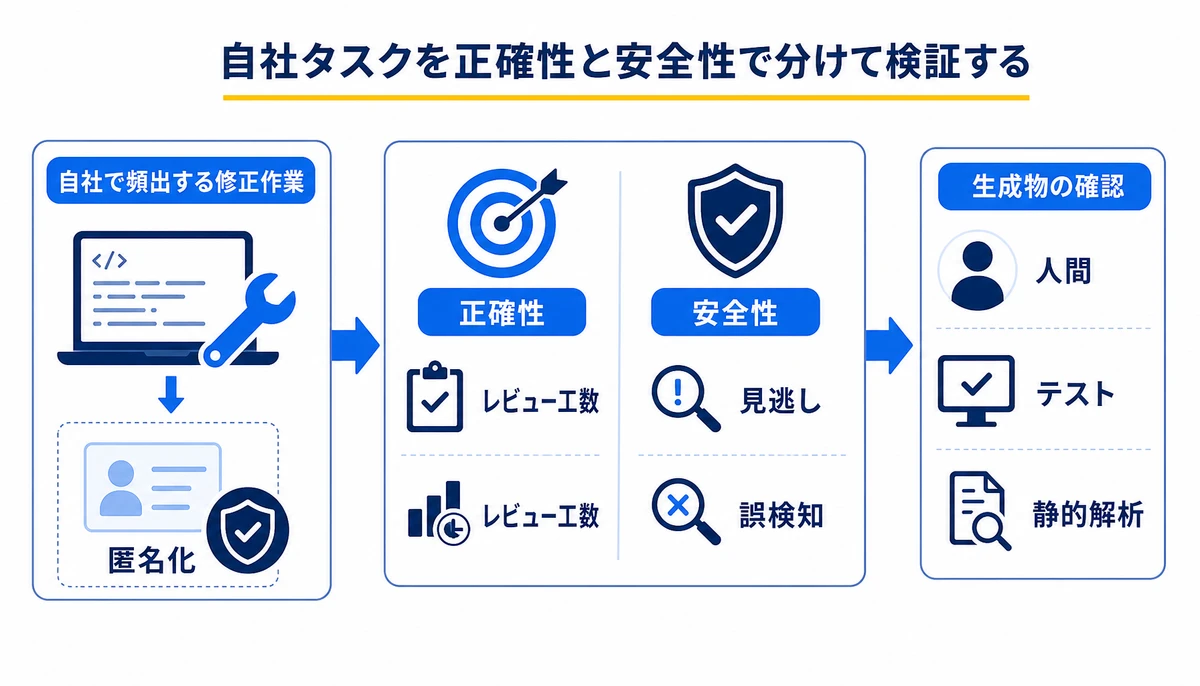
まず、公開ベンチマークと同じ順位を再現しようとしないことです。自社で頻出する修正作業を選び、正確性と安全性を別々に記録しましょう。
- 代表的なコード修正を匿名化してテストする
- テスト合格だけでなく、レビュー工数も記録する
- 脆弱性の見逃しと誤検知を別々に確認する
- AIに与える権限を読み取り中心から始める
- 生成物を人間、テスト、静的解析で確認する
小さく試す場合も、成功条件を先に決めます。たとえば、修正案の採用率、レビューでの差し戻し理由、秘密情報の入力有無を同じ様式で残すといいでしょう。
結果が良くても、運用規約が整わなければ利用範囲は広がりません。モデル選定、環境設定、社内教育を一つの計画に置くと、検証後の判断がしやすくなります。
自社だけで検証するときに詰まりやすい3つの条件
GLM-5.3のような新しいモデルを自社で試す場合、ベンチマーク結果を業務評価へ置き換える作業が必要です。特に次の条件は、開発部門だけでは決めにくいでしょう。
- 自社コードを安全に匿名化し、評価用データへ整えること
- 生成AIの権限とデータ送信条件を環境ごとに確認すること
- 脆弱性の見逃しや誤検知を、既存の審査手順へ組み込むこと
外部の支援を使うと、業務タスクの棚卸しから検証環境、社内規約、利用後の横展開までを同じ計画で整理できます。自社に残す判断と、外部へ任せる作業を切り分けやすくなります。
BinxAIの「みっちゃくん」は、月額5万円から利用できるサービスです。初期費用と追加費用はなく、API、サーバー、ツールの費用は実費となります。
業務タスクの棚卸し、データ基盤の構築・改善、業務アプリ開発、AI推進や社内規約策定、AI研修、セキュリティ対応などを支援します。

GLM-5.3とCursorをめぐるよくある質問
GLM-5.3はClaudeやChatGPTより必ず優れていますか?
必ず優れるとは判断できません。公開情報では、ClaudeやChatGPTを上回るベンチマーク結果が紹介されています。業務の言語やコード規約で再評価してください。
今回のベンチマークだけで導入を決めてよいですか?
そのまま決めるのは避けたいところです。評価条件を確認し、自社コードで正確性、脆弱性検出、誤検知、コストを分けて試します。
Cursorの脆弱性報告から何を確認すべきですか?
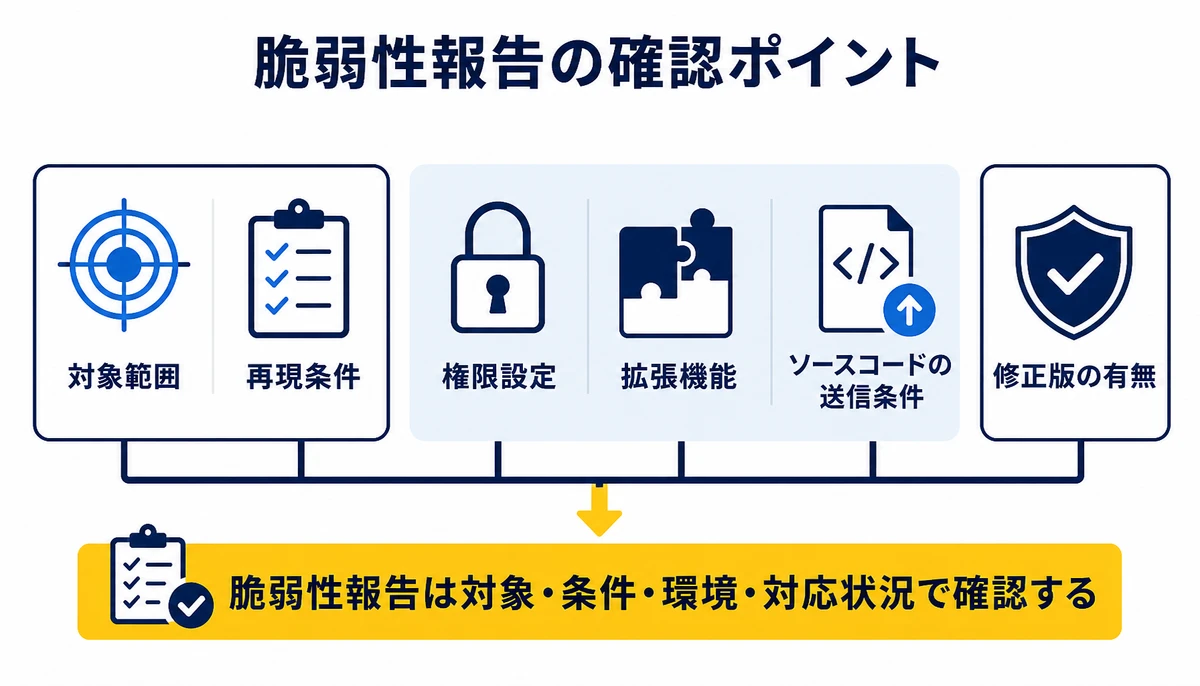
報告の対象範囲と再現条件を確認してください。そのうえで、権限設定、拡張機能、ソースコードの送信条件、修正版の有無を確認します。
AIに脆弱性検出を任せれば安全になりますか?
AIだけで安全性を保証することはできません。既存のテストや静的解析、人によるレビューを組み合わせて、見逃しと誤検知を確認しましょう。
最初の検証ではどこまで権限を与えるべきですか?
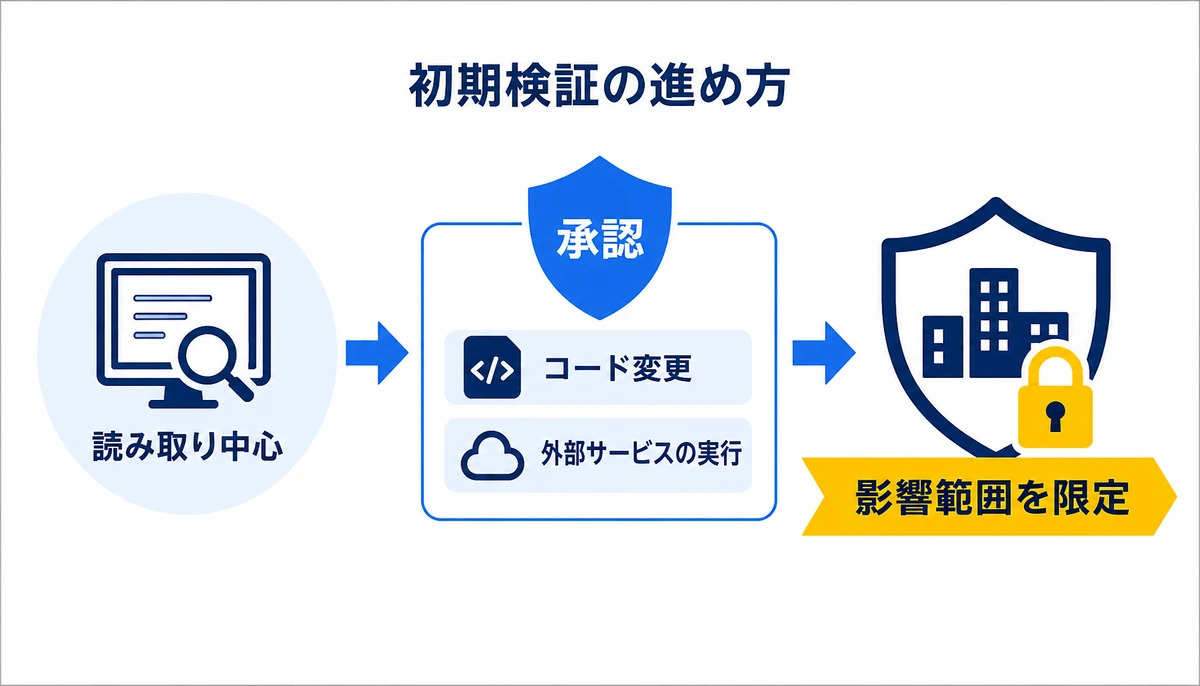
読み取り中心の権限からのスタートがおすすめです。コード変更や外部サービスの実行は、承認を挟む運用にして影響範囲を限定します。
あわせて読みたい
GLM-5.3をめぐる結果は、AIモデル比較の前提を広げる材料です。まず自社で使用頻度の高いコード修正タスクを1つ選び、GLM-5.3と既存ツールの出力を同じ様式で比較するところから始めてください。導入判断の根拠が、社内で共有しやすい形になります。
本記事の情報は2026年8月16日時点の公開情報に基づきます。各サービスの仕様、利用許諾、脆弱性対応は契約前に各社へ確認してください。記事の内容は特定の成果や安全性を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

GPT-5.6が一般提供開始。Sol・Terra・Lunaのスコアと料金を確認する
OpenAIが2026年7月9日にGPT-5.6の3モデル構成(Sol/Terra/Luna)の一般提供を開始しました。Artificial Analysisの総合指数、Coding Agent Index、100万トークンあたりの料金という公表済みの数字を並べ、どのモデルをどの業務に置くかを判断する材料を整理します。
GPT-5.6 Solプレビュー公開。OpenAIがモデル選択を企業に委ねる時代に入った
OpenAIが2026年7月29日にGPT-5.6 Solのプレビューを公開し、Sol・Terra・Lunaの3モデル構成を発表しました。単なる性能更新ではなく、企業が予算帯・用途帯に応じてモデルを選ぶ設計が求められる時代への転換点です。各モデルの位置づけと、日本企業が今押さえておくべき実装判断の論点を整理します。
Ornith-1.5公開 オープンウェイトLLMは企業で使えるか
Ornith-1.5が9B密モデルから397B MoEまでの構成と複数の量子化形式で公開されました。MITライセンスの商用利用、自社GPUでの実行、APIとの費用や運用負担の違いを整理し、企業が検証前に確認すべき項目を解説します。















