
Google Agent Development Kit登場 企業エージェント開発の新基盤
要約
Google Agent Development Kitを企業システムへ組み込むために、対応言語と構成、ワークフロー、LiteLLMによるモデル分離、権限や状態管理、失敗時の復旧、本番前の評価項目まで実装手順に沿って整理します。
この記事の対象読者
- 業務システムへAIエージェントを組み込みたい企業
- 複数モデルを使う開発チームを持つ企業
- JavaやKotlinの既存資産を活用したい企業
- AIエージェントの試作を本番へ移したい企業
- 開発基盤のベンダーロックインを避けたい企業
Google ADKで組める処理
海外では、AIエージェント開発の抽象化を進めるフレームワークが議論されています。Google Developers Blogでも、Agent Development Kitの対応言語、実行モデル、モデル接続方式は、発表とドキュメントを分けて確認する必要があります。
BinxAIが現場で見ると、SDKの選定だけで試作を本番へ移せるわけではありません。業務APIへの接続、認証情報の境界、状態の保持、失敗時の再開までを同じ構成図に置く必要があります。
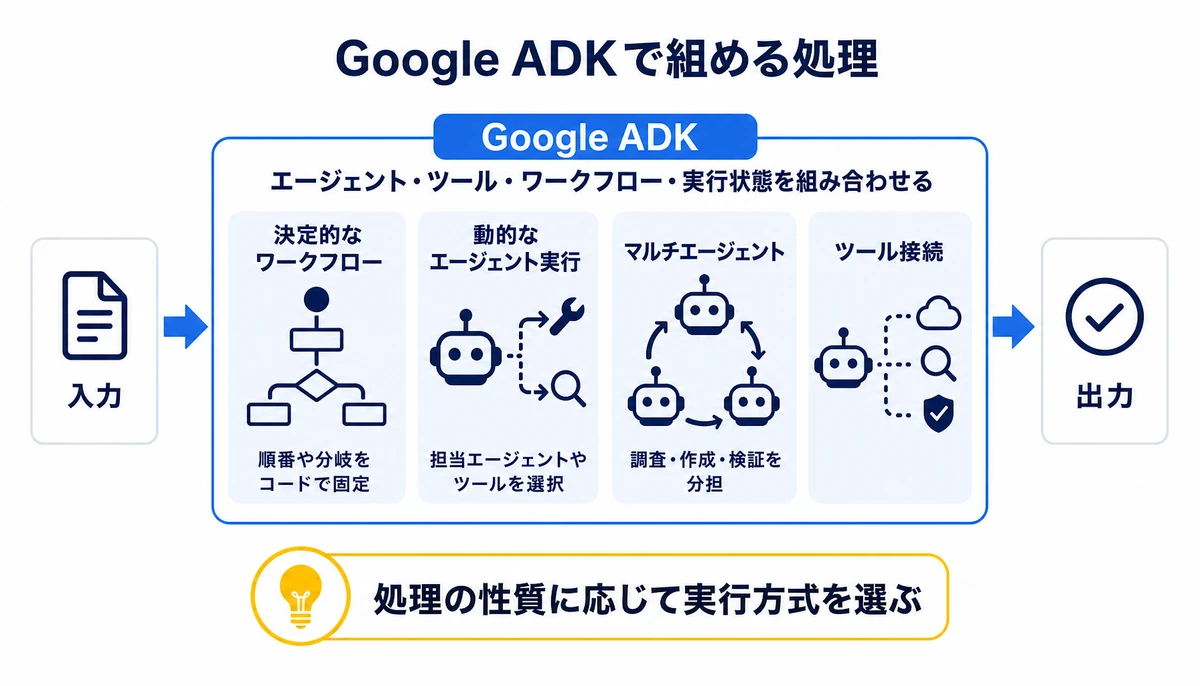
Google ADKは、エージェント、ツール、ワークフロー、実行状態を組み合わせる設計候補です。単発のプロンプトを動かす道具ではなく、処理の実行グラフを組み立てる視点で確認します。
- 決定的なワークフロー、順番や分岐をコードで固定する処理
- 動的なエージェント実行、状況に応じて担当エージェントやツールを選ぶ処理
- マルチエージェント、調査や検証などの役割を分けて連携する処理
- ツール接続、社内APIや検索、承認処理をエージェントから呼び出す処理
| 設計対象 | 向いている処理 | 最初に確認する点 |
|---|---|---|
| 決定的なワークフロー | 承認順序や定型チェック | 分岐条件と再実行位置 |
| 単一エージェント | 問い合わせ回答や情報整理 | ツール権限と出力形式 |
| マルチエージェント | 調査、作成、検証の分担 | 状態の受け渡しと重複実行 |

対応言語とセットアップ
言語版の選び方
対応言語は、Google Developers Blogの発表だけで判断しません。公式ドキュメントでPython、Java、Go、TypeScriptなどの現行サポート状況を確認し、採用するリリースのサンプルと実行方法を固定します。
既存システムとの接続方針
JavaやKotlinの業務システムを持つ場合、既存アプリへ直接埋め込む構成だけが選択肢ではありません。エージェントを別サービスとして動かし、既存システムとは認証付きAPIで接続する構成も比較するとよいでしょう。
- Google ADKの言語別ドキュメントとリリース時点を確認する
- モデルの認証情報をアプリ本体と分離し、環境変数や秘密情報管理へ置く
- 業務APIは読み取り専用のツールから始め、更新処理を後から追加する
- 実行ID、利用者ID、呼び出したツール、終了状態をログ項目にする
python -m venv .venv
source .venv/bin/activate
pip install -U google-adk litellm
export GOOGLE_API_KEY="発行したキー"
最小構成から実行する手順
単一処理から始める理由
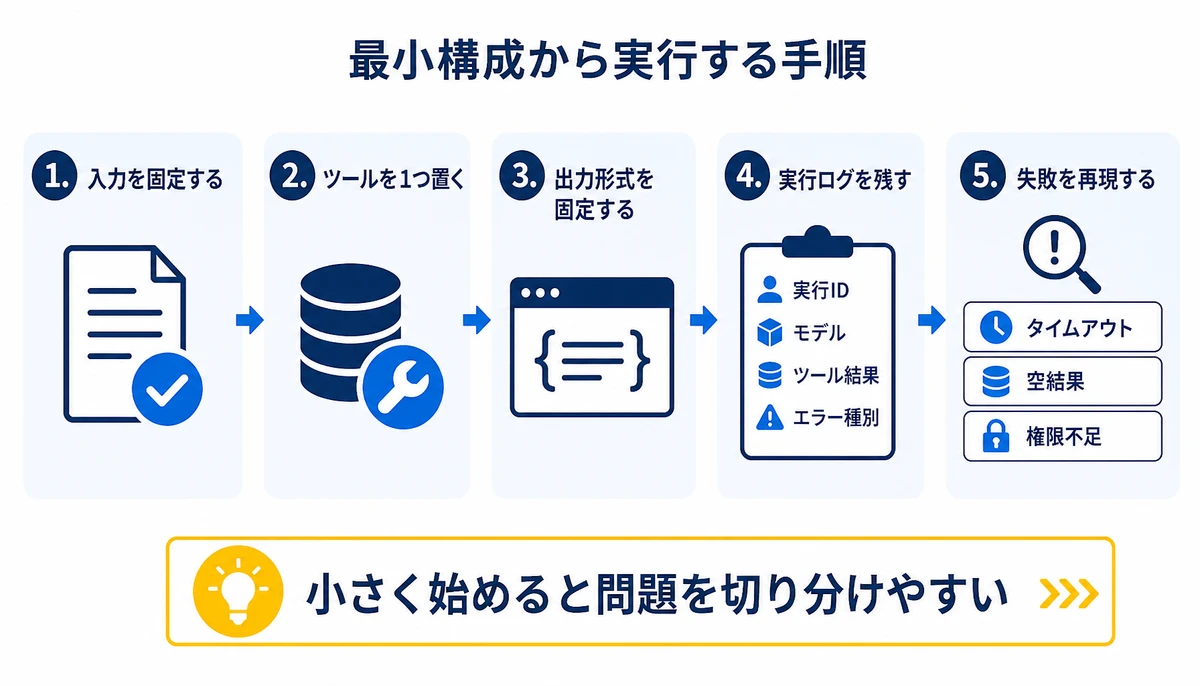
最初からマルチエージェントにすると、モデルの問題と状態管理の問題を切り分けにくくなります。読み取り専用の業務情報を1つ取得し、構造化した結果を返す処理から始めるのが出発点です。
- 1. 入力を固定する、問い合わせ文と利用者属性をテストデータにする
- 2. ツールを1つ置く、顧客情報などの読み取り専用APIだけを接続する
- 3. 出力形式を固定する、回答文と参照IDを分けて返す
- 4. 実行ログを残す、実行ID、モデル、ツール結果、エラー種別を保存する
- 5. 失敗を再現する、タイムアウト、空結果、権限不足を個別に試す
agent = Agent(
    name="customer_lookup",
    model="確認済みのモデル名",
    instruction="顧客情報を読み取り、指定の形式で返す",
    tools=[customer_lookup_tool],
)

result = run_agent(
    agent=agent,
    input_text="顧客IDの契約状況を確認してください",
    execution_id="テストごとに一意なID",
)
次に、固定的な処理と動的な処理を分けて実装します。本人確認、データ取得、形式検証はワークフローに置き、追加調査の要否だけをエージェントに判断させる構成です。
モデル分離とフォールバックの設計
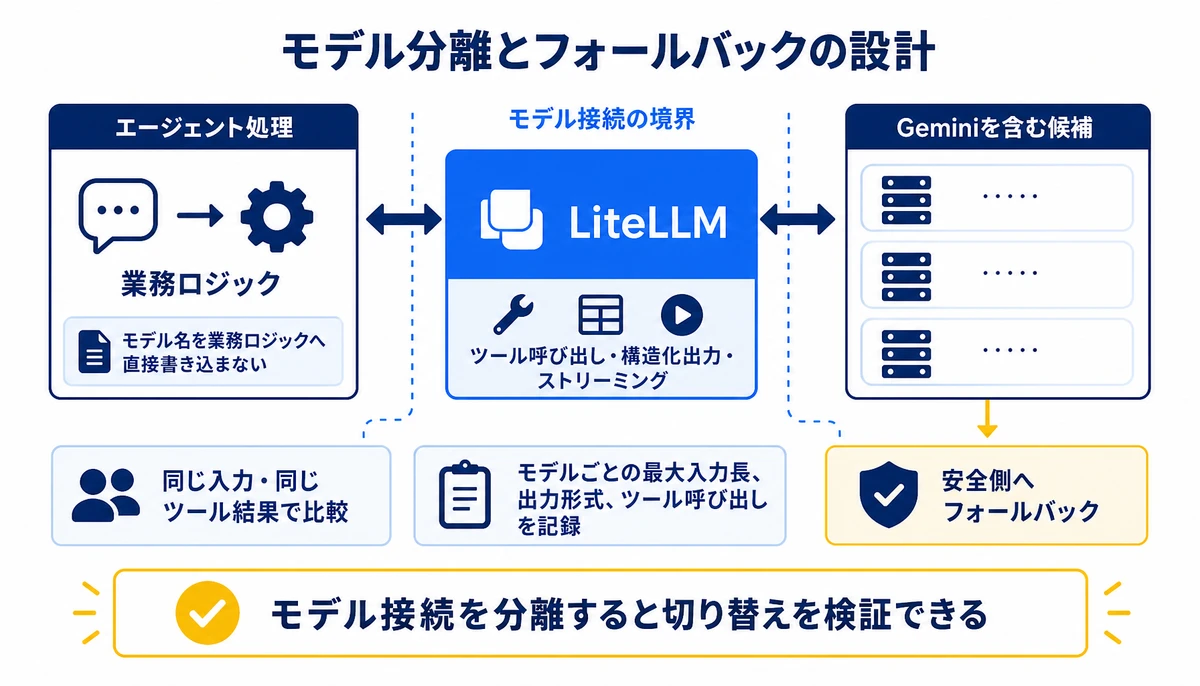
複数モデルを試す場合は、エージェントの処理とモデル接続を分離します。LiteLLMを境界に置くと、Geminiを含む候補を切り替えながら、ツール呼び出し、構造化出力、ストリーミングの差を比較できます。最後に、JavaやKotlinの既存システムとの境界を検証しましょう。
- モデル名を業務ロジックへ直接書き込まない
- モデルごとの最大入力長、出力形式、ツール呼び出しを記録する
- 同じ入力と同じツール結果でモデルを比較する
- 切り替え時に安全側へ倒すフォールバックを決める
エージェント側から直接データベースへ接続せず、既存サービスが認可済みの操作だけをAPIとして公開する形から始めると、責任範囲を分けやすくなります。
本番前に詰まる設計箇所
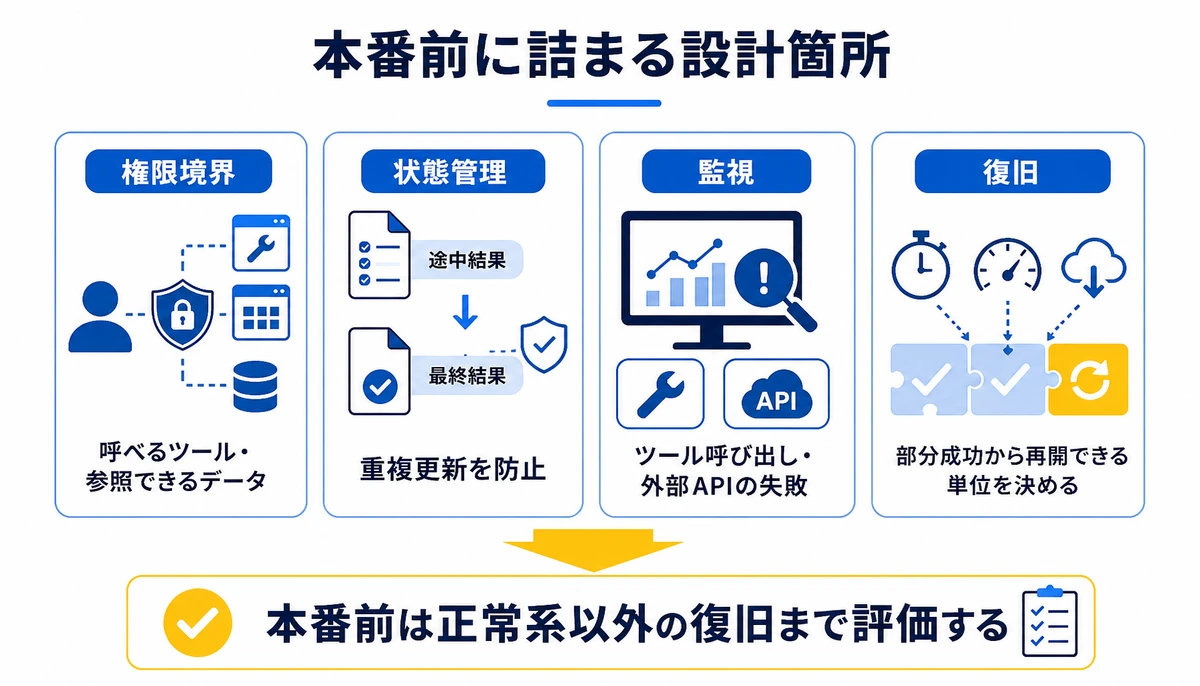
試作では通っても、本番前には権限と状態の扱いで止まりやすくなります。特に、同じ依頼の重複実行、途中で落ちた処理の再開、モデル変更後の出力差は、正常系の画面だけでは見えません。
- 権限境界、利用者ごとに呼べるツールと参照できるデータを分ける
- 状態管理、途中結果と最終結果を分け、再実行時の重複更新を防ぐ
- 監視、モデル応答だけでなくツール呼び出しと外部APIの失敗を記録する
- 復旧、タイムアウト、レート制限、部分成功から再開できる単位を決める
外部の支援を使う場合は、コードを書く作業だけでなく、対象業務の境界と評価条件を先にそろえられるかを見ます。見積の範囲に、要件整理、既存APIの確認、運用引き継ぎまで含まれるかも確認対象です。
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく詳細を示し、契約後に要件が動いても決めた範囲で優先順位を入れ替えて進めます。
企画、課題整理、要件整理から開発までを同じ担当が受け持ち、内製化と社内定着まで支援するのが特徴です。料金は公式ページと無料相談で案内し、案件ごとに対象範囲を確認します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Google ADKはGemini専用ですか?
Geminiを中心に検証できますが、他モデルを扱える接続方式も確認対象です。LiteLLMなどを使う場合も、ツール呼び出しや構造化出力が同じように動くかをモデルごとに試すのがおすすめです。
JavaやKotlinのシステムに組み込めますか?
組み込み方は、同一アプリへの導入と別サービス化を比較します。Kotlinの業務APIを既存サービスとして残し、エージェントからは認証付きの限定APIだけを呼ぶ構成も検証できるでしょう。
マルチエージェントは最初から必要ですか?
最初から分割する必要はありません。単一エージェントと読み取り専用ツールで評価し、役割分担による効果が確認できた処理だけを複数エージェントへ分けます。
本番前に何を評価すべきですか?
正答率だけでなく、権限違反、誤ったツール選択、重複実行、タイムアウト、部分失敗からの復旧を確認します。モデルを替えたときの出力差は、同じテストデータで比較するとよいでしょう。
Google ADKの対応言語はどこで確認しますか?
Google Developers Blogの発表と、対象リリースの公式ドキュメントを照合します。言語名だけでなく、ツール、状態管理、実行方法が採用予定の版で利用できるかを確認してください。
あわせて読みたい
Google ADKを試すときは、まず読み取り専用の単一処理を動かします。その後にモデル分離、ワークフロー、マルチエージェント、状態管理、復旧を順番に加えると、試作の便利さと本番運用の不足を切り分けやすくなります。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
GoogleのGemini 3.8 Flashで変わるAIエージェント設計
GoogleがGemini 3.8 FlashとGemini 3.8 Flash Cyberを発表しました。提供先や用途の違いを整理し、短期的なモデル更新に耐えるAIエージェントの設計、評価、権限管理、業務単位の比較方法を解説します。
電話対応AIの選び方が変わるGemini 3.8 Liveの実力
Google DeepMindが発表したGemini 3.8 LiveとExtended Thinkingの違いを整理します。電話対応AIの精度、遅延、有人引き継ぎ、データ保存をどう検証し、企業導入の候補を絞るかを解説します。
Claudeが1000体のエージェントを動かす 企業が先に決める上限
AnthropicのClaude Managed Agentsが最大1000体のサブエージェント連携に対応しました。動的なタスク分解と並列実行を業務へ広げる前に、実行数や推論費用、権限、失敗時の停止条件をどう設計するかを整理します。















