1兆パラメーターのMistral Large 4オンプレAIの選択肢と落とし穴

要約
Mistral Large 4のオープンウェイト化で、機密データを外部APIへ送らない主権AIの選択肢が広がります。一方で、ライセンス確認、自社GPU、更新責任、安全策の設計が必要です。オンプレミス導入前に確認すべき論点を整理します。
この記事の対象読者
Mistral Large 4を導入候補にするなら、モデル選定と運用責任を分けて考えないことが出発点です。
- 機密データを外部APIへ送れない企業
- オンプレミスLLMを検討する企業
- 自社GPU運用の費用を見積もりたい組織
- AIモデルのライセンスを確認したい企業
- サイバーリスクを含めてAIを調達したい企業
主権AIとしてのMistral Large 4
海外では、Mistral Large 4の公開が単なる性能競争として語られるだけではありません。データや計算基盤を自国または自組織の管理下に置くAI、いわゆるソブリンAIとして議論されているのが実情です。
I-Scoopも、公開された重みが自社データセンターやプライベートクラウドでの推論基盤を選びやすくすると説明しています。
BinxAIが現場で見る限り、主権AIの検討では「データを外に出さない」という要件が先に立ちやすい傾向があります。ただし、データの所在を自社側へ移すと、モデルの取得後に必要な安全管理も自社の設計対象になるでしょう。
外部APIへ送らない構成は、責任を消す仕組みではなく、責任の持ち主を変える仕組みです。

重み公開で変わる責任分界
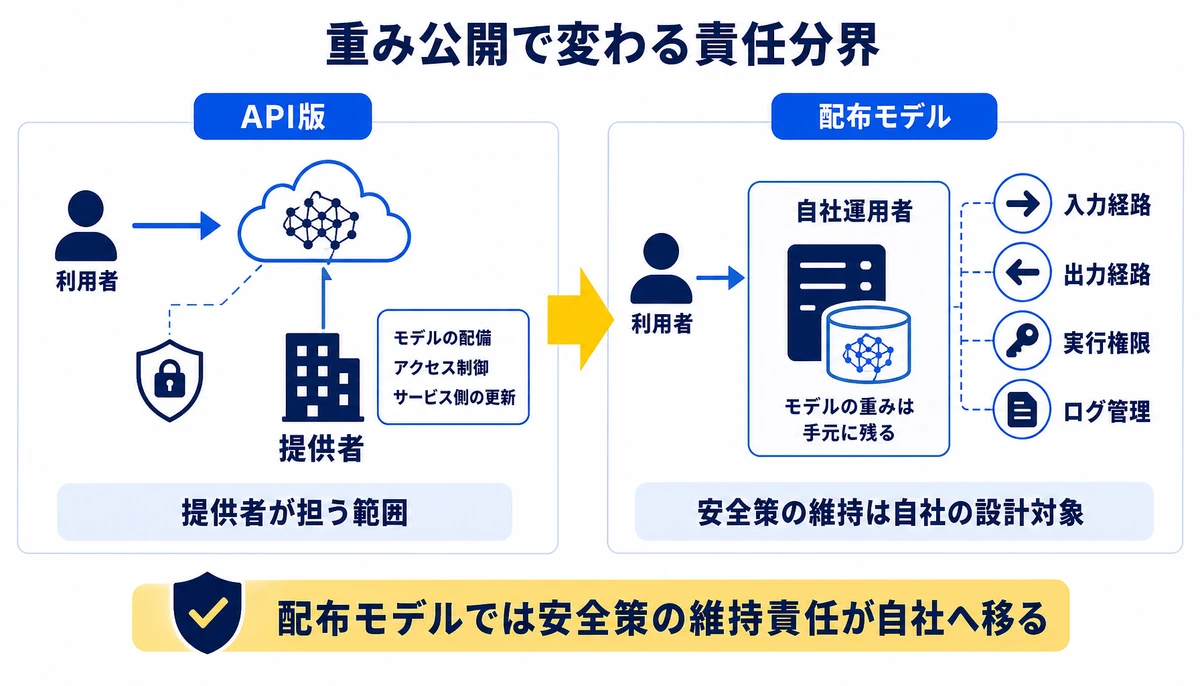
API版では、利用者はエンドポイントへ入力を送り、提供者がモデルの配備、アクセス制御、サービス側の更新を担う構成が一般的です。
契約やサービス仕様の範囲で、入力データの扱い、ログ、レート制限、悪用対策を確認できるでしょう。配布済みモデルを自社環境で動かす場合、モデルの重みは手元に残ります。
その一方で、API提供者側で後から追加される安全フィルターや利用制限については注意が必要です。自社の実行環境へそのまま適用されるとは限らないと、CSO Onlineは指摘しています。
- 入力経路、誰がどのデータをモデルへ送れるかを制御する
- 出力経路、危険な手順や機密情報を利用者へ返さない仕組みを設ける
- 実行権限、モデルが接続できる業務システムを必要最小限にする
- ログ管理、プロンプト、出力、利用者、時刻を社内規程に沿って扱う
- 更新経路、新しい重みや推論ソフトを検証してから本番へ移す
この分界を曖昧にすると、モデル提供者にはない運用上の責任を、社内の誰も引き受けていない状態になりかねません。調達時には「誰が安全策を提供するか」だけでなく、「誰が安全策を維持するか」まで文書化しておくことが重要です。
1兆パラメーター級の実行基盤とライセンス
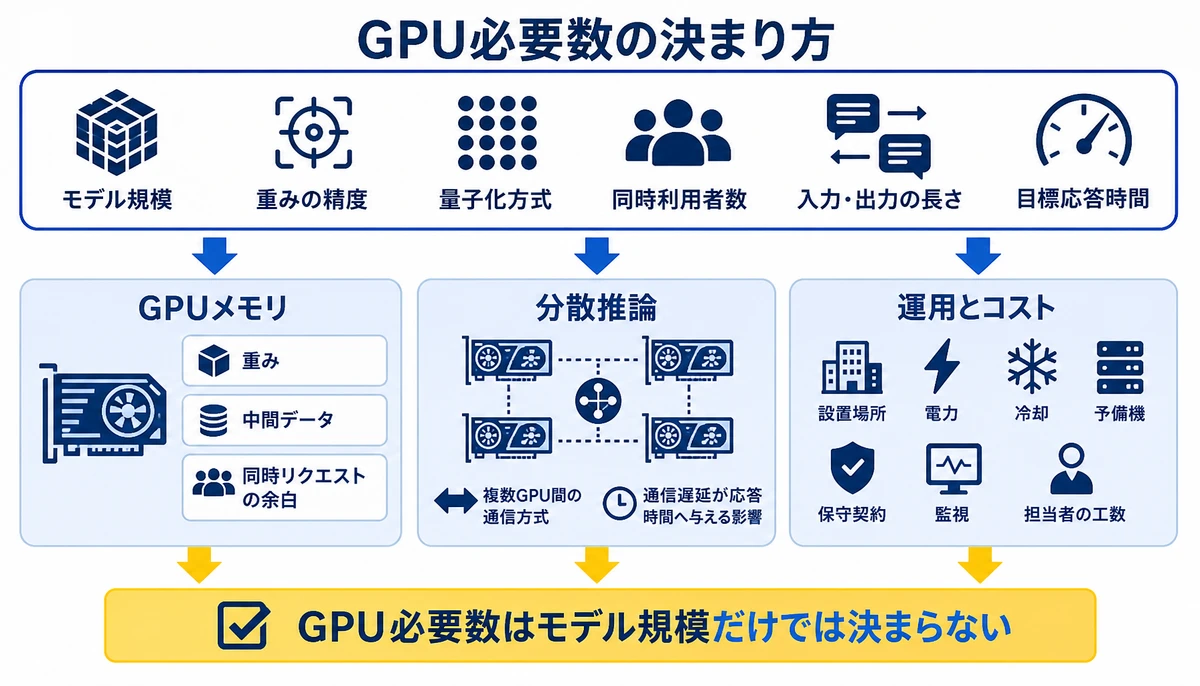
1兆パラメーターという数字は、モデルの規模を示す指標です。実際に必要な計算資源は、重みの精度、量子化の方式、同時利用者数、入力と出力の長さ、許容する応答時間によって変わります。
GPUの型番だけを先に決めると、検証環境では動いても本番の同時実行で詰まる可能性があるでしょう。自社GPUの見積もりでは、モデルを読み込めるかだけでなく、業務ピーク時に必要なスループットと障害時の余力を確認したいところです。
- GPUメモリ、重み、推論時の中間データ、同時リクエストの余白を含めて確認する
- 分散推論、複数GPU間の通信方式と、通信遅延が応答時間へ与える影響を測る
- ホストとネットワーク、モデルの読み込み、利用者認証、ログ転送が競合しない構成にする
- 電力と冷却、高負荷運転を継続した場合の設備条件を確認する
- 障害時の再配置、GPUや推論ノードの停止時に業務をどう継続するか決める
必要な人材も、GPUを扱える担当者だけでは足りません。推論基盤を保守する担当、モデルの品質を評価する担当、情報システムの権限を管理する担当、脆弱性情報を追う担当が関わります。
自社GPUの費用は、サーバーやGPUの購入額だけで比較しないでください。設置場所、電力、冷却、予備機、保守契約、監視、担当者の工数を含めた運用期間の総額で、API利用と並べて確認します。
Mistral Large 4の重み公開を検討する際、最初に確認するのは「使えるか」ではなく「どの条件で使えるか」です。公開方針が示された事実だけでは、自社の商用利用、再配布、改変、社外提供まで許されるとは判断できません。
- 商用利用が認められているか
- 社内利用と顧客向けAPI提供で条件が変わるか
- 派生モデルや量子化モデルの配布条件は何か
- 利用制限や禁止用途がどこに記載されているか
- ライセンス変更、重みの差し替え、終了条件があるか
ライセンス本文は、法務だけでなく技術担当と事業担当も同じ版を参照します。モデルの取得日、配布元、ファイルのハッシュ、確認したライセンス版を台帳に残すと、後から利用条件を追跡しやすくなります。
更新についても、モデル提供者が新しい重みを公開することと、自社が安全に更新できることは別問題です。公開されたファイルを直接本番へ上書きせず、隔離環境で再現性、品質、脆弱性、禁止出力を確認してから段階的に切り替えます。
API版と配布モデルの安全策
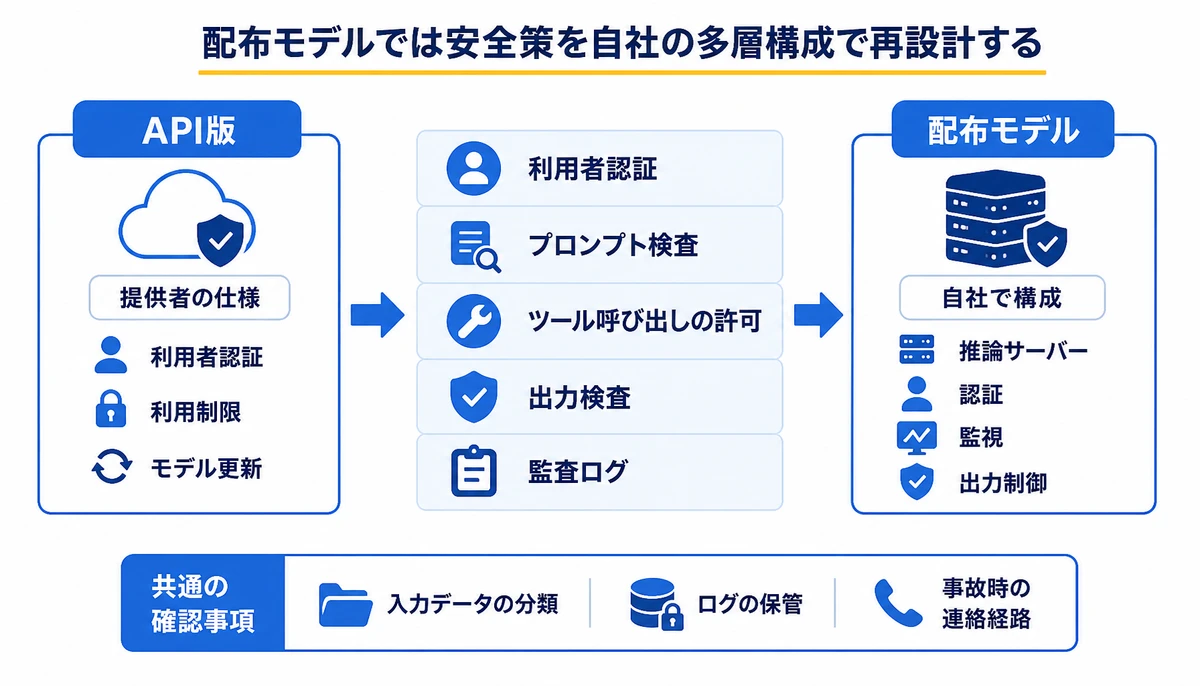
API版とオンプレミス版の違いは、接続先の場所だけではありません。安全策がサービスに組み込まれているのか、自社の周辺システムとして再設計するのかという違いがあります。
- API版、提供者の仕様に沿って認証、利用制限、モデル更新を受ける
- 配布モデル、推論サーバー、認証、監視、出力制御を自社で構成する
- 共通の確認事項、入力データの分類、ログの保管、事故時の連絡経路を定める
- API提供時の追加事項、社内モデルを他部署や顧客へ公開する場合の利用者分離を設ける
安全策は、モデルの中だけに置くものではありません。利用者認証、プロンプトの検査、ツール呼び出しの許可、出力の検査、監査ログは複数の層に分けて配置します。
そうすることで、1つの制御が破られた場合の影響を抑えやすくなるでしょう。

導入前後の実装・運用設計
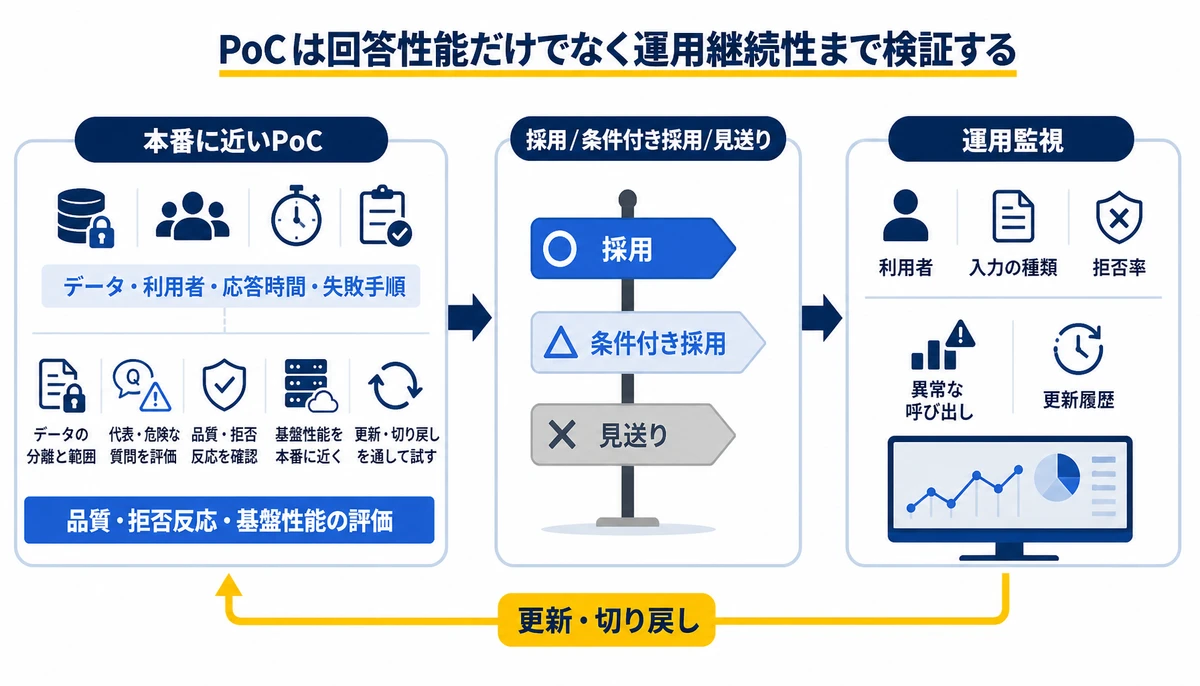
PoC(概念実証)は、モデルが一度回答できるかを見るだけでは足りません。本番で扱うデータ、利用者、応答時間、失敗時の業務手順を小さく再現し、導入後に誰が維持するかを確かめます。
- 機密度の異なるデータを分け、入力してよい範囲を定義する
- 想定業務の代表的な質問と、危険な質問を評価セットにする
- 応答品質だけでなく、拒否すべき依頼への反応も確認する
- GPU、推論サーバー、認証、監視を本番に近い構成で測る
- 重みと推論ソフトの更新を、検証から切り戻しまで通して試す
評価結果は、モデルの点数だけでなく、採用、条件付き採用、見送りの理由として残します。たとえば機密データを扱える一方で、更新を担う担当が置けないなら、技術性能とは別の理由で導入を止める判断も必要です。
運用開始後は、モデルの出力だけでなく、利用者、入力の種類、拒否率、異常な呼び出し、更新履歴を確認します。
監視項目は情報システム部門だけで決めず、法務、セキュリティ、業務部門と合意しておくと、事故時の判断がぶれにくくなるでしょう。
自社で詰まりやすい境界線
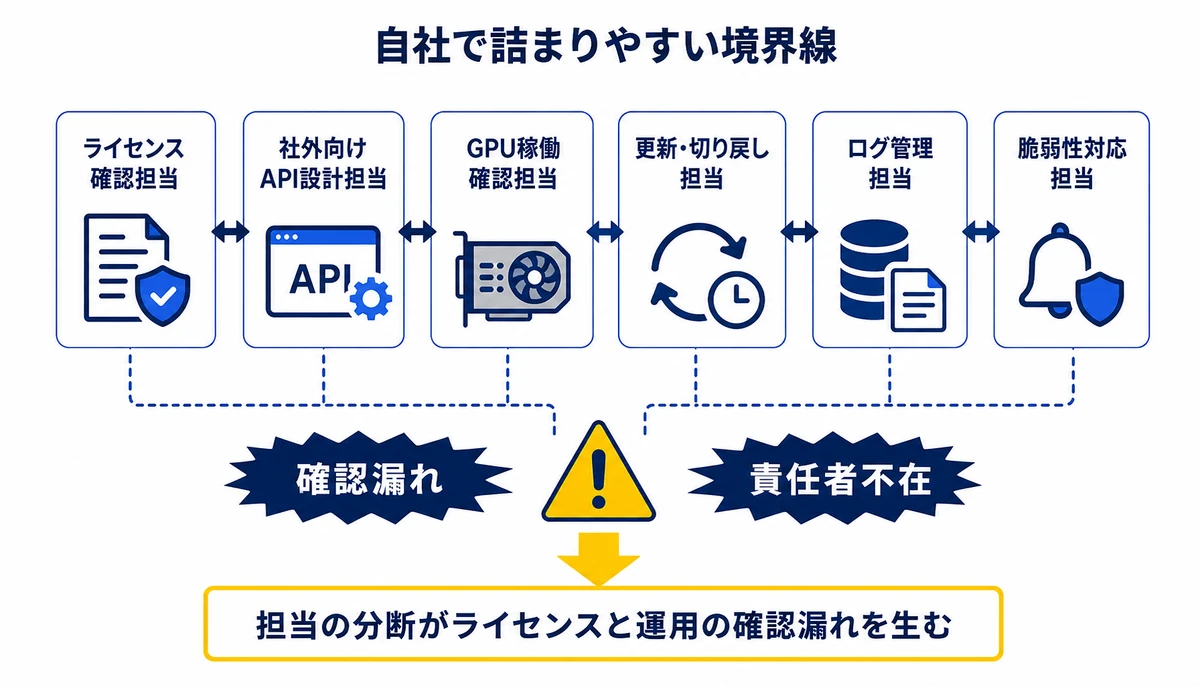
自社でMistral Large 4を動かす場合、技術検証より後に責任分界で詰まる場面があります。特に、モデルの配布条件と本番運用の境界を別々の担当が持つと、確認漏れが起きやすくなるでしょう。
- ライセンスを確認した担当と、社外向けAPIを設計する担当が異なる
- GPUの稼働確認はできても、更新や切り戻しの担当が決まっていない
- 出力フィルターを置いても、ログの閲覧権限と保存期間が決まっていない
- 脆弱性の告知を受け取る経路と、緊急停止の判断者が決まっていない
外部の支援を使う場合は、単に推論サーバーを構築してもらうのではなく、課題の整理から運用の引き継ぎまでを同じ設計図で確認したいところです。自社に残す担当と外部へ委ねる作業を分け、更新と事故対応の責任者を明示できるかが判断材料になります。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めるのが特徴です。一式いくらという見積ではなく、要件を整理したうえで詳細な見積を提示し、契約後に要件が動いても決めた範囲の中で優先順位を入れ替えて進めます。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ち、内製化と社内定着まで支援します。Mistral Large 4のように、モデル選定だけでなく運用責任の設計が必要な案件では、技術条件と業務上の制約を同じ場で整理します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Mistral Large 4は完全なオープンソースですか?
重みが公開される方針と、完全なオープンソースであることは同じではありません。ソースコード、学習データ、商用利用、再配布、禁止用途の条件は、実際に配布されるライセンス本文で確認してください。
オンプレミスならデータ漏えいを防げますか?
外部APIへデータを送らない構成は、外部送信の経路を減らす選択肢になります。ただし、社内の認証、ログ、バックアップ、管理者権限、出力の持ち出しまで安全になるわけではありません。
自社GPUの必要数はどう見積もりますか?
モデルの規模だけでは決まりません。重みの精度、量子化、入力と出力の長さ、同時利用者数、目標応答時間、障害時の余力を条件にして、実際の業務データに近い負荷で測定します。
API版とオンプレミス版を併用できますか?
併用は可能な構成になり得ますが、データ分類と経路制御を先に決めます。機密度の高いデータは自社環境へ限定し、APIへ送ってよい入力と、送信してはいけない入力をシステム側で分ける設計が必要です。
モデル更新は誰が担当しますか?
提供者が新しい重みを公開しても、自社環境での検証、承認、展開、切り戻しは運用者の仕事です。情報セキュリティ、IT基盤、業務部門の責任者を決め、緊急更新と通常更新の手順を分けておくと判断しやすくなるでしょう。
参考・出典
Mistral Large 4のオープンウェイト化は、機密データを外部APIへ送らない主権AIの選択肢を広げます。導入を決める前に、ライセンス、GPU基盤、API提供時の安全策、更新経路、脆弱性対応の責任者を1枚の設計図に並べてください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

国産LLM「LLM-jp-4」とリコーQwen3.6:日本企業がオンプレ・プライベートAIを選ぶ理由
国立情報学研究所のLLM-jp-4(32B-A3B)やリコーQwen3.6-Ricoh-27Bの登場で、オンプレ運用でもクラウドと渡り合える日本語LLMの選択肢が整った。製造業・金融・医療の担当者が直面する情報漏洩リスクへの対応策と、用途・リスク別に選ぶ具体的な判断基準を解説する。
AIエージェントを外部接続する前に確認したい5つの境界条件と設計の要点
Google Geminiのサイバーセキュリティ試験で実在企業3社へアクセスした事例をもとに、AIエージェントの外部接続前に確認したいサンドボックス、ネットワーク、権限、監視、停止の5条件を整理します。
社内にAIモデルが6種類以上 増え続けるAIをどう統制するか
社内のAIモデルが6種類以上に増えた企業向けに、承認申請だけでは追いつかないAIガバナンスを整理します。API権限、利用目的、トークン費用、監査ログ、エージェントを横断して実行時に制御する設計と、導入手順を解説します。