
RAGの正解率が高くても危ない 再現率0.481が示す本番の盲点
要約
RAGの回答が正しそうに見えても、検索段階で必要な条項や根拠を落とすと業務判断を誤るおそれがあります。適合率0.844と再現率0.481の差を起点に、長文文書の評価方法、検索設計、運用基準の作り方を整理します。
この記事の対象読者
RAGの評価結果を見ながら、社内文書検索を本番へ進める技術担当者や管理者を想定しています。特に、回答の正しさだけでは検索品質を判断しにくい組織に向けた内容です。
- 社内文書検索へRAGを導入したい企業や組織
- RAGの回答品質を評価できていない企業や組織
- 契約書や規程をAIで検索したい企業や組織
- 本番RAGの誤回答や検索漏れを減らしたい企業や組織
- AIシステムの品質基準を作りたい企業や組織
適合率0.844と再現率0.481の差
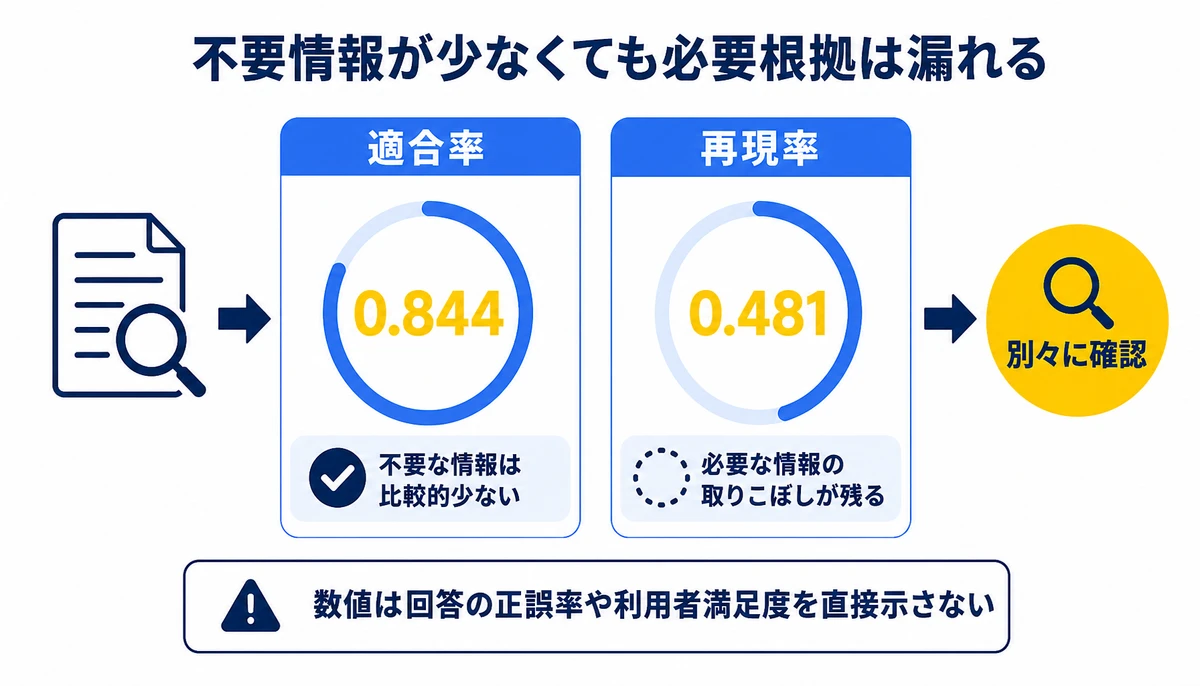
海外では、本番環境のRAGを回答品質だけでなく、検索品質から評価する議論が進んでいます。公開された本番RAGの評価事例では、検索結果の適合率が0.844、再現率が0.481でした。
ここでいう適合率は、検索された情報のうち質問に必要だった情報の割合です。再現率は、質問に必要な情報のうち、検索結果へ回収できた情報の割合を指します。
| 指標 | 測る対象 | 今回の数値 | 読み取れる状態 |
|---|---|---|---|
| 適合率 | 検索結果に含まれる情報の適合度 | 0.844 | 不要な情報は比較的少ない |
| 再現率 | 必要な情報を回収できた割合 | 0.481 | 必要な情報の取りこぼしが残る |
| 回答の正しさ | 生成された回答の内容 | 単独では判断不可 | 検索漏れを見落とす可能性がある |
適合率が高い検索は、回答生成に使いやすい情報を返しているように見えます。しかし再現率が低ければ、検索結果に必要な根拠が足りません。
「余計な情報が少ない」と「必要な情報が揃っている」は、別々に確認する必要があります。

検索漏れが業務判断を変える場面
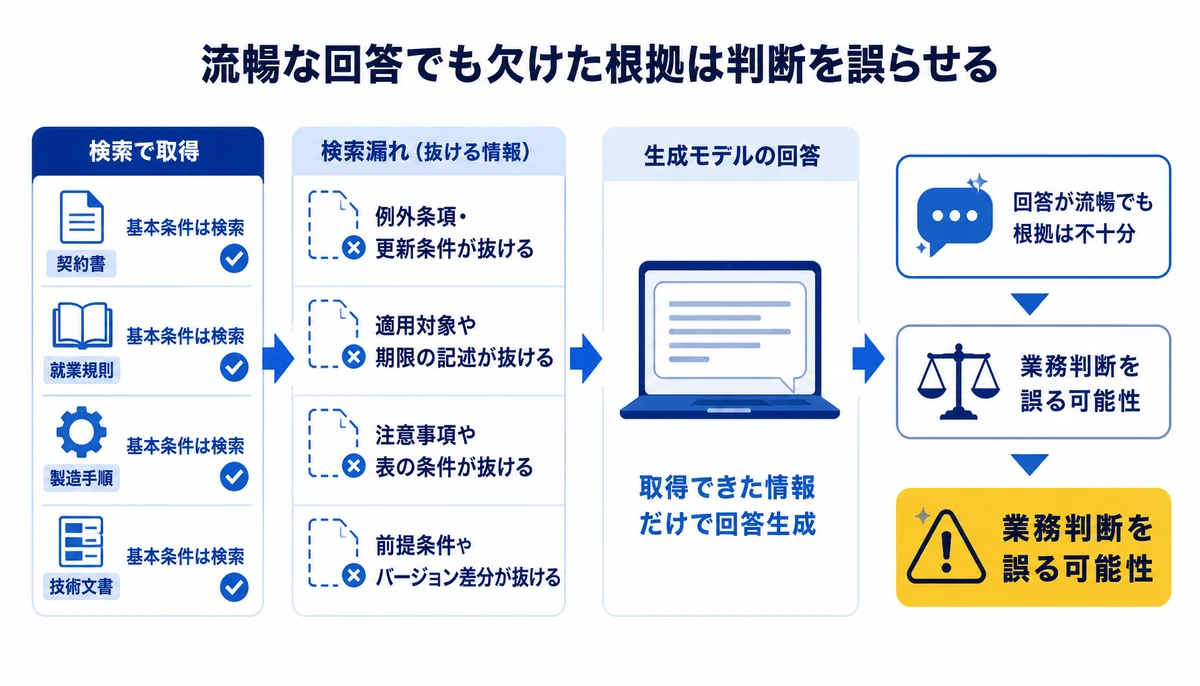
RAGの回答が内容として正しそうでも、検索対象に必要な文書や該当箇所がなければ、生成モデルは参照すべき根拠を欠いたまま回答する可能性があります。
見えている回答に明白な誤りがないほど、検索漏れは発見しにくくなるでしょう。
契約書なら、基本条件だけが検索されて、例外条項や更新条件が抜けるケースを考えられます。社内規程なら、原則の条文は取得できても、対象者を限定する但し書きが抜けるかもしれません。
- 契約書で、本文は取れても別紙の条件や例外条項が抜ける
- 就業規則で、原則は取れても適用対象や期限の記述が抜ける
- 製造手順で、手順本文は取れても注意事項や表の条件が抜ける
- 技術文書で、概要は取れても前提条件やバージョン差分が抜ける
このとき、生成モデルは取得できた情報だけで一貫した文章を作ります。回答が流暢であることは、必要な情報を網羅したことの証明になりません。
BinxAIが社内文書の検索設計を見るときも、回答文だけで判断を終えない進め方が必要だと考えます。質問に対して必要な根拠を先に定義し、何が検索され、何が落ちたかを確認します。
本番で怖いのは、誤った回答だけでなく、欠けた根拠から作られたもっともらしい回答です。
長文文書で再現率を測る単位と評価設計
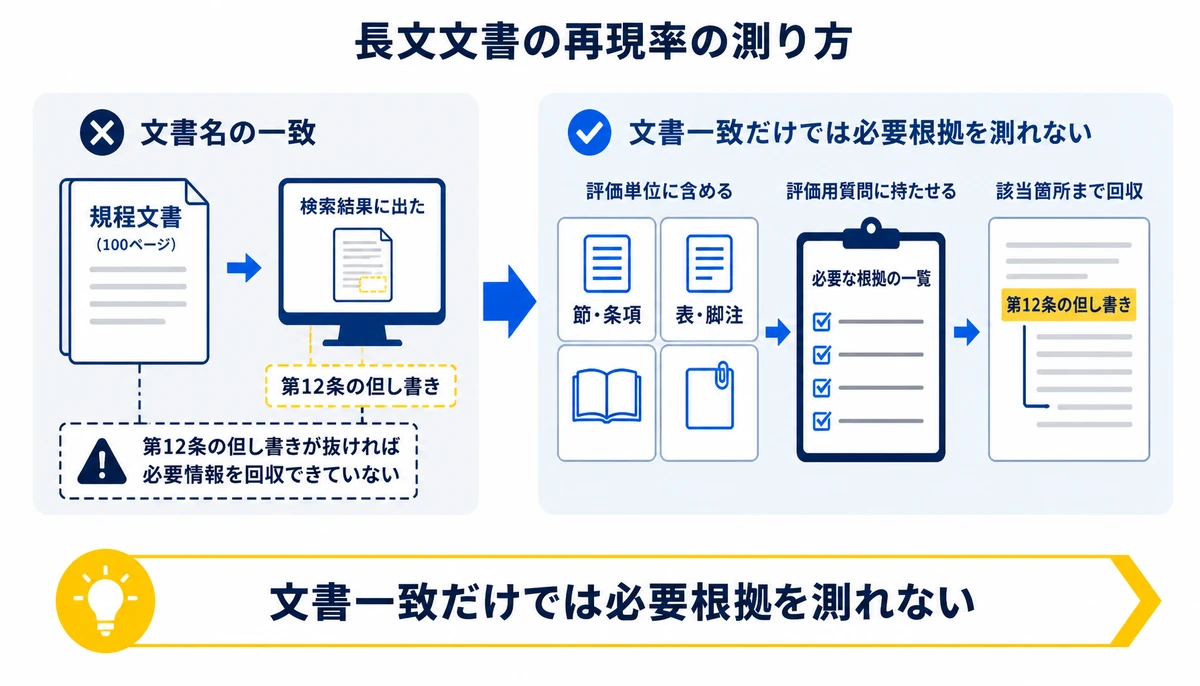
長文文書では、文書全体を検索できたかだけでは不十分です。公開された評価事例でも、質問に必要な節、条項、表、脚注まで回収できたかを評価単位に含める必要があるとされています。
たとえば、100ページの規程文書が検索結果に出ていても、質問の答えを決める第12条の但し書きが抜けていれば、業務上は必要情報を回収できていません。文書名の一致を再現率として扱うと、この差を測れなくなります。
評価用の質問には、回答文だけでなく、回答に必要な根拠の一覧を持たせます。検索結果に根拠が含まれたかを照合すれば、生成モデルの評価と検索器の評価を分けて確認できるでしょう。
評価セットに記録する項目
- 質問に対する正解文書の識別子
- 必要な節、条項、表、脚注の位置
- 検索結果に含まれたチャンクの識別子
- 検索されたが不要だった情報の範囲
- 文書の長さ、種類、階層構造
文書長や構造が異なるデータセットを同じ重みで評価すると、短い文書で高く見える検索性能が、長大な規程や技術文書での取りこぼしを覆い隠す可能性があります。文書種別ごとに評価結果を分ける設計が必要です。
| 評価対象 | 確認する問い | 見落としやすい点 |
|---|---|---|
| 文書 | 正しい文書が検索されたか | 該当箇所まで取れたとは限らない |
| 節・条項 | 回答に必要な根拠が揃ったか | 例外や条件が抜ける |
| 表・脚注 | 補足情報まで回収できたか | 本文だけで回答を生成する |
| 階層構造 | 親章や上位規程を追跡できたか | 断片だけで意味を解釈する |
検索設計で陥りやすい評価の落とし穴と改善の起点
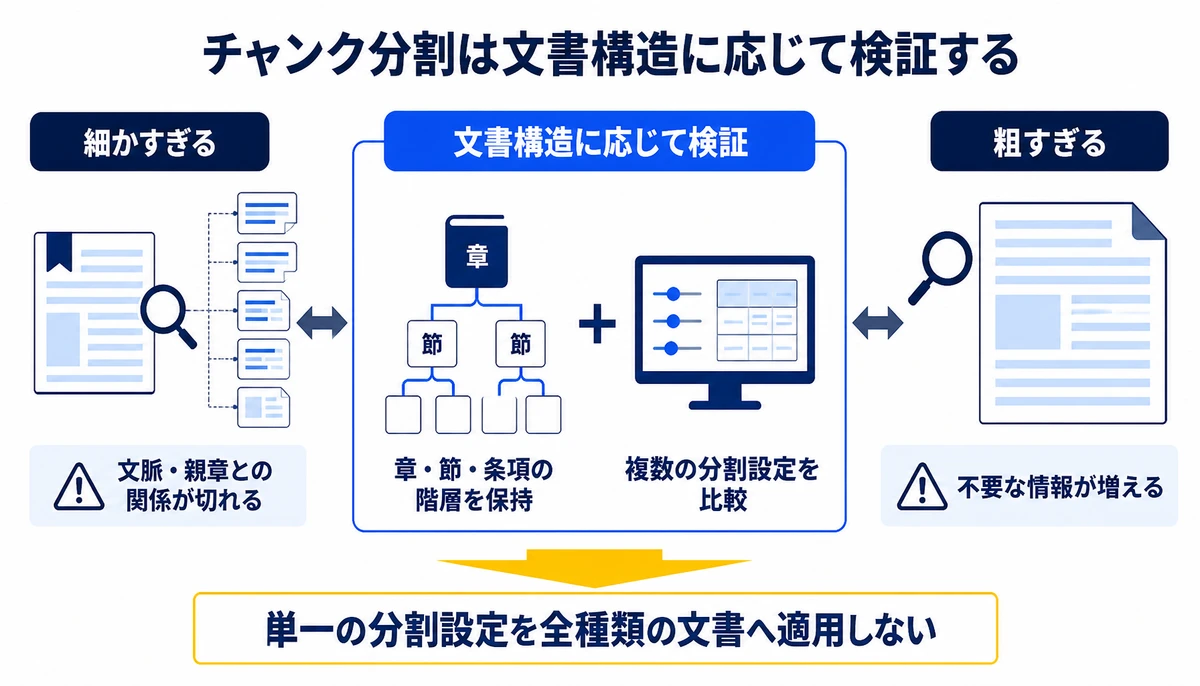
RAGの評価では、回答が自然であることを検索性能の代わりに扱う誤りが起こりやすくなります。回答の正しさは生成モデルの能力にも左右されるため、検索段階で必要な根拠が揃ったかを別に判定しましょう。
チャンク分割も再現率に影響します。分割が細かすぎると文脈や親章との関係が切れ、粗すぎると検索結果に不要な情報が増えます。文書構造に応じて検証する方が実態に近づくでしょう。
- 回答だけを採点し、検索されたチャンクを保存していない
- 文書名の一致を、該当条項の取得として扱っている
- 短いFAQと長大な規程を同じ評価グループに入れている
- 正解文書だけを登録し、必要な根拠の位置を定義していない
- 平均値だけを見て、重要文書の取りこぼしを確認していない
単一の分割設定を全種類の文書へ適用するより、文書構造に応じて検証する方が実態に近づきます。長文文書の検索漏れを抑える方法として、章、節、条項などの階層を保った索引化や、階層的な要約を組み合わせる設計が有効になり得ます。
検索対象を平面的なチャンクの集合として扱わないことが出発点です。

正解率以外のRAG評価項目と本番運用へ進む手順
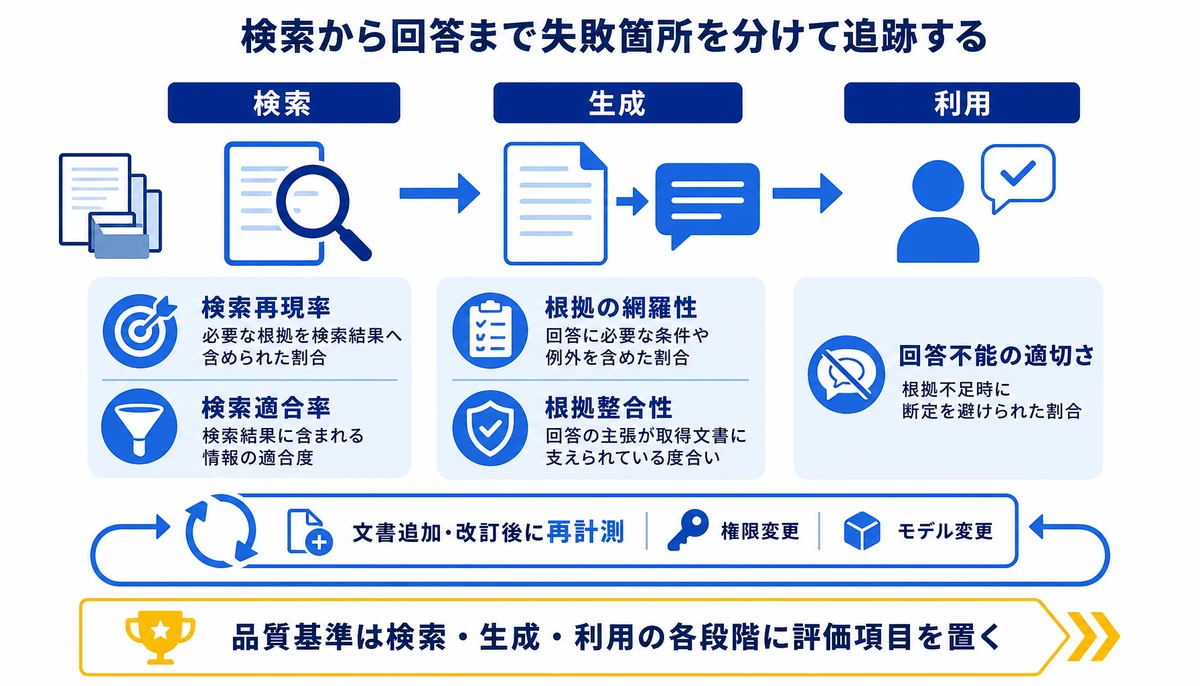
RAGの品質基準は、回答が正しいかだけで構成しない方が運用しやすくなります。検索、生成、利用の各段階に評価項目を置くと、問題がどこで発生したかを切り分けやすくなるでしょう。
検索再現率が低い場合は、埋め込み検索、キーワード検索、チャンク分割、メタデータ、階層構造の扱いを見直します。根拠整合性が低い場合は、検索結果の使い方や回答生成時の制約を確認します。
- 検索再現率、必要な根拠を検索結果へ含められた割合
- 検索適合率、検索結果に含まれる情報の適合度
- 根拠の網羅性、回答に必要な条件や例外を含めた割合
- 根拠整合性、回答の主張が取得文書に支えられている度合い
- 回答不能の適切さ、根拠不足時に断定を避けられた割合
本番では、指標を一度測って終わりにしません。文書の追加、改訂、権限変更、モデル変更のたびに、同じ評価セットで再計測できる状態を作ります。
評価結果には、文書種別と重要度も添えておくと判断材料が増えるでしょう。RAGの品質基準は、単一の正解率ではなく、検索から回答までの失敗箇所を追える形にします。
1. 質問と必要根拠を分ける
まず、実際の利用場面から質問を集めましょう。質問ごとに、回答に必要な文書、節、条項、表、脚注を担当者が確認し、正解根拠として登録するのが最初の一手です。
2. 検索結果を保存する
回答文だけでなく、検索されたチャンク、順位、スコア、文書の版、検索方式を保存します。後から再現率を計算し、分割や検索方式の変更前後を比較できる状態にしておきましょう。
3. 文書種別ごとに分ける
契約書、規程、手順書、FAQを一つの平均値にまとめません。長さ、構造、改訂頻度、回答の業務影響が異なるため、評価グループを分けて結果を読みます。
4. 失敗時の動作を決める
必要な根拠が検索できないとき、回答を保留するのか、追加質問を返すのか、担当部署へ引き継ぐのかを決めます。根拠不足でも回答を続ける設計は、検索漏れを利用者から隠す可能性があるため注意が必要です。
5. 変更後に再評価する
チャンク設定、検索方式、埋め込みモデル、生成モデルを変更したら、同じ評価セットで再計測します。回答の見た目だけでなく、再現率と根拠整合性の変化を確認しましょう。
自社で進める際の判断材料
自社で評価を始めると、質問と正解根拠の紐付けに時間がかかります。特に長文の規程や契約書では、条項だけでなく表、脚注、別紙まで確認しなければなりません。
検索器の改善と評価セットの整備を別々に進めると、数値が変わった理由を追いにくくなります。文書構造の整理、評価設計、検索設定、本番監視を同じ流れで確認できる体制が必要です。
- 質問ごとの必要根拠を業務担当者から集める
- 長文文書の節、条項、表、脚注を評価単位にする
- 検索結果と回答結果を分けて記録する
- 文書種別と重要度ごとに再現率を確認する
- 根拠不足時の保留や引き継ぎを業務フローへ組み込む
外部の支援を使う場合は、検索設定だけを受け取るのではなく、現行文書と業務判断の関係まで整理できるかを確認します。評価セットの作成者、指標の責任者、変更後の再評価担当も契約前に決めておくと、運用へ移しやすくなるでしょう。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。RAGの導入でも、回答品質だけでなく、必要な根拠の所在や検索漏れを確認したうえで設計を進めるのが基本方針です。
見積は一式でまとめず、要件を整理したうえで詳細を提示します。契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進められます。企画、課題整理、要件整理から開発までを同じ担当が受け持ち、運用の引き継ぎと内製化まで支援する体制です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
再現率0.481はRAGとして失格ですか?
この数値だけで失格とは判断できません。対象文書、質問、正解根拠の定義、業務影響を確認し、重要な質問で必要情報を落としていないかを分けて判断します。
適合率が高ければ検索結果は十分ですか?
十分とは限りません。適合率は検索結果の不要情報の少なさを見ますが、必要情報の取りこぼしは再現率で確認します。両方を文書種別ごとに追跡してください。
長文文書の正解根拠はどこまで登録しますか?
回答を決める節や条項だけでなく、条件を補う表、脚注、別紙も対象にします。質問によって必要範囲が変わるため、文書単位の正解ラベルだけでは足りません。
検索漏れを減らすにはチャンクを小さくすればよいですか?
小さくすれば解決するとは限りません。文脈や親章との関係が切れる可能性があるため、章、節、条項の階層を保持し、複数の分割設定を評価セットで比較しましょう。
回答の正しさ以外に何を監視しますか?
検索再現率、検索適合率、根拠の網羅性、根拠整合性、根拠不足時の回答不能を監視します。文書の追加や改訂後にも同じ質問で再評価し、変更の影響を確認しましょう。
RAGの本番品質は、回答が正しそうかだけでは測れません。適合率0.844の裏側で再現率0.481にとどまる場合があるように、必要な根拠を検索できたかを長文文書の構造まで含めて確認します。まずは実際の質問を集め、必要な条項や脚注を正解根拠として登録し、検索結果と回答を分けて評価するところから始めてください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

LLMOps入門:生成AIの品質劣化に気づけない組織から抜け出す運用設計
PoC後の本番運用で陥りがちな「動いているから大丈夫」という誤解を崩し、非決定的なAI出力の品質劣化リスクを経営課題として捉え直す。エンジニア不在でも機能する評価ループの作り方と、ビジネス担当者が担う品質監督の役割設計を具体的に解説する。
Red Teaming Agentで変わる企業AIの評価方法
MicrosoftのResponsible AI Standard再設計を手がかりに、AIエージェントのツール呼び出しや権限利用まで評価する方法を整理します。レッドチームの発見を調達基準、監査証跡、リリース判断、運用監視へ接続する実装手順と落とし穴を解説します。
Inception Mercury 3公開 高速LLMは業務で使えるか
Inception Labsが公開したMercury 3は毎秒1000トークン超を掲げる拡散型LLMです。速度だけで導入を決めず、日本語品質や同時実行数、実効コストを自社業務で比較する方法を整理します。















