
Inception Mercury 3公開 高速LLMは業務で使えるか
要約
Inception Labsが公開したMercury 3は毎秒1000トークン超を掲げる拡散型LLMです。速度だけで導入を決めず、日本語品質や同時実行数、実効コストを自社業務で比較する方法を整理します。
高速なLLMが公開されると、生成AIの比較軸は「どれだけ賢いか」から広がります。問い合わせへの返答や文書処理を、どれだけ速く安く完了できるかが問われます。
この記事の対象読者
- 大量の文書処理を高速化したい企業
- 問い合わせ対応の待ち時間を減らしたい企業
- LLMのAPI費用を見直したい企業
- 定型業務向けの軽量モデルを探す企業
- 自社データでAIモデルを比較したい企業
Mercury 3の仕様と公開情報
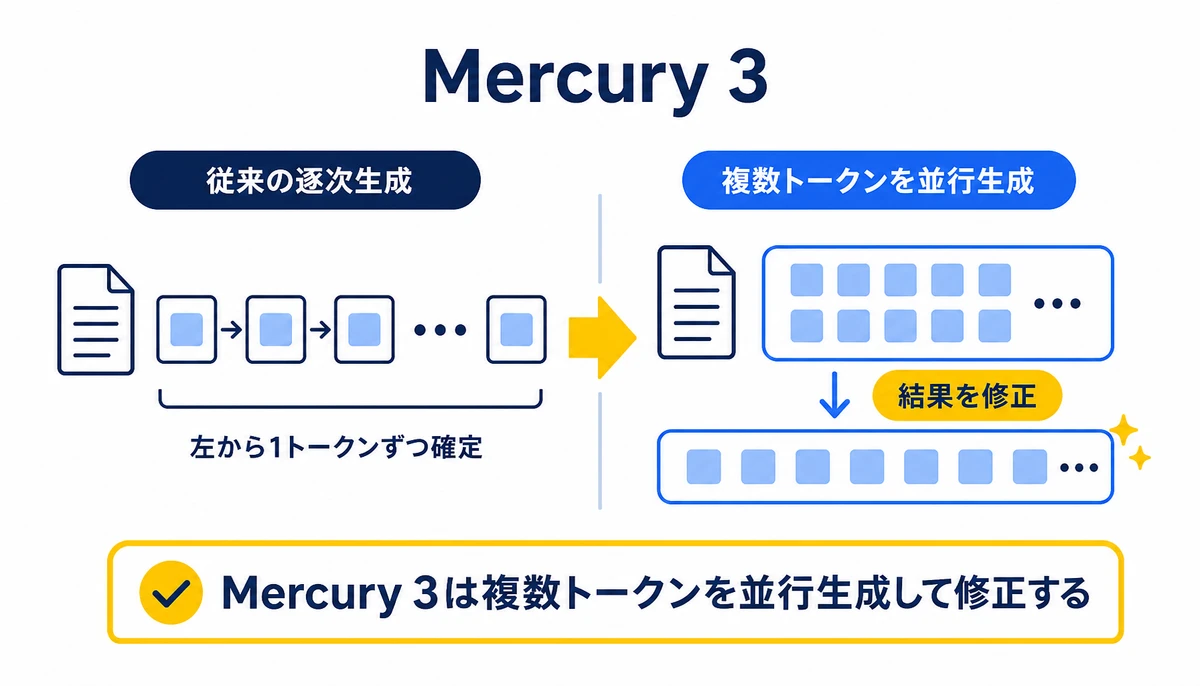
Inception Labsは2026年10月19日、拡散型の文章生成モデル「Mercury 3」を公開しました。公開日は同社の発表によるものです。
Mercury 3は、文章を左から1トークンずつ確定する方式とは異なる設計を採っています。複数のトークンを並行して生成し、全体の結果を修正しながら文章を組み立てる仕組みです。
- 生成方式、複数トークンの並行生成と結果の修正
- 生成速度、毎秒1000トークンを超える公開情報
- コンテキスト、最大100万トークンの公開情報
- ローンチ価格、入力100万トークンあたり0.10ドル、出力100万トークンあたり0.35ドル
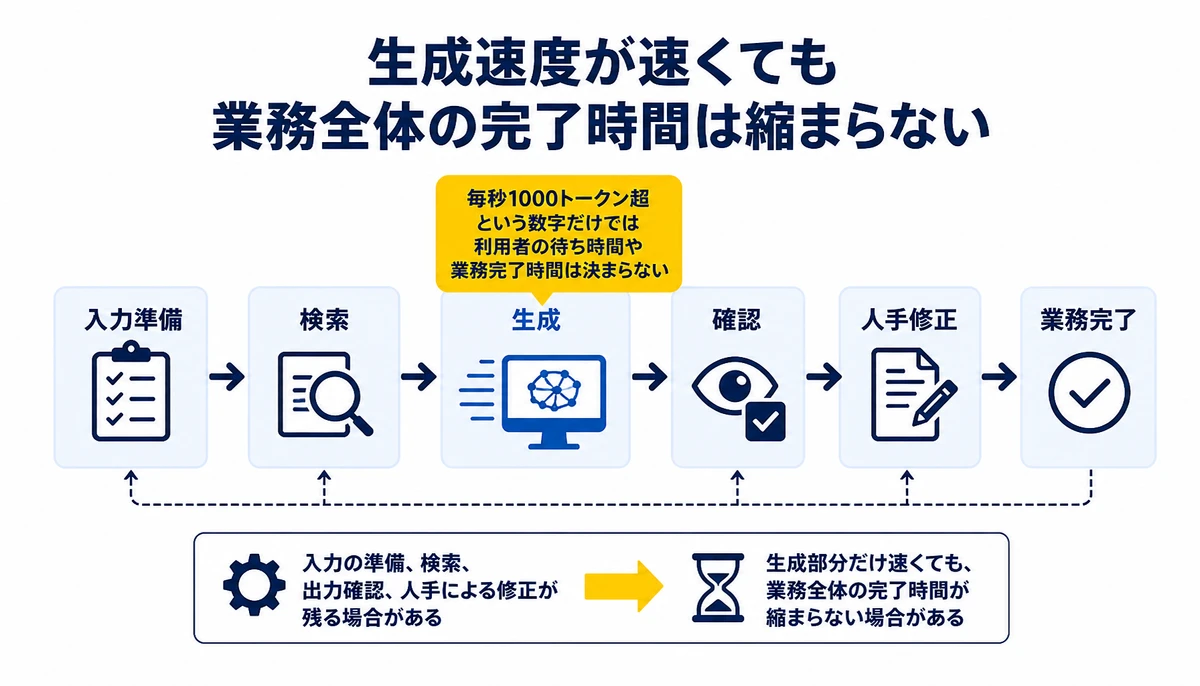
毎秒1000トークン超という数字は、同じ長さの回答を短時間で生成できる可能性を示します。ただし、この数字だけでは利用者が感じる待ち時間や、業務が終わるまでの時間は決まりません。
| 公開された項目 | Mercury 3の情報 | 業務で確認する項目 |
|---|---|---|
| 生成速度 | 毎秒1000トークン超 | 初回応答時間と処理完了時間 |
| コンテキスト | 最大100万トークン | 長文入力時の品質と安定性 |
| 入力価格 | 100万トークンあたり0.10ドル | 1件あたりの入力量と実際の請求額 |
| 出力価格 | 100万トークンあたり0.35ドル | 再生成と人手修正を含む完了コスト |

拡散生成が変える待ち時間
拡散型生成では、文章の候補をまとめて扱えるため、トークンを順番に出す方式とは異なる速度設計が可能になります。定型文の作成や分類結果の説明など、出力の形が決まった業務で差が出るかもしれません。
一方で、速さがそのまま業務の短縮になるとは限りません。入力の準備、検索、出力確認、人手による修正が残れば、生成部分だけ速くても完了時間は縮まらないでしょう。
海外ではモデル同士のベンチマーク順位が注目されやすい状況です。BinxAIが現場で見る限り、導入の分かれ目は順位より、定型業務を最後まで完了できるかどうかにあります。
定型業務で測る4項目
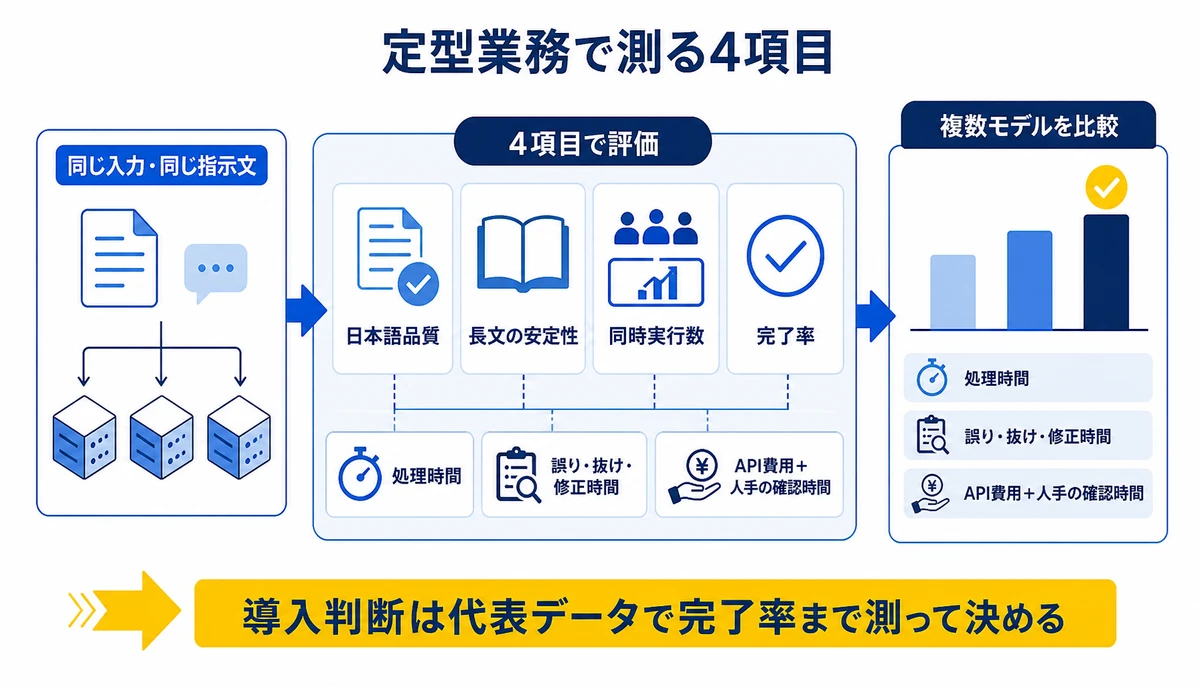
Mercury 3を候補にする場合、実際の業務から少量の代表データを選ぶことを勧めたいです。一般的な質問ではなく、失敗すると修正が発生する仕事を測定対象にします。
- 日本語品質、敬語、固有名詞、社内用語の誤りを確認する
- 長文の安定性、資料が長くなったときの抜けや矛盾を確認する
- 同時実行数、利用者や処理件数を増やしたときの待ち時間を測る
- 完了率、再生成や人手修正なしで次工程へ渡せる割合を記録する
速度は、1件だけの最短時間ではなく、同時に複数件を処理したときの変化で見るのが基本です。問い合わせ対応なら初回返答、文書処理なら取り込みから確認用データの出力までを1単位として記録しましょう。
費用はAPIの入力単価と出力単価だけで比較しません。再生成、確認者の作業、誤りの差し戻しまで含めて、1件の業務完了にいくらかかったかを記録します。
- 同じ入力データと同じ指示文で複数モデルを実行する
- 1件あたりの処理時間と同時実行数を記録する
- 正解基準に沿って誤り、抜け、修正時間を確認する
- API費用と人手の確認時間を合わせて比較する
自社導入で詰まりやすい箇所
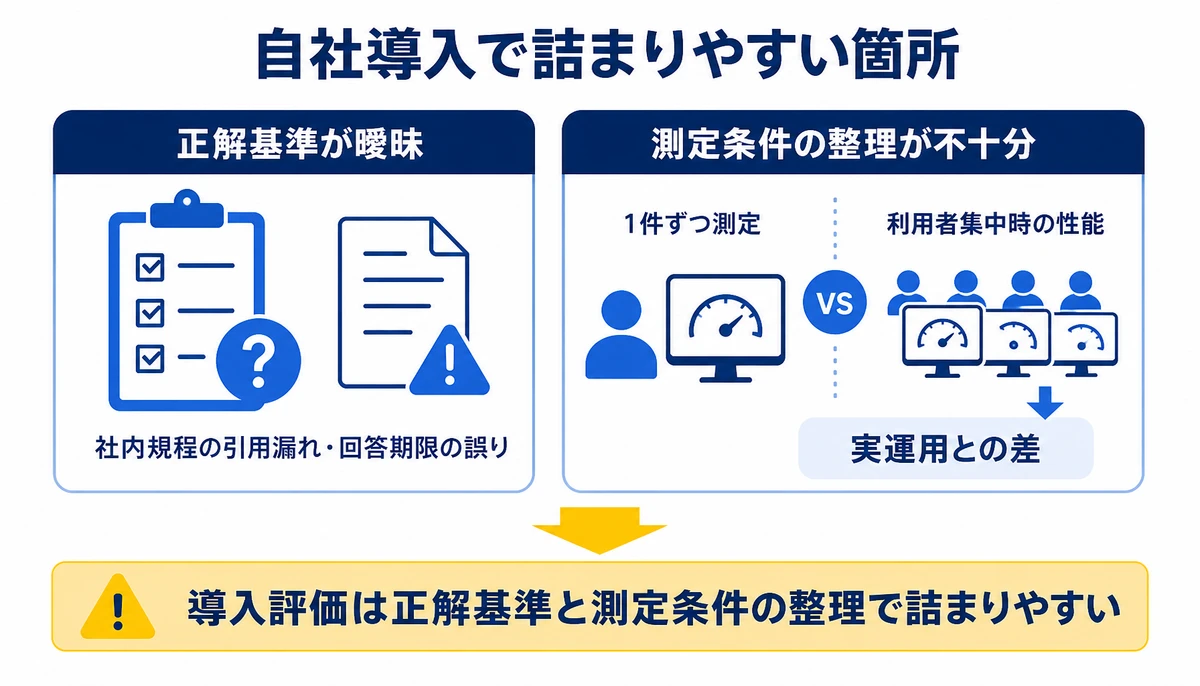
自社データで比較すると、まず正解の基準が曖昧になりがちです。日本語として自然でも、社内規程の引用漏れや回答期限の誤りがあれば業務では使えません。
次に、速度測定の条件が揃わない問題があります。1件ずつ測った結果と、利用者が集中した時間帯の結果は異なるため、同時実行数を変えた記録が必要です。
こうした条件整理を外部の支援で補う場合、モデル選定だけでなく対象業務の定義から評価基準、運用への引き継ぎまでを一つの流れで確認できるでしょう。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。Mercury 3を含むモデル比較でも、先に業務の完了条件を整理してから検証項目を決める流れ。見積は一式いくらという形にせず、要件を整理したうえで詳細を示すのが基本です。
契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進められます。
企画、課題整理、要件整理から開発までを同じ担当が受け持ちます。内製化と社内定着まで支援し、料金は公式ページと無料相談で案内します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Mercury 3は何が速いのですか?
複数のトークンを並行して生成し、結果を修正する拡散型の方式が特徴です。公開情報では、毎秒1000トークンを超える生成速度が示されています。
毎秒1000トークン超なら業務も必ず速くなりますか?
必ず速くなるとは限りません。検索、入力準備、確認、人手修正が処理時間の大部分を占める場合があるため、業務全体の完了時間を測ることが先決です。
最初にどの業務で試すとよいですか?
分類、定型的な要約、問い合わせの下書きなど、正解基準を作りやすい業務が出発点として向いています。修正時間まで記録すると、速度と品質を同じ土俵で比べられます。
API料金だけで安さを判断できますか?
API料金だけでは判断できません。再生成、確認、人手修正の時間を加えた1件あたりの業務完了コストを、候補モデルごとに確認します。
ベンチマークで上位なら導入してよいですか?
ベンチマークは候補を絞る材料です。日本語の自然さ、長文入力、同時実行時の速度、社内データでの完了率を確認してから判断します。
Mercury 3の公開は、LLMを速度と費用で選ぶ流れを強める可能性があります。導入を検討する企業は、公開ベンチマークの順位で決めず、自社の定型業務で速度、品質、同時実行数、実効コストを測ってください。
本記事の情報は2026年10月20日時点の公開情報に基づきます。料金や提供条件は変更される可能性があるため、契約前に各社へ確認してください。個別の導入成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Mercury 2.5の並行生成で変わるLLM選定 業務データで精度と速度を比べる方法
Inceptionが発表したMercury 2.5は、複数トークンを並行生成して修正する拡散モデルです。毎秒1107トークンの意味を整理し、定型業務での適用可能性と精度・待ち時間・コストの比較方法を解説します。
AIコスト管理 モデル単価から業務1件の実行単価へ切り替える方法
AI API料金やLLM料金比較をモデル単価だけで判断すると、推論量や再試行、提供事業者の速度と信頼性を見落とします。業務1件の完了費用を測る実効単価の設計、ログ項目、TCO試算、モデル選定の進め方を解説します。
RAGの正解率が高くても危ない 再現率0.481が示す本番の盲点
RAGの回答が正しそうに見えても、検索段階で必要な条項や根拠を落とすと業務判断を誤るおそれがあります。適合率0.844と再現率0.481の差を起点に、長文文書の評価方法、検索設計、運用基準の作り方を整理します。















