
AIコスト管理 モデル単価から業務1件の実行単価へ切り替える方法
要約
AI API料金やLLM料金比較をモデル単価だけで判断すると、推論量や再試行、提供事業者の速度と信頼性を見落とします。業務1件の完了費用を測る実効単価の設計、ログ項目、TCO試算、モデル選定の進め方を解説します。
この記事の対象読者
AI APIの見積もりと本番費用が合わず、モデルや推論基盤の選定を見直したい技術担当者を想定しています。特に、業務単位で費用と品質を説明する必要がある方に向けた内容です。
- AI APIの費用が予算を超えそうな企業や組織
- 複数モデルの料金を比較したい企業や組織
- AIエージェントのTCOを試算したい企業や組織
- 推論速度と費用を同時に改善したい企業や組織
- モデルや推論基盤の選定に悩む企業や組織
定価比較だけでは足りない理由
料金表が示すのはトークン単価だけ
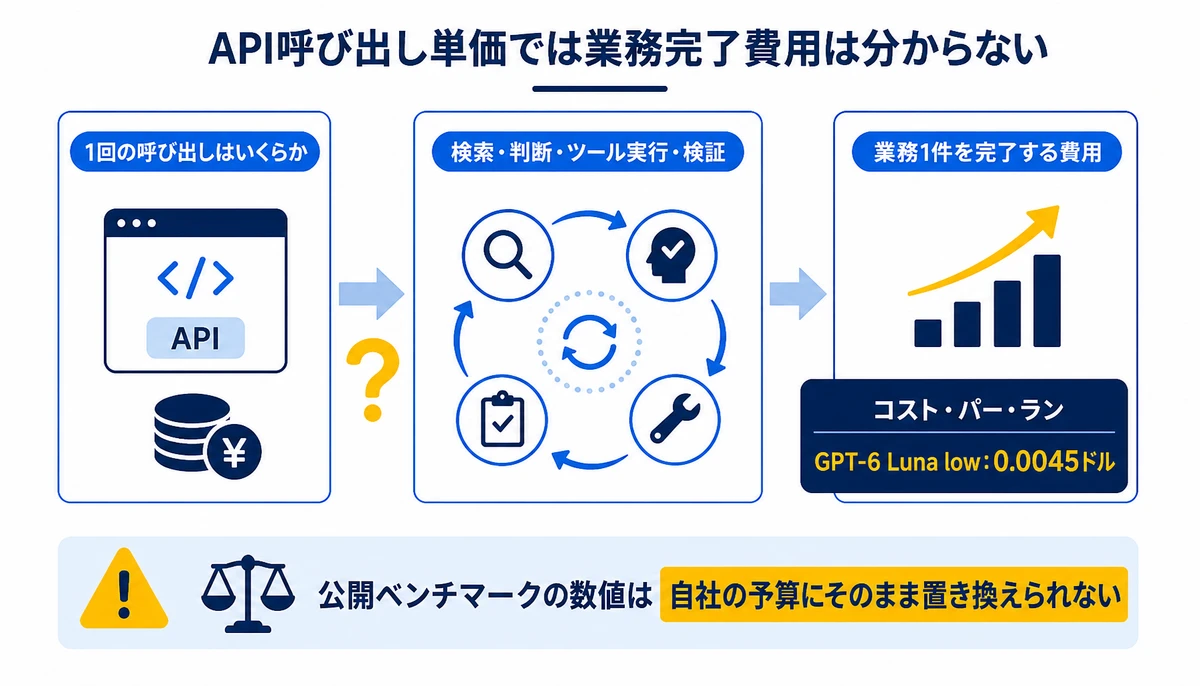
LLMの料金表は、通常は入力トークンと出力トークンの単価で整理されています。ところが、業務処理ではモデルが1回だけ応答するとは限らず、検索、判断、ツール実行、検証を繰り返すものでしょう。
海外の公開ベンチマークでは、モデルの定価ではなく、標準化したタスクを最後まで実行する費用での比較が広がりつつあります。BenchLeaderは、LLMの価格をトークン単価だけでなく、ベンチマーク一式を完了する「コスト・パー・ラン」で公開しているツールだ。
BenchLeaderの公開データでは、GPT-6 Luna lowのベンチマーク一式実行費用が0.0045ドルと示されています。この数字は一般的な業務の価格ではなく、同ベンチマークの条件で一式を完了したときの費用です。
したがって、公開ベンチマークの数値をそのまま自社の予算に置き換えることはできません。自社の入力形式、品質条件、ツール呼び出し、失敗時の扱いを含む標準タスクを用意する必要があります。

実行単価を構成する要素
業務1件の完了を分母に置く
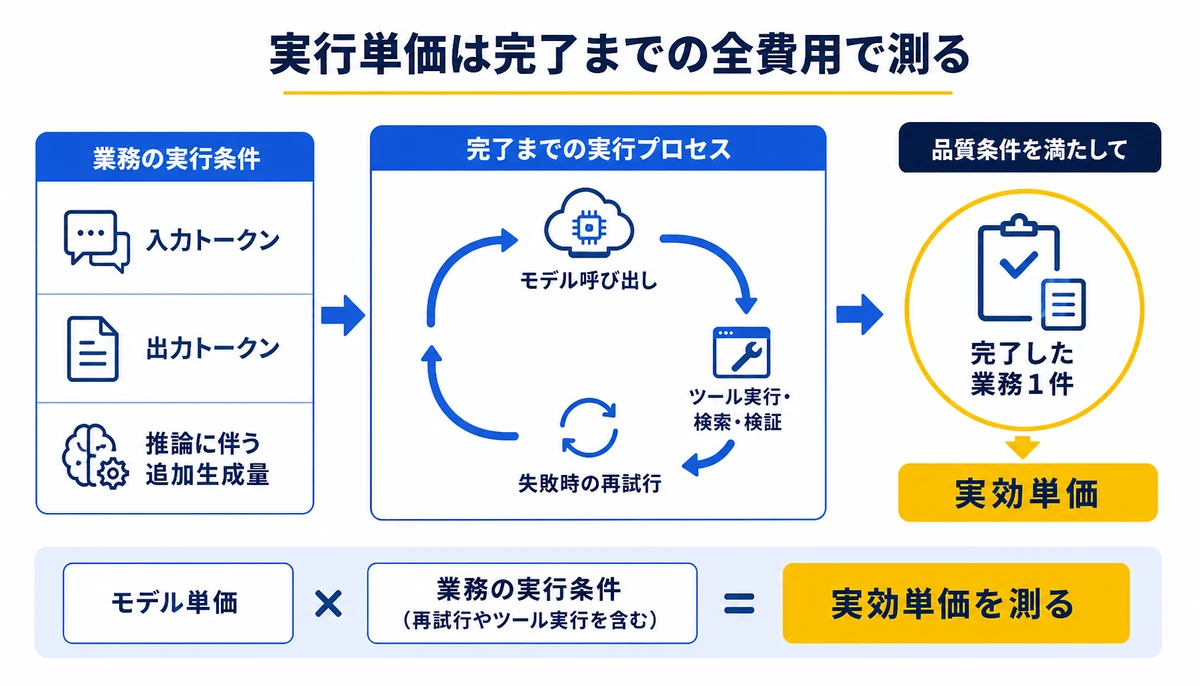
実行単価は、モデル単価に業務の実行条件を掛け合わせた値です。ここでいう業務1件は、たとえば「申請書を確認し、根拠を添えて判定し、基幹システムへ登録する」までの完了単位を指します。
推論量の多いモデルでは、入力トークン単価が同じでも総費用が上がる場合があります。TokenWatchのベンチマークは、出力トークンや推論に伴う追加生成量が増えることで、タスク完了までの費用が上昇し得ると示しているでしょう。
- 入力トークン、出力トークン、推論に伴う追加生成量
- タスクを完了するまでのモデル呼び出し回数
- ツール実行、検索、検証、失敗時の再試行
- キャッシュの利用状況と提供事業者ごとの課金条件
- 品質判定、処理時間、エラーを含む完了条件
AIエージェントでは、最初の回答が正しいかを別の処理で確認する構成があります。確認に失敗すると再実行が起きるため、1回のAPI料金だけを見ても、完了に必要な費用は分かりません。
実効単価は、品質条件を満たして完了した業務1件の費用として定義します。途中でエラーになった処理や、担当者が修正して完了した処理をどう扱うかも、測定前に決めておきます。
| 比較対象 | 見る単位 | 見落としやすい項目 |
|---|---|---|
| モデル単価 | 入力・出力トークン | 再試行と推論量 |
| API呼び出し費用 | 1回のリクエスト | ツール実行と失敗処理 |
| 実行単価 | 業務1件の完了 | 品質条件と人手修正 |
| TCO | 業務量と運用期間 | 監視、保守、切り替え |
TCOはTotal Cost of Ownershipの略で、導入時の費用だけでなく、運用、保守、監視、変更対応まで含めた総保有コストです。業務1件の実行単価を出発点に、月間件数と運用作業を重ねて試算します。
提供経路で変わる実効単価
同じモデルでも事業者ごとに差が出る
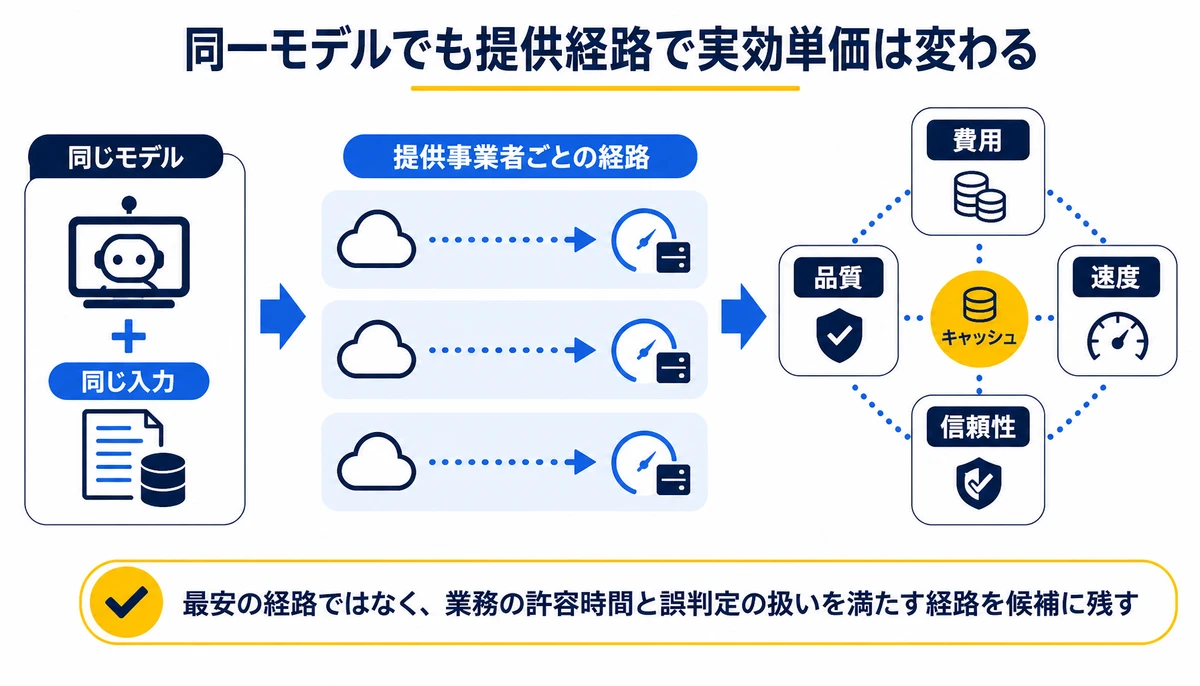
同じモデル名を使っていても、どの提供事業者を経由するかで結果が変わる可能性があります。ProviderBenchは、同一モデルについても、事業者ごとの速度、信頼性、キャッシュを含む費用を比較対象にしているでしょう。
速度は、単なる待ち時間ではなく、業務全体の処理能力に影響します。応答が遅いとタイムアウトや並列数の制約が起き、結果として再試行や担当者の介入が増えることがあるでしょう。
信頼性も費用の一部として扱います。エラー率が高い経路は、定価が低くても再実行、監視、障害対応の負担が増え、業務1件あたりの費用が上がる場合があるでしょう。
- 同じモデルと同じ入力で、提供事業者ごとの完了時間を測る
- 成功、タイムアウト、形式不正などの結果を分けて記録する
- キャッシュが適用された処理と、適用されなかった処理を分ける
- 再試行を含む総トークンと、完了までの呼び出し回数を集計する
比較結果は、費用、品質、速度、信頼性の4軸で確認するのが基本です。最安の経路を選ぶのではなく、業務の許容時間と誤判定の扱いを満たす経路を候補に残します。
業務1件で測るログ設計
開始と終点の定義が測定の精度を決める
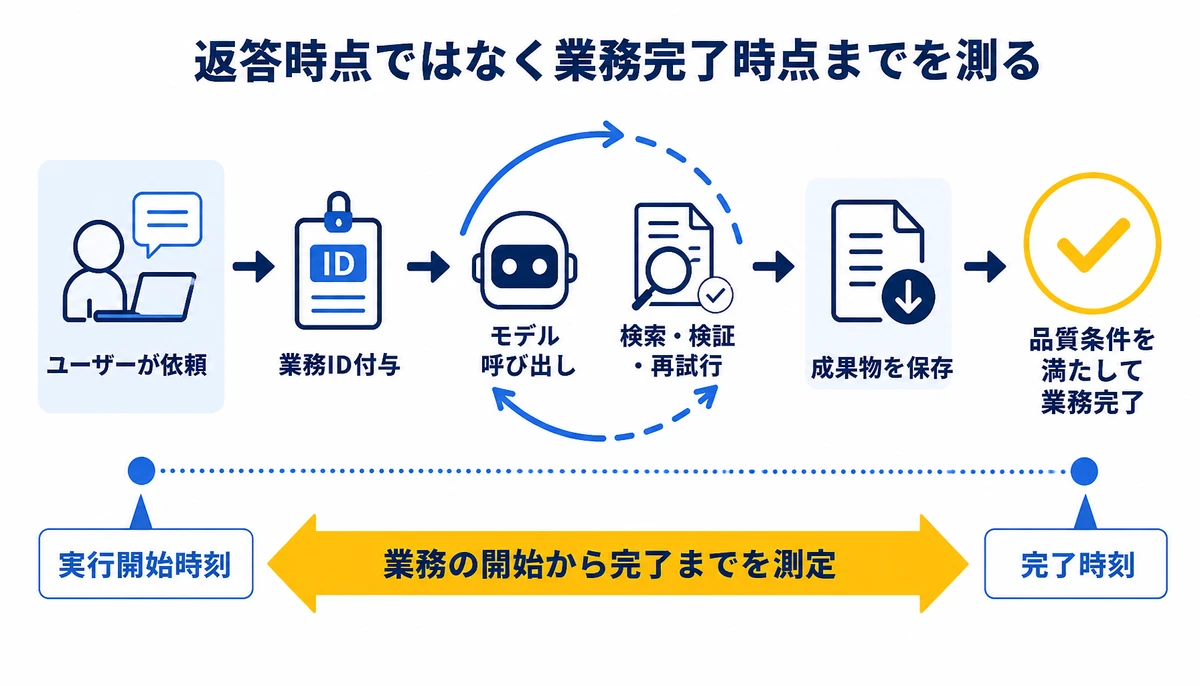
測定の起点は、ユーザーが依頼を出した時点です。終点は、モデルが返答した時点ではなく、品質条件を満たした成果物が保存され、必要な業務処理が完了した時点に置きます。
1件の処理に識別子を付け、複数回のモデル呼び出しを同じ業務へ紐づけましょう。これにより、最初の応答だけでなく、検索、検証、再試行まで含めた費用を集計できます。
- 業務ID、モデル名、提供事業者、実行開始時刻と完了時刻
- 入力、出力、推論に関するトークン量と課金額
- ツール呼び出し、キャッシュ利用、再試行の回数
- 成功、失敗、タイムアウト、担当者修正の結果
- 品質評価と、業務を完了したかどうかの判定
ログは、費用計算用と品質評価用に分けすぎないことがポイントです。費用が低い処理だけを集計すると、失敗した処理や人手で補正した処理が分母から抜けるためです。
実効単価の計算式と人件費の扱い
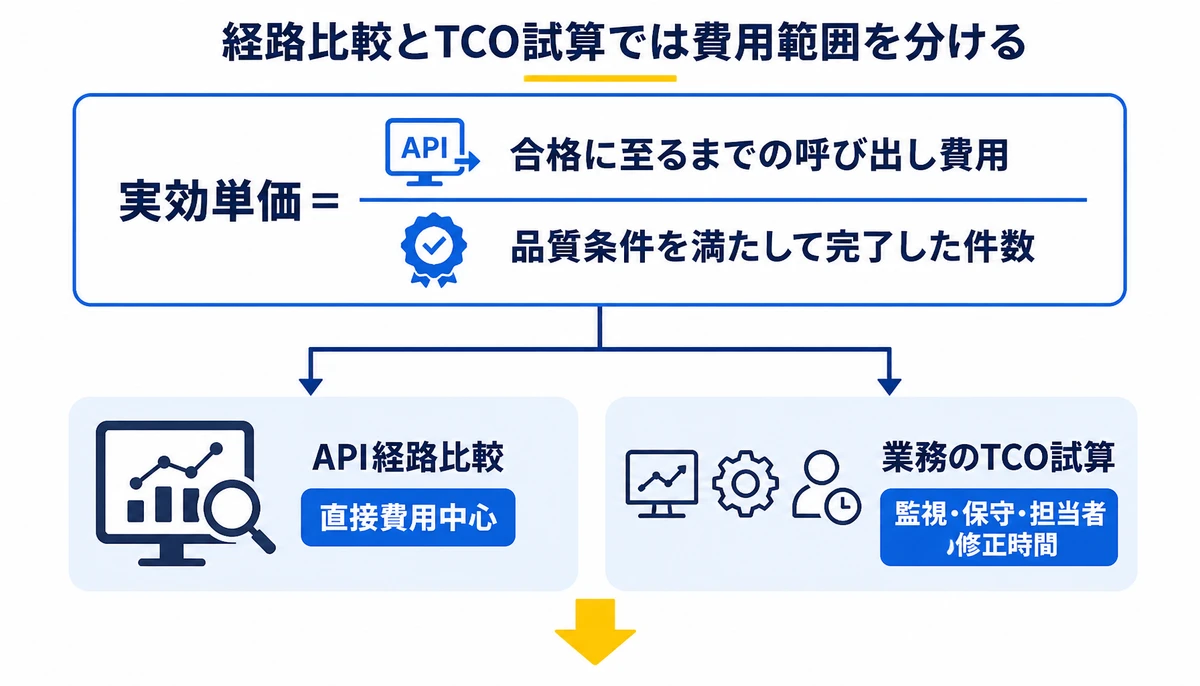
業務1件の実効単価は、次のように計算します。分子には成功処理だけでなく、合格に至るまでに発生した呼び出し費用を含め、分母には品質条件を満たして完了した件数を置きます。
実効単価 = 完了した業務群にかかった総費用 ÷ 品質条件を満たして完了した業務件数

総費用 = 入力費用 + 出力費用 + 推論関連費用
+ ツール実行費用 + 再試行費用 + 運用上の追加費用この式に人件費を含めるかは、意思決定の目的で分けるのが基本です。API経路を比較する場合は直接費用を中心にし、業務のTCOを試算する場合は監視、保守、担当者の修正時間も別項目として加えます。

比較試験から本番判断へ
最初から全業務を測る必要はありません。費用が大きい、失敗時の影響が大きい、処理件数が多い業務を1つ選び、代表的な入力を標準タスクとして固定します。
- 業務の開始条件、完了条件、品質合格条件を文章にする
- 代表的な入力と、難しい入力を同じ試験セットに含める
- モデル、提供事業者、推論設定を変えて同じ処理を行う
- 費用、完了時間、成功率、再試行回数を業務ID単位で集計する
- 候補を本番に近い負荷で再確認し、切り替え条件を決める
品質合格条件は、モデルの出力形式だけで決めません。根拠の有無、禁止情報の混入、登録先との整合性、担当者が修正せず使えるかまで含めます。条件が曖昧なままだと、安価なモデルが有利に見えることもあるでしょう。
比較表では、単価の列を先頭に置かない方法もあります。まず完了率と処理時間を確認し、その条件を満たす候補だけで費用を比べると、定価の安さに判断が引っ張られにくくなるでしょう。
選定後も、月次で実効単価を追います。プロンプト変更、入力データの長期化、キャッシュ条件の変更、提供経路の障害によって、同じモデルでも業務費用は変動するためです。
| 判断軸 | 確認する問い | 本番移行の条件例 |
|---|---|---|
| 品質 | 合格条件を満たしたか | 業務固有の検査に合格する |
| 速度 | 許容時間内に終わるか | タイムアウトを管理できる |
| 信頼性 | 失敗時に復旧できるか | 再試行の上限を設ける |
| 費用 | 完了1件の費用はいくらか | 予算上限を超えない |
自社実装で詰まりやすい箇所
自社で測定を始めると、最初に業務の完了条件が曖昧になりやすいです。回答が返れば完了なのか、基幹システムへの登録まで必要なのかで、実効単価の分母が変わります。
- 複数回の呼び出しを同じ業務IDへ結び付けられない
- 再試行や担当者修正を費用集計から外してしまう
- モデル単価、実行単価、TCOの範囲が混在する
- 品質合格の判定が担当者ごとに変わる
外部の支援を使う場合は、モデルの候補を増やすことより、業務定義と測定設計を先にそろえられるかを確認します。ログの項目、評価基準、費用の範囲が固まると、技術比較の結果を予算説明へつなげやすくなるでしょう。
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。料金は一式で示さず、要件を整理したうえで詳細な見積を出し、契約後に要件が動いても決めた範囲で優先順位を入れ替えて進みます。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ち、運用の引き継ぎと内製化まで支援するのが特徴です。業務1件の実行ログをどこで取り、どの品質条件で費用を判定するかを、現場の運用に合わせて整理します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
モデル単価と実行単価は何が違いますか?
モデル単価は入力や出力など、トークン単位の価格です。実行単価は、再試行やツール実行を含め、品質条件を満たして業務1件を完了するまでにかかった費用です。
推論量はなぜ費用を押し上げるのですか?
推論量の多いモデルでは、回答を作る途中の追加生成や長い出力が発生する場合があります。入力単価が同じでも、完了までの生成量と呼び出し回数が増えると、総費用は上がり得るでしょう。
同じモデルなら提供事業者を比べなくてもよいですか?
比べる必要があります。同じモデルでも、提供事業者によって速度、信頼性、キャッシュの扱いが異なります。同じ標準タスクを実行し、完了時間と失敗を含めて確認してください。
AIエージェントのTCOは何を含めますか?
APIや推論の直接費用に加え、ツール実行、再試行、監視、保守、障害対応、担当者の修正時間を含めるか決めます。経路比較では直接費用、本番計画では運用費用を分けて表示すると判断しやすくなるでしょう。
最初の比較試験はどの業務から始めますか?
処理件数が多く、費用や失敗の影響が見えやすい業務から始めるのが基本です。代表的な入力だけでなく、難しい入力も含め、開始条件、合格条件、完了条件を先に固定してください。
AIコスト管理の基準は、モデルの定価から業務の完了費用へ移ります。まず1つの業務で完了条件とログ項目を定め、モデル、提供事業者、推論設定を同じタスクで比較してください。
本記事の価格情報とベンチマーク結果は、2026年10月17日時点で参照できる公開情報に基づきます。他社サービスの料金や提供条件は変更される可能性があるため、契約前に各社へ確認してください。記事内の方法を実施しても、特定の費用削減や成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Agent Lightning v1.0は企業のAI開発をどう変えるか
Microsoft Researchが公開したAgent Lightning v1.0は、既存のAIエージェントを実際の業務ハーネス上で改善する軽量フレームワークです。約3,500行、Kubernetes対応、SWE-benchでの評価結果から、企業が検討すべき開発と運用の論点を整理します。
OpenClaw Enterprise導入前に確認したい統制項目
OpenClaw EnterpriseをAIエージェント基盤として導入する前に、認証・権限分離・実行環境の隔離・操作ログ・緊急停止・障害復旧・更新責任をどう確認するか整理します。セルフホストの費用と責任も含め、導入判断から検証手順まで具体的に解説します。
Mercury 2.5の並行生成で変わるLLM選定 業務データで精度と速度を比べる方法
Inceptionが発表したMercury 2.5は、複数トークンを並行生成して修正する拡散モデルです。毎秒1107トークンの意味を整理し、定型業務での適用可能性と精度・待ち時間・コストの比較方法を解説します。















