
Agent Lightning v1.0は企業のAI開発をどう変えるか
要約
Microsoft Researchが公開したAgent Lightning v1.0は、既存のAIエージェントを実際の業務ハーネス上で改善する軽量フレームワークです。約3,500行、Kubernetes対応、SWE-benchでの評価結果から、企業が検討すべき開発と運用の論点を整理します。
AIエージェントの精度改善では、より新しいモデルへ交換する方法が先に検討されがちです。Microsoft Researchの新しい発表は、既存エージェントを実際の業務に近い環境で訓練する方向を示しました。
Agent Lightning v1.0は、研究用の実験だけでなく、企業がすでに使っているエージェントの改善ループに焦点を置きます。業務で試す企業は、フレームワークの採用だけでなく、データと運用の境界まで確認する必要があります。
この記事の対象読者
次の課題を抱える企業や組織に向けた内容です。
- AIエージェントの精度改善が止まっている企業や組織
- 業務ハーネスを使ったAI評価を始めたい企業や組織
- Kubernetes上でAI基盤を運用する企業や組織
- 商用サンドボックスへの依存を減らしたい企業や組織
- コーディングエージェントを業務へ展開する企業や組織
Microsoft Researchが公開した軽量フレームワーク
Agent Lightning v1.0の概要
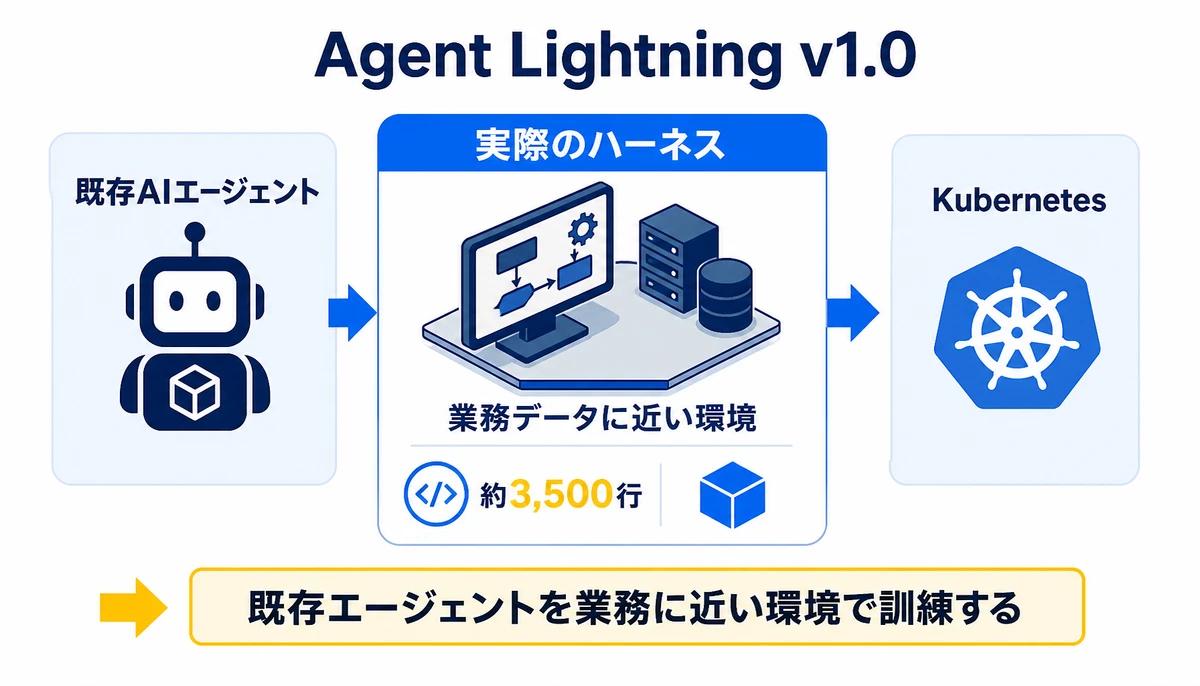
Microsoft Researchは2026年10月7日、AIエージェントを実際のハーネス上で訓練するオープンソースの軽量フレームワーク、Agent Lightning v1.0を公開しました。発表では、既存エージェントを業務に近い実行環境で改善する使い方が示されています。
同フレームワークは約3,500行で構成され、Kubernetesに対応しています。大規模な独自基盤を前提にせず、既存のエージェント開発へ組み込む軽さを打ち出した形です。
- 実際のハーネス上でエージェントを訓練する
- 商用サンドボックスに依存せず、業務データに近い環境を使う
- 既存エージェントを対象に改善を進める
- Kubernetes上で企業向けの運用構成を組みやすくする
SWE-benchによる評価結果
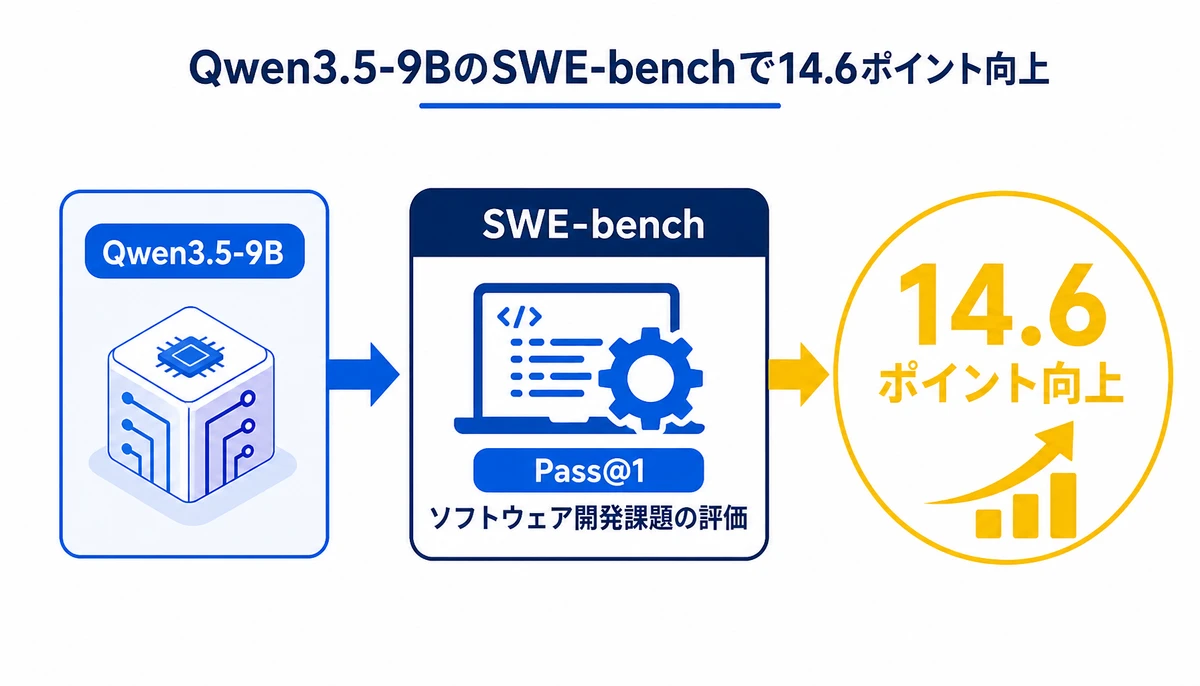
評価結果として、Qwen3.5-9Bを使った実験ではSWE-benchのPass@1が14.6ポイント向上したと報告されています。SWE-benchは、ソフトウェア開発の課題をエージェントが解く能力を評価するベンチマークです。

業務ハーネスが改善の起点になる
従来の改善との違い
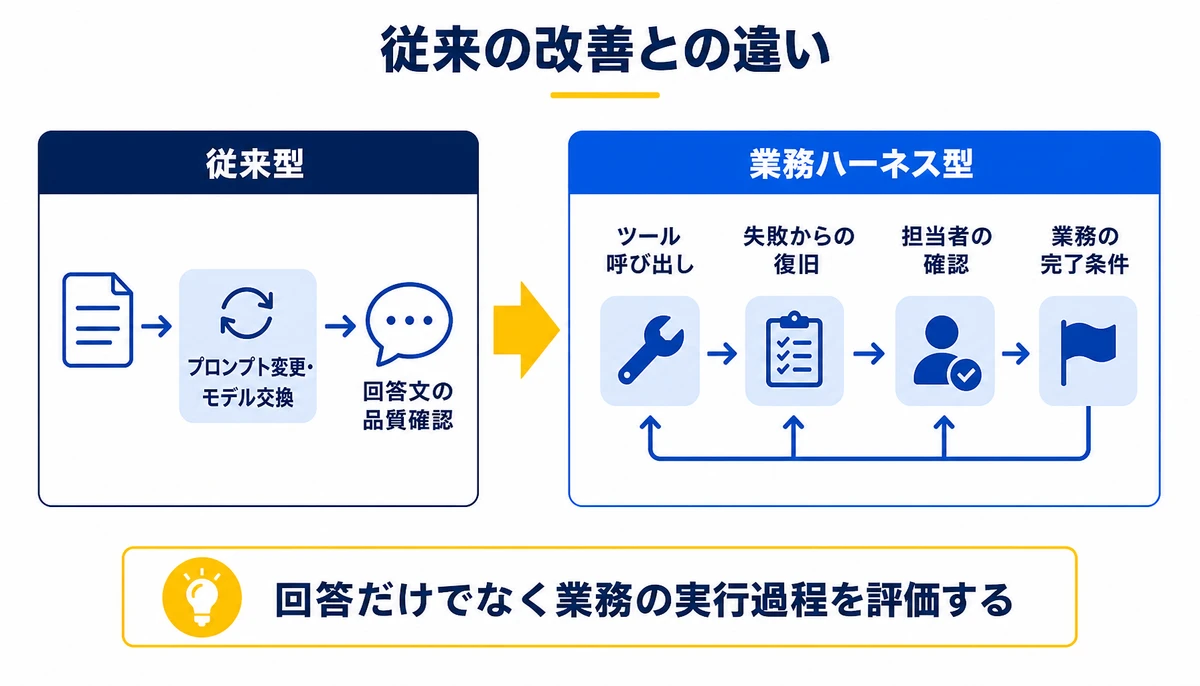
従来の改善では、プロンプト変更やモデル交換によって出力品質を確かめる流れが多く見られました。Agent Lightning v1.0は、エージェントがツールを呼び出し、作業を進め、結果を返す一連の実行環境を訓練に取り込もうとしています。
BinxAIが現場で見る限り、企業のエージェントは回答文だけで評価できません。権限の扱い、ツールの選択、途中での失敗、担当者による確認まで含めて、業務が完了したかを見なければ改善箇所を特定しにくい状況です。
- 入力された依頼を正しく分類できたか
- 許可されたツールだけを選択したか
- 途中の失敗から安全にやり直せたか
- 担当者の確認を必要な場面で求めたか
- 業務の完了条件を満たしたか
この方式を企業で試すなら、本番データをそのまま訓練へ渡すのではなく、匿名化や権限分離を含む検証用ハーネスを用意します。開発環境と本番環境を分け、同じ評価指標で結果を追える状態にしておくことが出発点です。
Kubernetes対応も、単に実行場所が増えるという話ではありません。ログ、ジョブの停止、モデルやデータへのアクセス権限を、既存の運用ルールに沿って管理できるか。これが実務上の確認事項になるでしょう。
企業のAI開発に増える設計作業
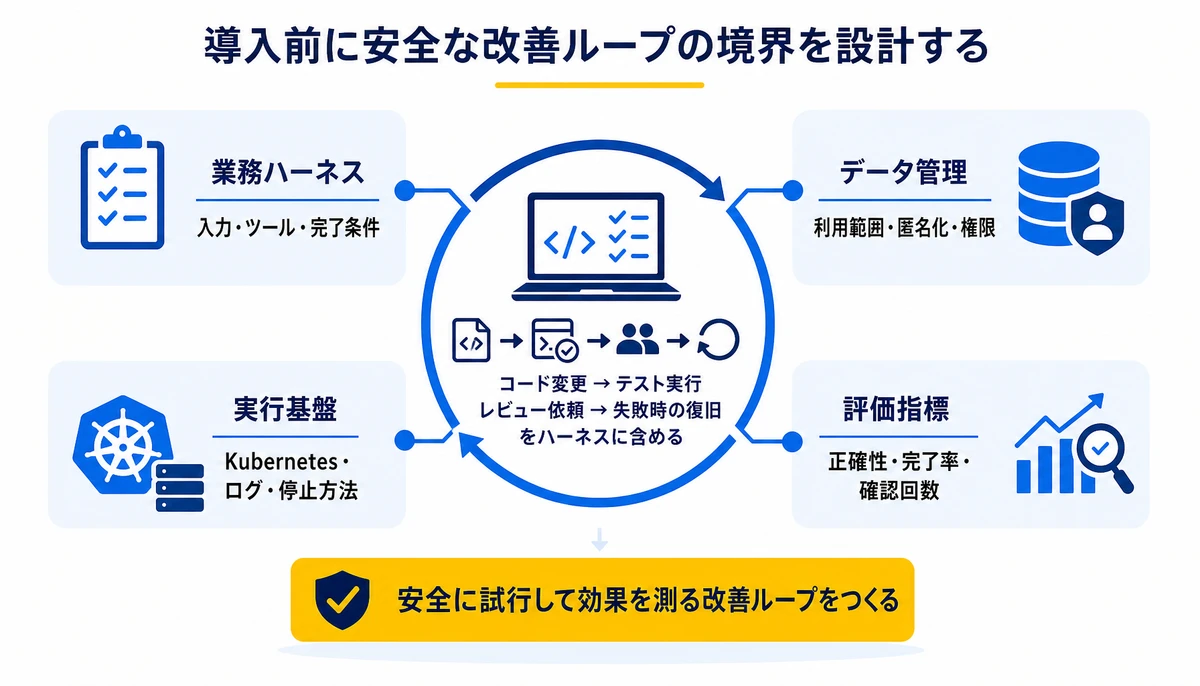
海外では、エージェント強化学習を実際の作業環境へ近づける動きが議論されています。BinxAIは、企業での適用ではフレームワークの導入より、改善に必要な業務データと評価の境界を決める作業が先に来るとみています。
たとえばコーディングエージェントなら、コードの変更だけでなく、テスト実行、レビュー依頼、失敗時の復旧までをハーネスに含めるのが基本。どこまで自動化を許すかを決めないまま訓練を始めると、精度が上がっても本番利用を止める場面が残ります。
| 設計対象 | 確認する内容 | 未整理の場合の問題 |
|---|---|---|
| 業務ハーネス | 入力、ツール、完了条件 | 評価結果を業務品質へ結び付けにくい |
| データ管理 | 利用範囲、匿名化、権限 | 訓練データの持ち出しを判断できない |
| 実行基盤 | Kubernetes、ログ、停止方法 | 障害時の責任範囲が曖昧になる |
| 評価指標 | 正確性、完了率、確認回数 | 改善の効果を継続して比べられない |
導入の焦点はAgent Lightningの採用ではなく、安全に試行して効果を測る改善ループです。そのループを作れるかが、モデル交換だけでは解けなかった停滞を動かす分かれ目。
自社で進める際に詰まりやすい箇所
- 業務ハーネスの完了条件を決められず、評価が回答の印象に偏る
- 本番に近いデータを使いたい一方で、訓練への利用範囲を整理できない
- Kubernetes上のログや権限を、既存の運用ルールと接続できない
外部の支援を使う場合は、フレームワークを先に導入するのではなく、現場の作業を分解して評価対象を決めます。開発用のハーネス、本番環境との境界、運用を引き継ぐ担当者まで同じ設計図に置くと、検証後の展開を判断しやすくなるでしょう。
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく詳細な見積を出し、契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進めるのが特徴です。
企画、課題整理、要件整理から開発までを同じ担当が受け持ち、内製化と社内定着まで支援します。Agent Lightningの検証では、業務ハーネスの設計から本番展開、運用の引き継ぎまでを一続きで扱えます。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Agent Lightning v1.0は何を改善するフレームワークですか?
既存のAIエージェントを、実際の実行環境や業務データに近いハーネス上で訓練し、改善するためのフレームワークです。新しいモデルへ交換するだけではなく、作業の進め方を評価対象にします。
約3,500行の軽量さは企業に何をもたらしますか?
大規模な独自基盤を前提にせず、既存のエージェント開発へ検証を組み込みやすくなる可能性があります。ただし、軽量であることだけでデータ管理や運用設計が不要になるわけではありません。
Kubernetes対応なら本番導入まで簡単に進められますか?
Kubernetesに対応していても、ログ、権限、停止手順、開発と本番の分離は別に設計します。既存の運用ルールと接続できるかを、検証段階で確かめる必要があります。
SWE-benchの14.6ポイント向上を自社の効果として見込めますか?
そのまま自社の効果として見込むことはできません。Qwen3.5-9Bを使ったSWE-benchの評価結果なので、自社業務のハーネスと完了条件で別途測定が必要です。
導入前に最初に決める項目は何ですか?
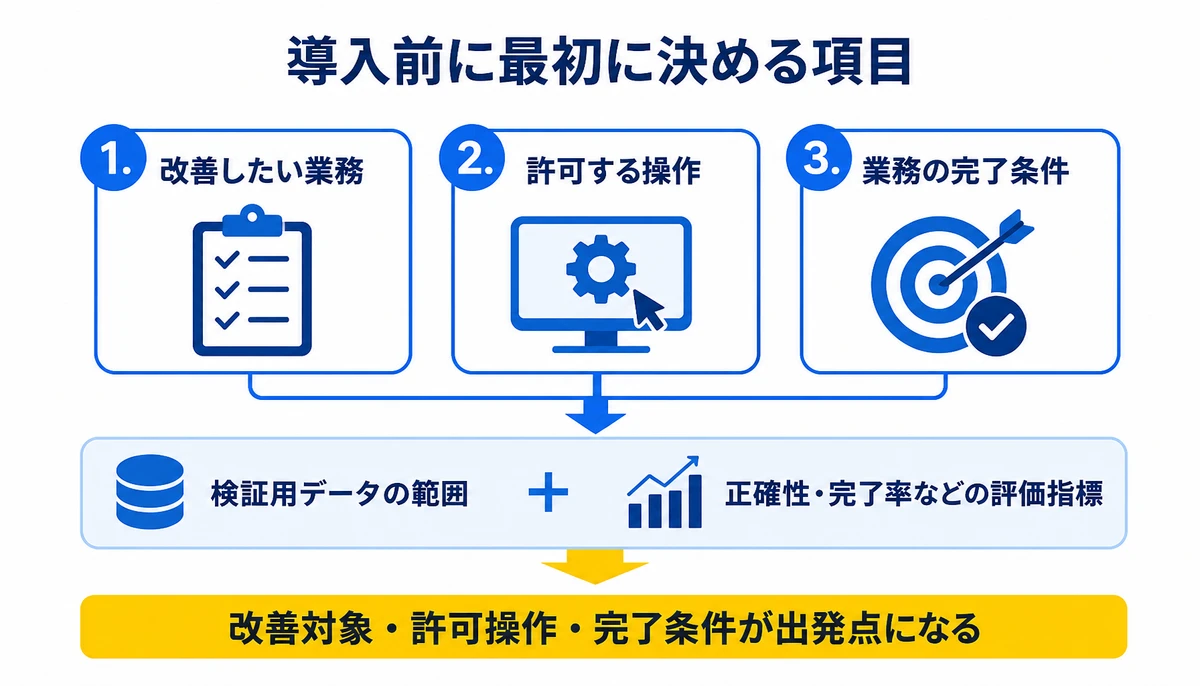
改善したい業務、エージェントに許可する操作、業務の完了条件の3点が出発点です。そのうえで、検証用データの範囲と、正確性や完了率などの評価指標を整理しましょう。
Agent Lightning v1.0は、AIエージェントを新しいモデルへ置き換える開発から、業務の実行過程を測って改善する開発へ視点を広げます。まずは1つの業務で安全なハーネスを作り、評価指標と運用の境界を確かめるところから始めるとよいでしょう。
本記事の情報は2026年10月10日時点で確認できる公開情報に基づきます。評価結果や対応範囲は環境によって異なるため、契約や導入の前に各社へ確認してください。記事内の情報は成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
AIエージェントが本番化できない企業がまず見直すべきデータ基盤の条件
AIエージェントのPoCを増やしても本番化できない企業では、モデル性能より先にデータ品質や権限、更新責任を点検する必要があります。RAGや業務システム連携を安定させるデータ基盤の設計項目と進め方を解説します。

AIエージェントを協調させる前に決めること。MCP・A2A・RAGの使い分けと権限設計
AIエージェントを1体動かせたあと、次に決めるのは技術の組み合わせと任せる範囲です。MCP・A2A・RAGをどう使い分けるか、自律度を上げる前にどこまで権限とログを設計しておくか。支援の現場で見てきた判断の順序を整理します。
83%が期待しても3%しか進めないAIエージェント展開の分岐点
AIエージェントへの期待が高まる一方、本番環境で大規模展開できる企業は限られます。データ基盤、権限設計、人材育成、効果測定をどう整え、限定領域でROIを検証するかを日本企業の導入支援の視点で整理します。















