
AIエージェントが本番化できない企業がまず見直すべきデータ基盤の条件
要約
AIエージェントのPoCを増やしても本番化できない企業では、モデル性能より先にデータ品質や権限、更新責任を点検する必要があります。RAGや業務システム連携を安定させるデータ基盤の設計項目と進め方を解説します。
「エージェントは動いたのですが、参照するデータがどこにあるのか誰も答えられません」。AIエージェントの相談で、この言葉を何度も聞いてきました。
この記事の対象読者
AIエージェントを導入する企業では、モデル選定だけでなく業務データの扱いも経営判断になります。次の立場で、PoCから本番化への条件を整理したい企業を想定しているでしょう。
- AI活用を検討している企業
- DX推進に取り組む企業
- 業務効率化を目指す企業
AIエージェントの導入よりデータ準備が遅れる理由
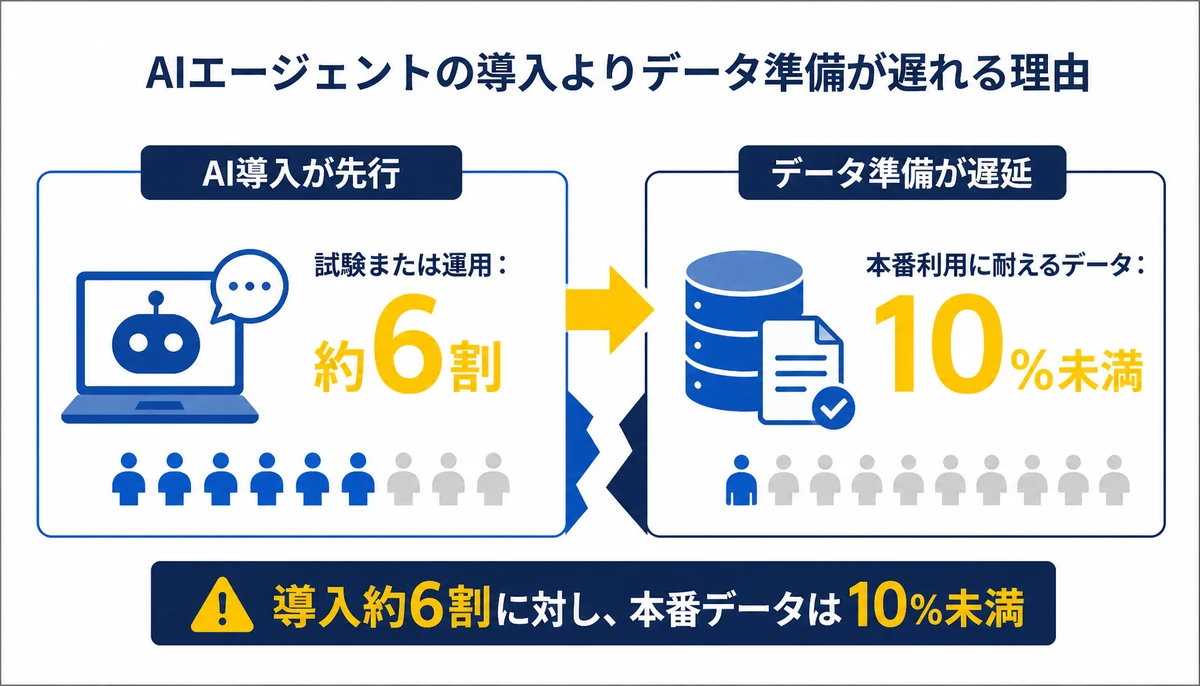
海外では、AIエージェントの導入は進む一方で、供給データの準備が遅れているというギャップが議論されています。Modern Data Companyの調査中間結果は、約6割がエージェントを試験または運用する一方、本番利用に耐えるデータは10%未満だったと示しています。
この数字をBinxAIは、モデルの推論性能だけでは本番化を説明できない兆候と見ているでしょう。エージェントが正しい文書を検索しても、古い規程や期限切れの顧客情報を使えば、業務結果は安定しません。
読者が先に確認すべきなのは、どのモデルが賢いかではありません。エージェントが参照または更新するデータを、業務の判断条件に照らして検証できるかどうかでしょう。
- 回答に使った情報の出典を確認できるか
- 情報がいつ更新されたかを追跡できるか
- 利用者ごとの閲覧範囲を制御できるか
- 誤った更新を取り消せるか

RAGと業務連携を本番化するデータ基盤の条件
RAGで見落としやすい品質の盲点
RAGは、検索した社内文書や業務データを生成モデルの回答材料にする構成です。検索精度だけを測ると、文書の正しさや権限まで確認したつもりになりやすい点は注意が必要でしょう。
参照と更新を分けて設計する
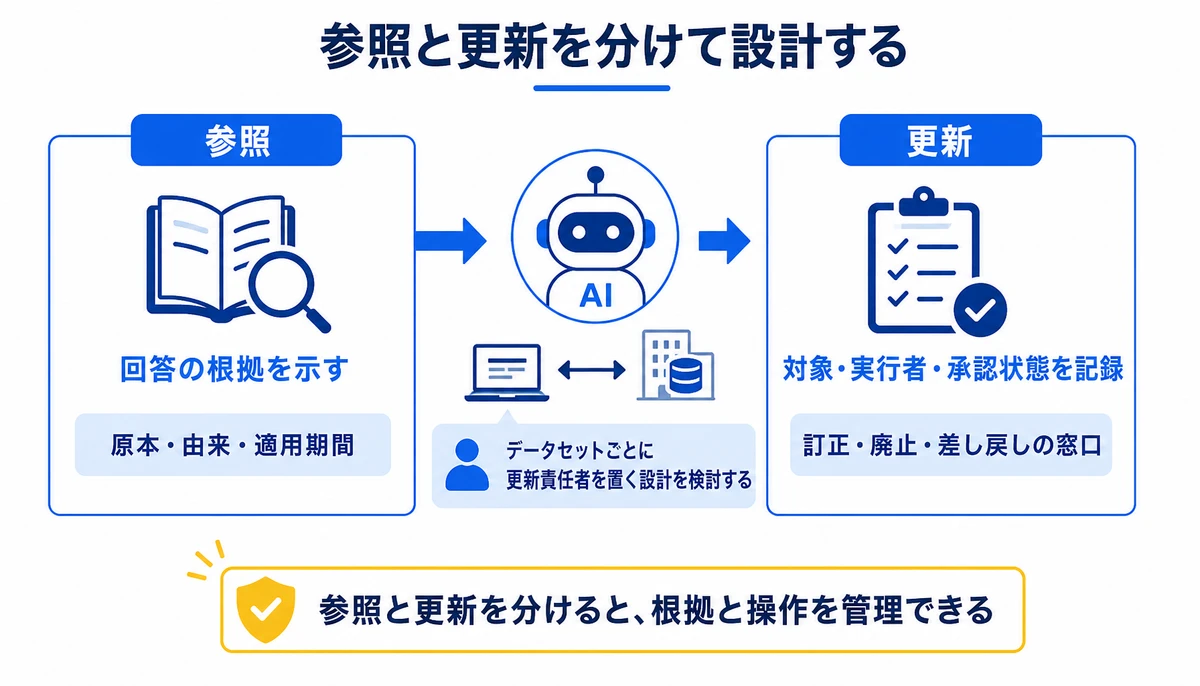
AIエージェントが業務システムを操作する場合は、参照と更新を分けて設計します。参照は回答の根拠を示し、更新は対象、実行者、承認状態を記録する仕組みにするのが基本です。
| 点検対象 | 確認する問い | 本番移行時の判断 |
|---|---|---|
| 品質 | 欠損や重複、表記揺れを把握できるか | 業務判断に許容できる誤りか |
| 鮮度 | 最終更新日と適用期間が分かるか | 期限切れ情報を除外できるか |
| 権限 | 利用者とデータの閲覧範囲を対応付けられるか | 権限外の検索結果を返さないか |
| 由来 | 原本と加工履歴を追跡できるか | 回答の根拠を業務側が確認できるか |
| 更新責任 | 訂正や廃止を誰が判断するか | 停止や差し戻しの窓口が決まっているか |
品質と権限は、同じデータ点検として扱わない方が整理しやすくなります。品質は内容の正しさを見るもの、権限は誰に何を見せるかを管理するものです。
BinxAIでは、データセットごとに更新責任者を置く設計を検討します。責任者はデータを作る人と同一でなくても構いませんが、訂正、廃止、適用期間の判断先は一つに定めることが前提です。
データ基盤の設計で見落としやすい5つの境界
文書の新旧混在が招く誤答リスク
AIエージェントのPoCでは、回答が自然なら成功と判定されることがあります。本番で問われるのは、回答の自然さではなく誤ったデータを使ったときの検知と停止の設計でしょう。
- 文書の最新版と旧版が同じ検索対象に残る境界
- 全社向け情報と個人情報が同じ格納先に入る境界
- 参照処理と更新処理が同じ権限で動く境界
- マスターデータと担当者のメモを同じ根拠として扱う境界
- 業務変更後も更新担当が決まらない境界
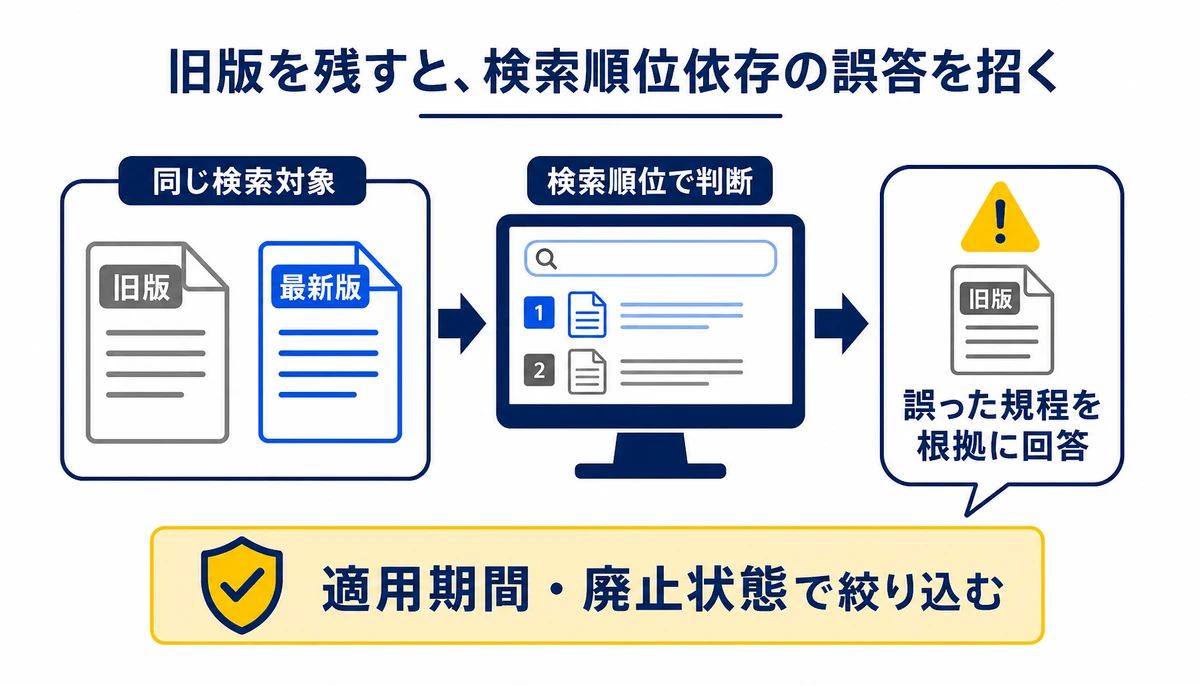
特に危険なのは、文書を追加すれば知識が増えるという考え方です。古い規程を残したまま新しい規程を追加すると、検索結果の順位だけで適用すべき情報を決めることになるでしょう。
更新処理に必要な確認・記録・復旧の流れ
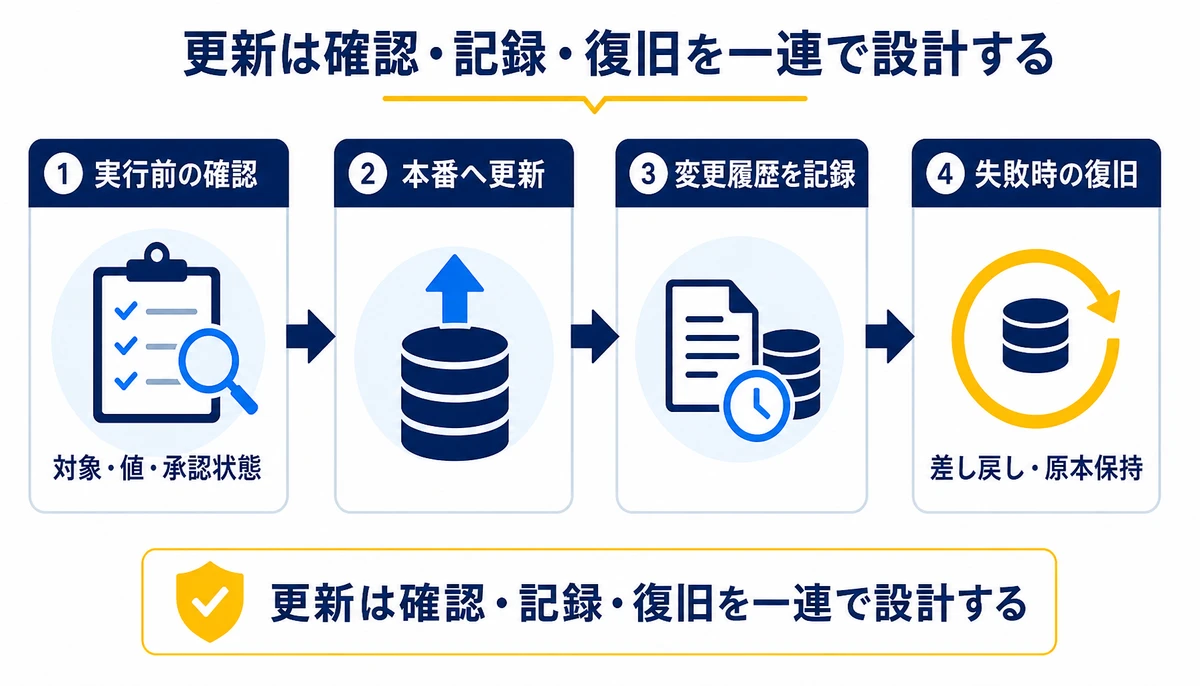
更新処理にも別の落とし穴があります。エージェントが受注情報や申請情報を書き換えるなら、実行前の確認、実行後の記録、失敗時の復旧を一連の手順にします。
| 場面 | 起こりうる問題 | 設計で置く制御 |
|---|---|---|
| 文書検索 | 旧版を根拠に回答する | 適用期間と廃止状態で絞り込む |
| 顧客照会 | 権限外の情報を取得する | 利用者属性と行単位の権限を照合する |
| 業務更新 | 誤った値を本番へ書き込む | 承認と差し戻しを分ける |
| データ訂正 | 訂正前の根拠が消える | 変更履歴と原本を保持する |
モデルの評価結果とデータ基盤の評価結果も分けて記録しておくと、モデルを変更したときにデータ品質の問題か推論の問題かを切り分けやすくなるでしょう。
PoCから本番化へ進むデータ基盤の実装手順
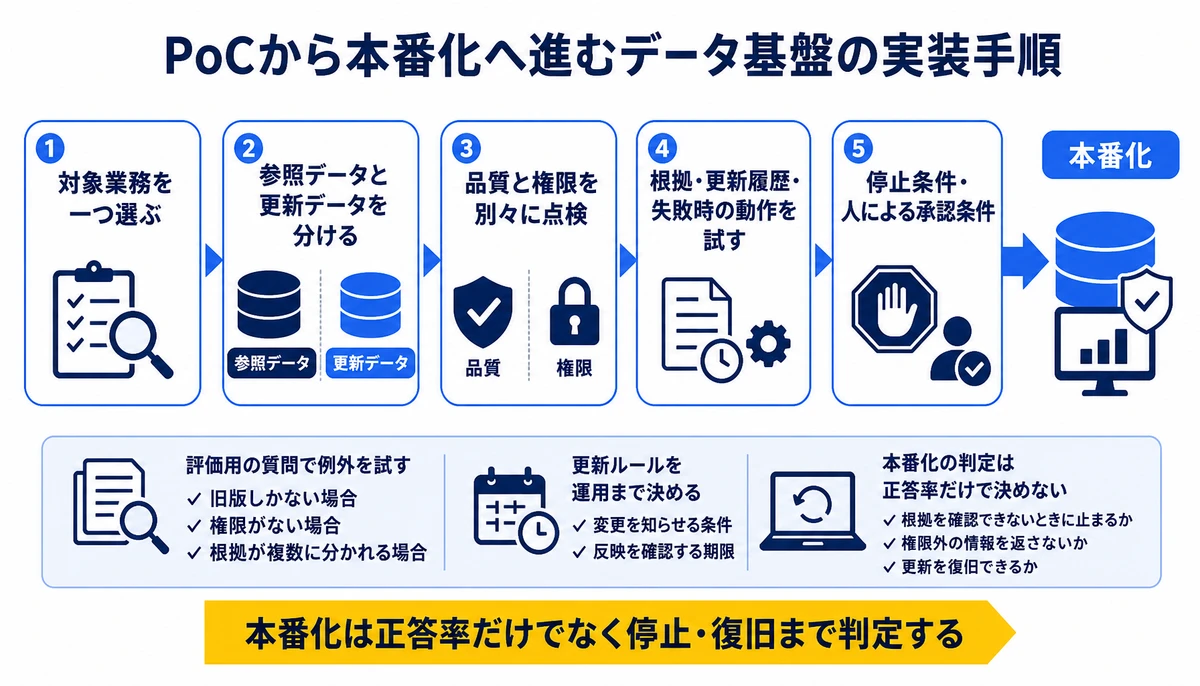
最初から全社データを整える必要はありません。対象業務を一つに絞り、その業務でエージェントが参照するデータと更新するデータを分けて棚卸しします。
- 業務の判断と作業を分解し、AIに任せる範囲を決める
- 参照データの原本、適用期間、更新責任者を記録する
- 品質と権限を別々の評価項目として点検する
- 回答だけでなく根拠、更新履歴、失敗時の動作を試す
- 停止条件と人による承認条件を決めてから本番化する
評価用の質問には、通常の問い合わせだけでなく例外も入れます。旧版しかない場合、権限がない場合、根拠が複数に分かれる場合を試すと、基盤側の不足が見えるでしょう。
更新ルールは、システム設定だけで終わらせません。業務部門が変更を知らせる条件と、データ責任者が反映を確認する期限を決めます。
業務: 契約書の確認
参照データ: 契約書原本、改定履歴
更新責任者: 法務部門の指定者
権限: 担当案件の契約情報のみ
停止条件: 根拠不一致、期限切れ、権限判定不能
承認: 更新処理は担当者の確認後に実行本番化の判定は、回答の正答率だけで決めません。根拠を確認できないときに止まるか、権限外の情報を返さないか、更新を復旧できるかを確認します。

自社で進めるか外部に頼るかを分ける判断
自社で進める場合は、モデル開発より先に業務データの棚卸しを担当できる体制が必要です。実際には、次の境界で作業が止まる企業が多いとBinxAIは見ています。
- 同じ文書に複数の更新部門があり、正本を決められない
- 権限表が人単位で管理され、システムと対応していない
- データ訂正の責任者が決まらず、評価用データも固定できない
外部の支援を使うと、業務の棚卸しとデータ基盤の設計を別々に発注せず、同じ計画で進めやすくなります。要件変更を前提に、評価表や更新ルールを運用へ落とせるかを確認してください。
BinxAIのみっちゃくんは、課題の整理と現状の診断から本番環境への展開までを同じ担当が受け持ちます。提案の前に現場へ入って要件を固めます。そのうえで詳細なお見積りをお出しするため、一式いくらの発注にはなりません。
- 課題の整理と現状の診断。提案の前に現場へ入って行います
- 要件定義と設計。何を作るかを決めるところから受け持ちます
- 開発と本番環境への展開。動くだけでなく、使われる状態まで進めます
- 運用の引き継ぎと内製化の支援。社内で回せる形にします
- 担当者向けの研修。定着するまで一緒に進めます

よくある質問
AIエージェント導入前にデータ基盤を全面刷新すべきですか?
全面刷新から始める必要はありません。対象業務を一つ選び、参照、更新、権限、更新責任を追跡できる範囲から整えます。
RAGの検索精度を上げれば本番化できますか?
検索精度だけでは判断できません。根拠の適用期間、利用者の権限、原本との関係、情報がない場合の停止動作も確認します。
データ品質と権限はなぜ分けて点検するのですか?
品質が高いデータでも、閲覧権限がなければ返してはいけません。逆に権限が正しくても、古い情報なら業務判断を誤るためです。
データ責任者は情報システム部門に置くべきですか?
一律に決めるのではなく、業務上の正しさを判断できる部門を軸にします。情報システム部門は連携や権限を支え、業務部門は内容と更新条件を担う分担が考えられるでしょう。
本番移行の停止条件には何を入れますか?
根拠不一致、期限切れ、権限判定不能、更新失敗が候補です。停止後に誰が確認し、どの記録を残して再開するかまで決めてください。
海外ではAIエージェントの導入が先行し、データの本番準備が追いつかない状況が議論されています。BinxAIが現場で見てきた範囲では、品質、権限、由来、鮮度、更新責任を業務単位で分けて確認すると、モデル性能に隠れた課題を切り分けやすくなります。
まず、対象業務を一つ絞り込み、その業務で参照するデータの責任者を一人決めるところから始めてください。
本記事の内容とサービス情報は2026年8月20日時点のものです。料金や提供内容は変更される場合があるため、契約前に各社へご確認ください。記載した支援内容や導入成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
83%が期待しても3%しか進めないAIエージェント展開の分岐点
AIエージェントへの期待が高まる一方、本番環境で大規模展開できる企業は限られます。データ基盤、権限設計、人材育成、効果測定をどう整え、限定領域でROIを検証するかを日本企業の導入支援の視点で整理します。

LLM比較2026年版:GPT・Claude・Gemini・DeepSeekをポートフォリオで使い分ける
「最強モデル探し」はもう終わった。2026年のLLM選定は、RAG・エージェント・コーディング・社内文書検索という4ユースケースに対し、コスト・ガバナンス・統合コストの三軸で複数モデルを使い分けるポートフォリオ設計に移行している。日本企業特有の制約を踏まえた実践的な選定フレームワークを解説する。

AIエージェントを協調させる前に決めること。MCP・A2A・RAGの使い分けと権限設計
AIエージェントを1体動かせたあと、次に決めるのは技術の組み合わせと任せる範囲です。MCP・A2A・RAGをどう使い分けるか、自律度を上げる前にどこまで権限とログを設計しておくか。支援の現場で見てきた判断の順序を整理します。















