
Mercury 2.5の並行生成で変わるLLM選定 業務データで精度と速度を比べる方法
要約
Inceptionが発表したMercury 2.5は、複数トークンを並行生成して修正する拡散モデルです。毎秒1107トークンの意味を整理し、定型業務での適用可能性と精度・待ち時間・コストの比較方法を解説します。
生成AIの選定では、これまで回答の正確さや自然さが中心に語られてきました。そこへ、文章を並行して生成するMercury 2.5が登場しています。
Inceptionが示した毎秒1107トークンという数字は、単なるベンチマークにとどまりません。大量処理や対話サービスでは、待ち時間と処理量が運用費や利用体験に結びつきます。
この記事の対象読者
Mercury 2.5を新しいモデルとして見るだけでなく、自社の処理単位で比べたい読者に向けた内容です。
- 大量の文書をAI処理したい企業
- 応答速度が業務品質に直結する企業
- LLMの推論コストを見直したい企業
- チャットや音声サービスを運営する企業
- 新しいAIモデルを比較検証したい組織
Inceptionが発表したMercury 2.5
発表の経緯と基本仕様
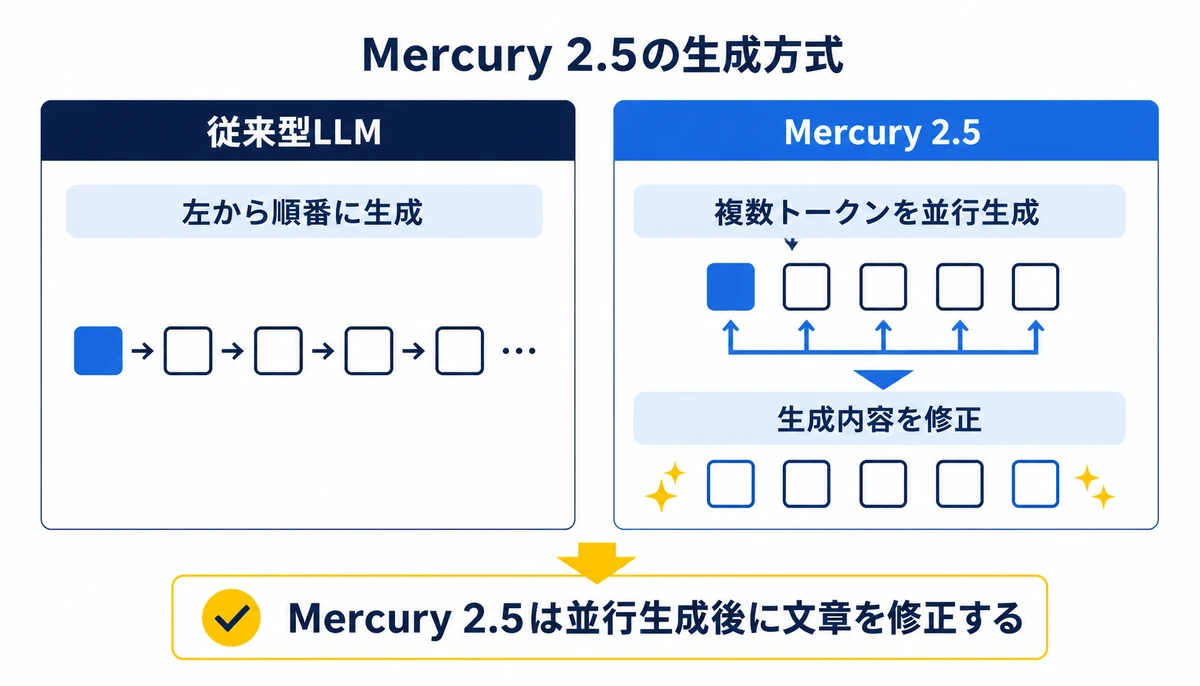
AI企業Inceptionは2026年9月8日、拡散モデルを使う文章生成モデル「Mercury 2.5」を発表しました。これは、GIGAZINEが2026年9月9日に報じた内容です。
一般的なLLMは、文章を左から右へトークン単位で生成します。Mercury 2.5は複数のトークンを並行して生成し、その後に内容を修正する仕組みを採用しています。
- 従来型LLMは、生成済みの文章を踏まえて次のトークンを順番に出力します。
- Mercury 2.5は、複数の位置を並行して生成する方式を取ります。
- 生成した内容を修正する工程によって、文章全体を整える設計です。
- Inceptionは生成速度として毎秒1107トークンをうたっています。
速度の数字を読むときの注意点
ここでいう毎秒1107トークンは、InceptionがMercury 2.5について示した生成速度です。入力条件、出力長、接続環境、同時実行数が異なる場合、実際の処理時間も変わるでしょう。

並行生成が変えるLLMの評価軸
従来型との処理の違い
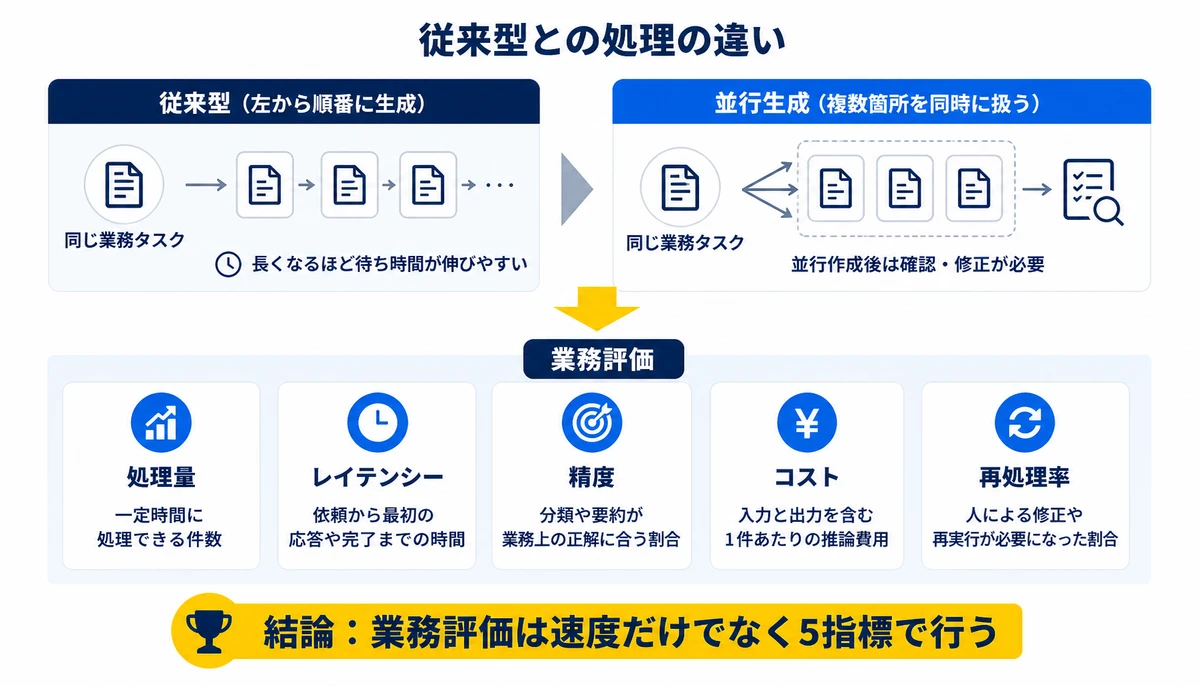
左から順番に生成する方式では、文章の長さが増えるほど出力完了までの待ち時間が伸びやすくなります。並行生成では複数箇所を同時に扱うため、文章生成の進め方そのものが別物です。
ただし、並行して作った文章を修正する工程では、速さと引き換えに確認方法が必要になるかもしれません。業務で使う場合は、最終回答だけでなく修正後の品質を測ります。
- 処理量、一定時間に何件を処理できるか
- レイテンシー、依頼から最初の応答や完了までの時間
- 精度、分類や要約が業務上の正解に合う割合
- コスト、入力と出力を含む1件あたりの推論費用
- 再処理率、人による修正や再実行が必要になった割合
見かけの速度より業務の完了時間を見る
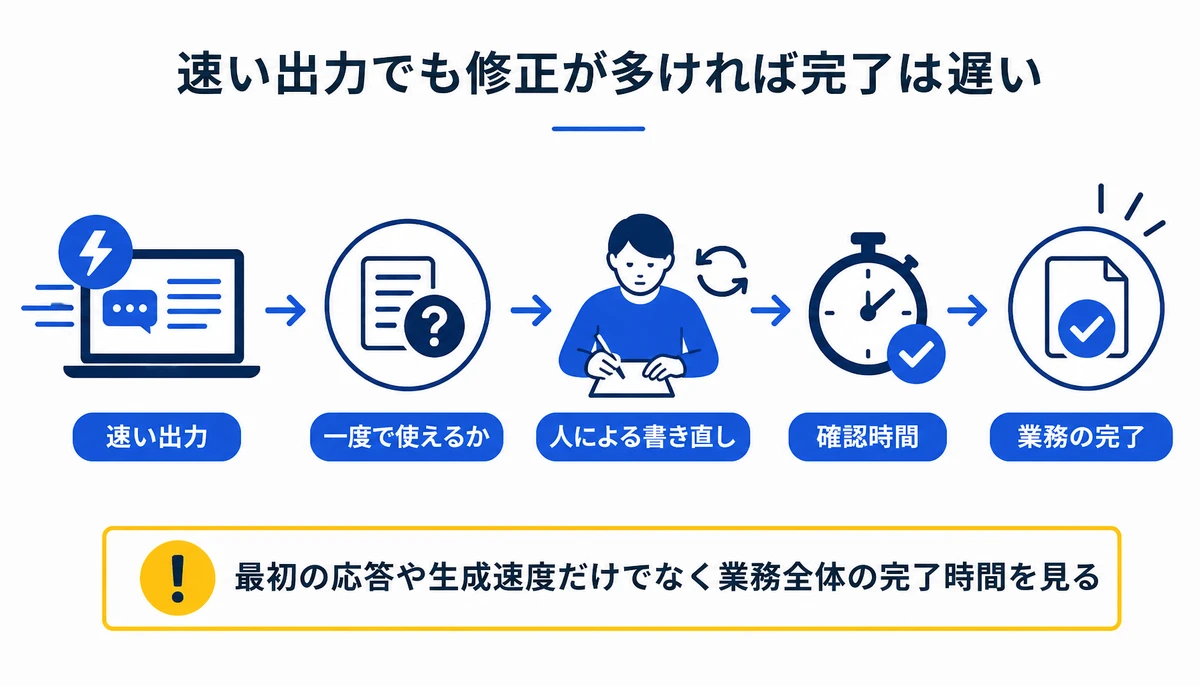
BinxAIが現場で見る範囲では、モデルの回答が一度で使えるかどうかが、見かけの速度より業務の処理時間を左右することがあります。
速く出ても、人が毎回書き直すなら効果は変わりません。
定型業務での適用可能性
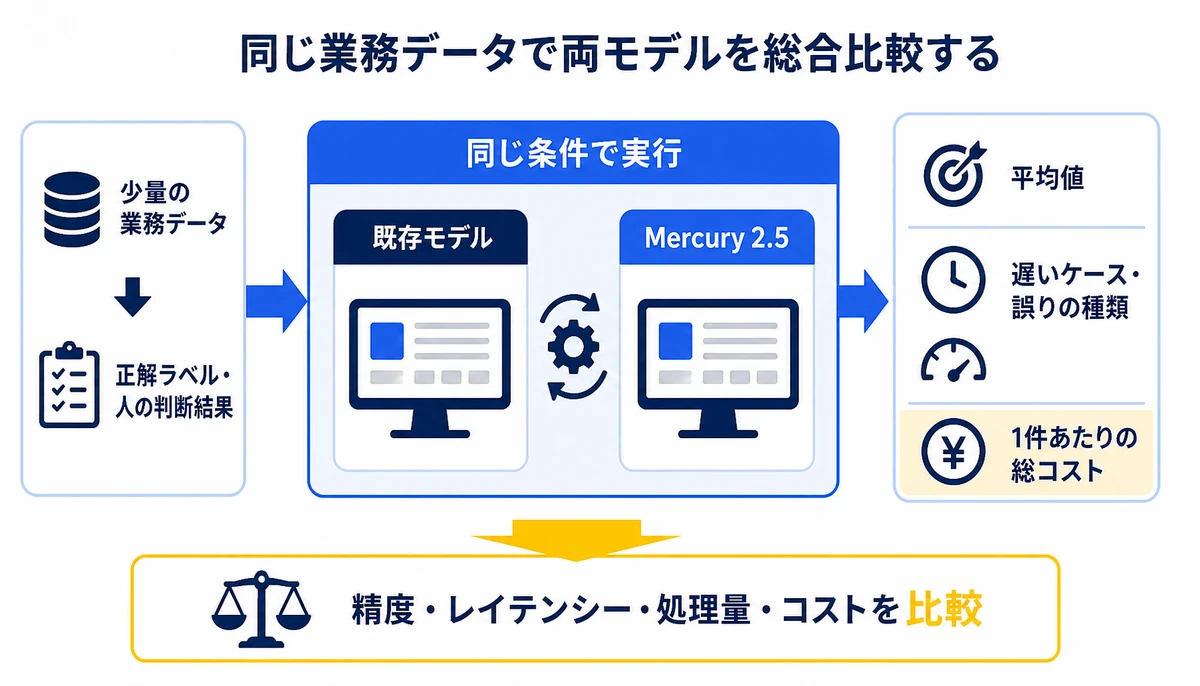
Mercury 2.5のような方式は、1件の長い回答よりも、同じ形式の処理を大量に繰り返す業務で検討しやすいでしょう。速度の差を、処理待ち時間や担当者の確認時間として把握できるためです。
- 問い合わせ文をカテゴリへ振り分ける分類
- 議事録や申請書から要点を抜き出す要約
- 社内ルールに沿った定型返信の下書き
- 音声サービスで受けた内容の短い応答生成
- 大量の文書を条件別に並べ替える前処理
最初の検証では、業務データを少量だけ選びます。正解ラベルや人の判断結果を用意し、既存モデルとMercury 2.5で同じ処理を実行してください。
比較結果は、平均値だけでなく遅いケースや誤りの種類も確認します。特に定型文では、禁止表現の混入や必須項目の欠落を別に数えると判断しやすくなります。
| 確認項目 | 測り方 | 判断の例 |
|---|---|---|
| 精度 | 正解ラベルや人の判定と照合 | 誤分類や必須情報の欠落を確認 |
| レイテンシー | 依頼から出力完了までを計測 | 利用者が待てる時間内か確認 |
| 処理量 | 一定時間に完了した件数を記録 | 繁忙時間帯の処理に足りるか確認 |
| コスト | 入力・出力と再処理を含めて算出 | 1件あたりの費用を既存方式と比較 |
モデルの新しさではなく、業務の1件を最後まで処理した結果で比べることが出発点です。
社内検証で詰まりやすい箇所
条件が揃わないまま進むリスク
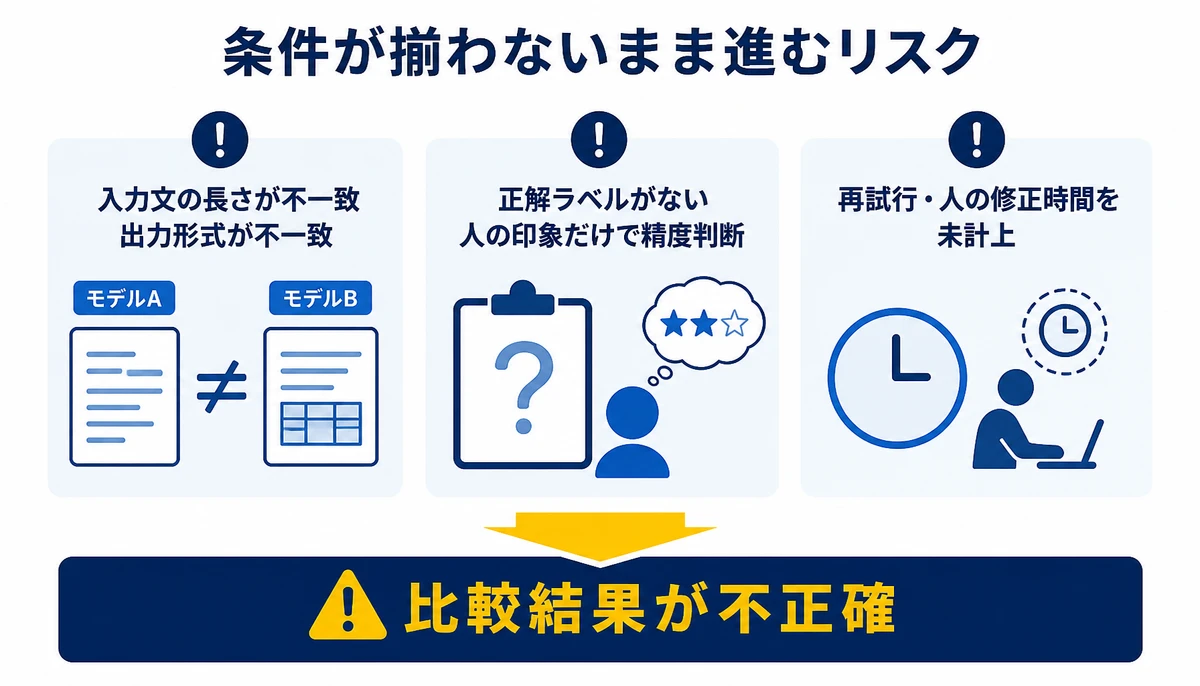
自社だけで検証を始めると、速度の測定条件と正解データの作り方が揃わないことがあります。
処理後に人がどこを直したかも記録しないと、モデルの違いを判断しにくくなるでしょう。
- 入力文の長さや出力形式がモデルごとに揃っていない
- 正解ラベルがなく、精度を人の印象だけで判断している
- 再試行や人の修正にかかった時間をコストへ含めていない
外部支援で整理できること
外部の支援を使う場合は、モデルを決める前に現場の処理と評価条件を整理できます。BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めるのが特徴です。
一式いくらという見積ではなく、要件を整理したうえで詳細な見積を出します。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められるでしょう。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持つ体制です。運用の引き継ぎや内製化、担当者向けの研修まで含めて進められます。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Mercury 2.5は従来型LLMと何が違いますか?
一般的なLLMがトークンを左から順番に生成するのに対し、Mercury 2.5は複数のトークンを並行生成して修正します。文章を作る順序が異なる点が特徴です。
毎秒1107トークンなら必ず業務が速くなりますか?
必ず速くなるとは限りません。入力と出力の長さ、同時実行数、再処理、人による確認時間を含めて測定し、業務全体の完了時間で判断します。
どのような業務から試すとよいですか?
分類、要約、定型文生成のように、正解や評価基準を用意しやすい処理から始めると比較しやすいでしょう。大量処理や待ち時間が課題の業務も候補になります。
精度とコストはどう比較しますか?
同じ入力データで出力を揃え、正解率だけでなく再処理と人の修正にかかる時間を記録します。推論費用にその作業負担を加え、1件あたりの総コストで比べるのがおすすめです。
新しいモデルを本番導入する前に必要な確認は何ですか?
業務上の誤りを分類し、許容できない出力を決めておきます。速度の測定条件、停止基準、既存モデルへ戻す手順も事前に用意してください。
Mercury 2.5は、文章生成を順番処理から並行処理へ広げるモデルとして発表されました。導入を検討する企業や組織は、毎秒1107トークンという数字だけでなく、精度、待ち時間、処理量、推論コストを同じ業務データで比較してください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Inception Mercury 3公開 高速LLMは業務で使えるか
Inception Labsが公開したMercury 3は毎秒1000トークン超を掲げる拡散型LLMです。速度だけで導入を決めず、日本語品質や同時実行数、実効コストを自社業務で比較する方法を整理します。
RAGの正解率が高くても危ない 再現率0.481が示す本番の盲点
RAGの回答が正しそうに見えても、検索段階で必要な条項や根拠を落とすと業務判断を誤るおそれがあります。適合率0.844と再現率0.481の差を起点に、長文文書の評価方法、検索設計、運用基準の作り方を整理します。
AIコスト管理 モデル単価から業務1件の実行単価へ切り替える方法
AI API料金やLLM料金比較をモデル単価だけで判断すると、推論量や再試行、提供事業者の速度と信頼性を見落とします。業務1件の完了費用を測る実効単価の設計、ログ項目、TCO試算、モデル選定の進め方を解説します。















