
Red Teaming Agentで変わる企業AIの評価方法
要約
MicrosoftのResponsible AI Standard再設計を手がかりに、AIエージェントのツール呼び出しや権限利用まで評価する方法を整理します。レッドチームの発見を調達基準、監査証跡、リリース判断、運用監視へ接続する実装手順と落とし穴を解説します。
この記事の対象読者
AIを業務へ広げるほど、開発部門だけで安全性を判断する形は扱いにくくなります。技術部門と業務部門、監査部門の判断をそろえたい方に向けた内容です。
- AIの開発と運用を統制したい企業
- AIエージェントの品質を継続評価したい企業
- AIリスクを監査可能にしたい企業
- 複数部門へAIを展開する企業
- AIガバナンスの国際標準を確認したい企業
Responsible AI Standard再設計の意味
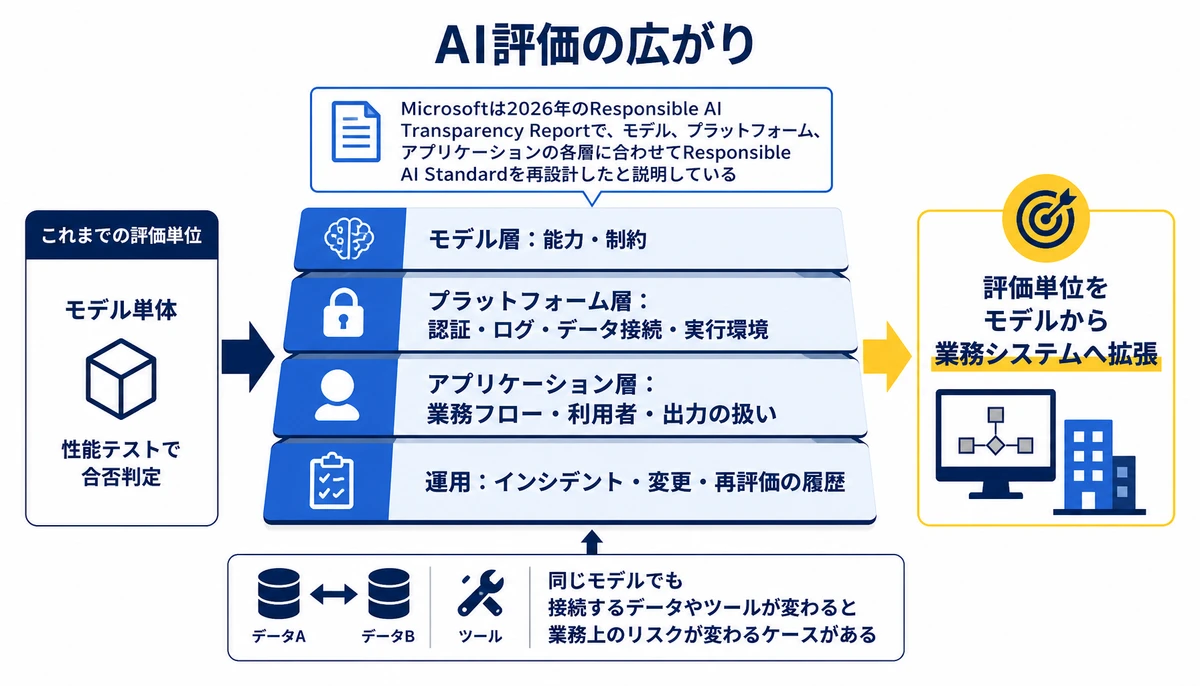
海外では、生成AIの安全性をモデル単体の性能試験だけで測れないという議論が広がっています。MicrosoftはResponsible AI Transparency Report(2026年)で、各層に合わせてResponsible AI Standardを再設計したと説明しています。対象となる層は、モデル、プラットフォーム、アプリケーションの3つです。
この動きは、AI評価を導入前の合格判定から、構成と利用条件を含む継続的な評価へ移すものとして読めます。
BinxAIが企業の現場を見てきた範囲では、同じモデルでも接続するデータやツールが変わると、業務上のリスクも変わるケースが多くあります。
日本企業がこの再設計から読み取るべき点は、Microsoftの標準をそのまま導入することではありません。自社のAIをどの層で管理し、誰がどの証跡を確認し、どの条件でリリースを止めるかを分解することです。
- モデル層、基盤モデルの能力や制約を確認する
- プラットフォーム層、認証、ログ、データ接続、実行環境を確認する
- アプリケーション層、業務フロー、利用者、出力の扱いを確認する
- 運用層、インシデント、変更、再評価の履歴を残す
評価の単位をモデルから業務システムへ広げると、AIガバナンスは開発部門だけの検査ではなくなります。

エージェント型AIの評価単位
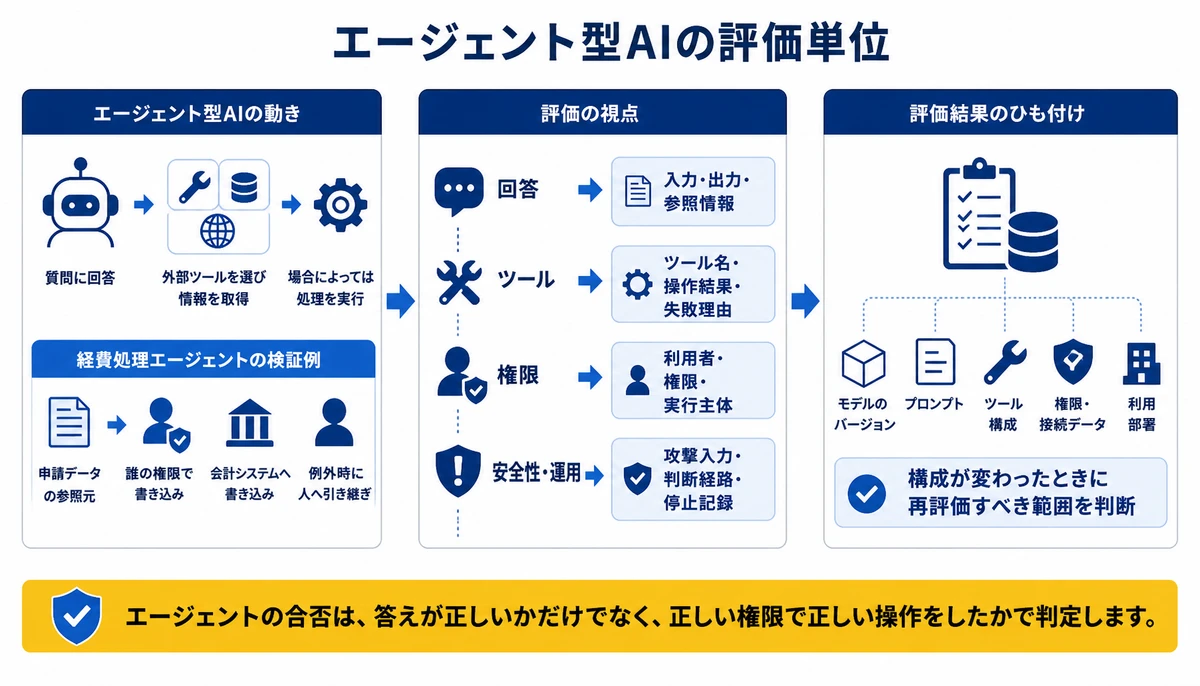
Microsoftは、エージェント型AIの普及とサイバーリスクを踏まえ、Responsible AIにおけるリスク管理の対象を拡張していると説明しています。エージェント型AIは、質問に答えるだけでなく、外部ツールを選び、情報を取得します。場合によっては処理を実行する点が、従来の生成AIと大きく異なります。
そのため、評価では最終回答の正確さを入口にしつつ、途中の判断と実行結果を追います。すべての項目を同じ重みで採点するのではなく、業務上の損失や復旧の難しさに応じて評価軸を分ける設計が現実的です。
- 回答、根拠の提示、禁止情報の出力を確認する
- ツール、呼び出し先、引数、実行順序を確認する
- 権限、参照可能なデータ、書き込み可能な範囲を確認する
- 目標逸脱、指示の乗っ取り、過剰な自律実行を確認する
- ログ、再現性、停止手段、担当者への通知を確認する
たとえば経費処理エージェントなら、承認規程に沿った回答だけでは足りません。申請データをどこから読み、誰の権限で会計システムへ書き込み、例外時に人へ引き継いだかまで検証します。
| 評価領域 | 確認する対象 | 記録する証跡 |
|---|---|---|
| 出力品質 | 正確性、根拠、禁止情報 | 入力、出力、参照情報 |
| ツール利用 | 呼び出し先、引数、実行順序 | ツール名、操作結果、失敗理由 |
| 権限管理 | 参照範囲、更新範囲、承認要否 | 利用者、権限、実行主体 |
| 安全性 | 指示の乗っ取り、目的逸脱、停止可否 | 攻撃入力、判断経路、停止記録 |
評価結果は、モデルのバージョンだけでなく、プロンプト、ツール構成、権限、接続データ、利用部署と結び付けます。構成が変わったときに再評価すべき範囲を判断しやすくなるためです。
エージェントの合否は、答えが正しいかだけでなく、正しい権限で正しい操作をしたかで判定します。
AIレッドチームの設計原則
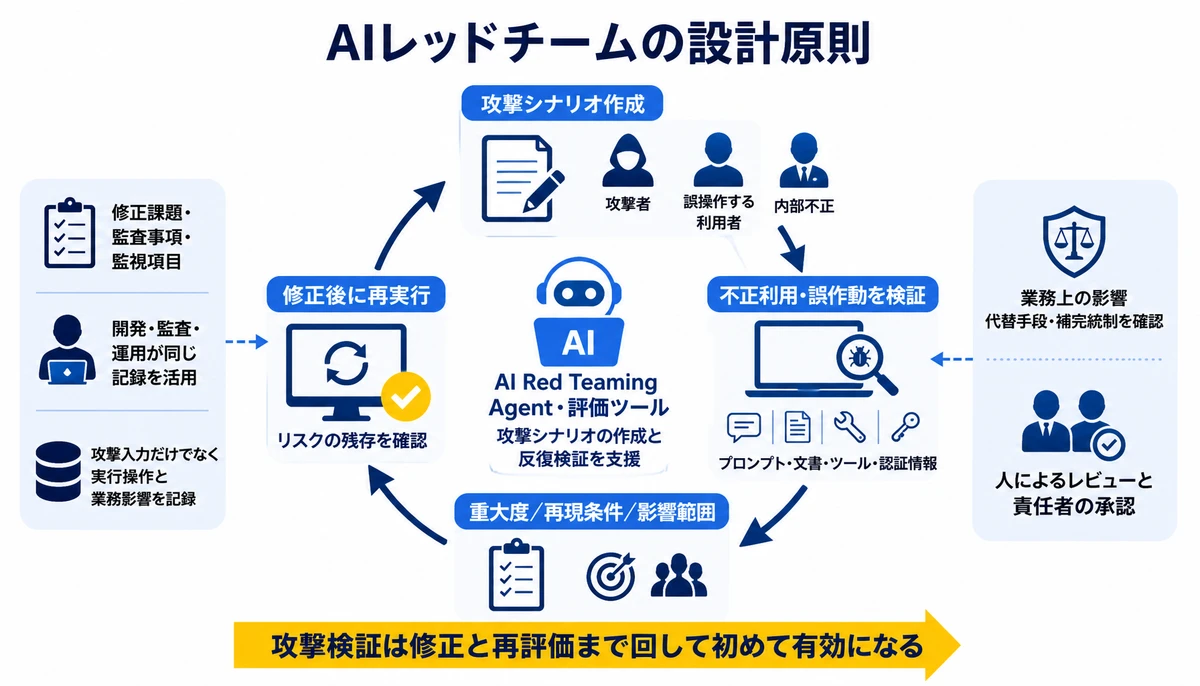
AIレッドチームは、意図的に不正利用や誤作動を試し、設計上の弱点を見つける評価活動です。MicrosoftはAI Red Teaming Agentや、エージェントを評価するためのツールを導入すると説明しています。
自動化された攻撃シナリオ生成は、検証の反復を助ける可能性があります。ただし、発見されたリスクを受け入れるか、修正をリリース条件にするかという判断まで、自動化に任せられるとは限りません。
- 攻撃者の立場、誤操作する利用者、内部不正の立場を分ける
- プロンプト、文書、ツール、認証情報の経路を分けて試す
- 単発の入力だけでなく、複数回の対話と状態変化を試す
- 検出結果を重大度、再現条件、影響範囲で分類する
- 修正後に同じシナリオを再実行し、リスクの残存を確認する
設計で陥りやすいのは、攻撃ケースの件数を増やすことが目的になる状態です。大量の結果が並んでも、業務影響や責任者が明確でなければ、リリース判断には使いにくい記録になるでしょう。
レッドチームの結果には、攻撃入力だけでなく、実行された操作と業務上の影響を添えます。開発者の修正課題、監査担当者の確認事項、運用担当者の監視項目を、同じ記録から導けるようになるためです。
開発と運用をつなぐ統制
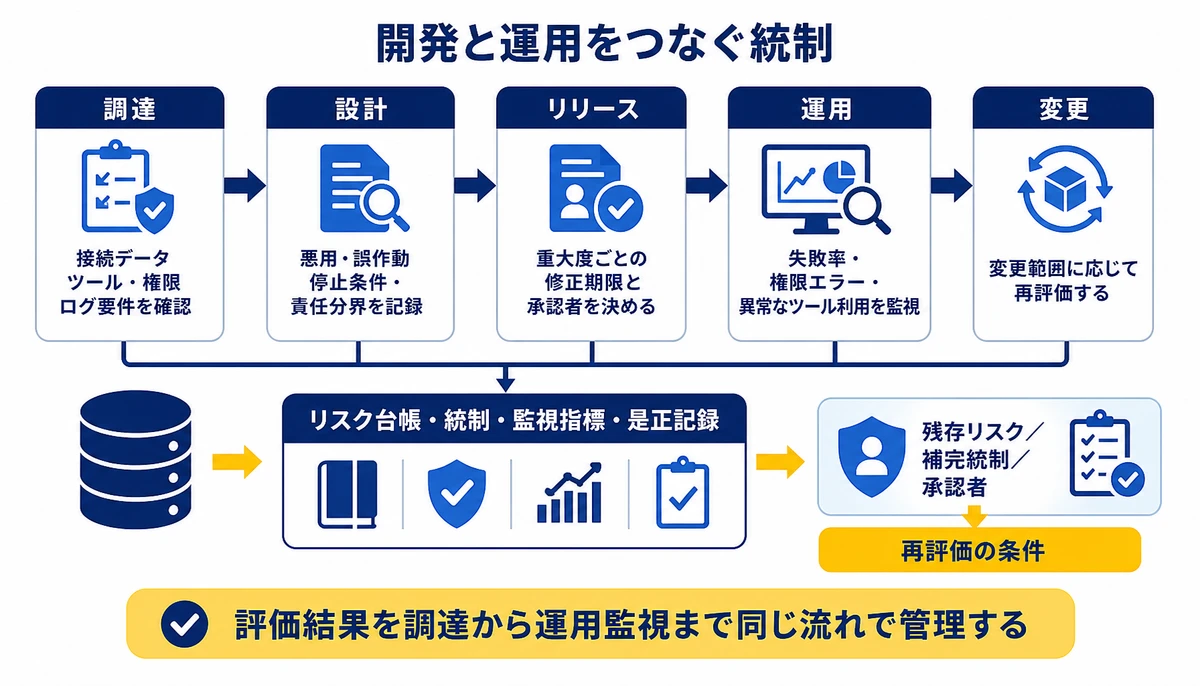
AI評価を継続させるには、検査を独立したイベントにしないことが必要です。調達時の要件、設計時の脅威分析、リリース時の承認、運用時の監視を同じリスク管理の流れに置きます。
ISO 42001のようなAIマネジメントシステムを参照する企業では、認証取得だけを目標にしない設計が求められます。レッドチームの結果をリスク台帳、統制、監視指標、是正記録へ接続できるかを確認しましょう。
- 調達、接続するデータとツール、権限、ログ要件を契約前に確認する
- 設計、想定する悪用、誤作動、停止条件、責任分界を記録する
- リリース、重大度ごとの修正期限と承認者を決める
- 運用、失敗率、権限エラー、異常なツール利用を監視する
- 変更時、モデルやツールの変更範囲に応じて再評価する
リリース判定には、合格という1語だけを置かない方法があります。残存リスク、適用範囲、補完統制、再評価の条件を並べると、経営層や監査部門も判断の前提を追いやすくなります。
対象構成: モデル / ツール / 権限 / 接続データ
攻撃シナリオ: 入力 / 前提条件 / 期待する防御
実行結果: 出力 / 操作 / エラー / ログ
リスク判断: 影響 / 重大度 / 残存リスク
対応記録: 修正内容 / 承認者 / 再評価条件運用中の監視では、回答品質の低下だけを追わないようにします。権限エラーの増加、通常と異なるツール呼び出し、停止操作の発生なども、再評価を始めるシグナルになり得ます。
レッドチームの成果は、発見件数ではなく、誰が何を直し、どの条件で再確認したかまで残って初めて統制に変わります。

自社実装で詰まりやすい境界
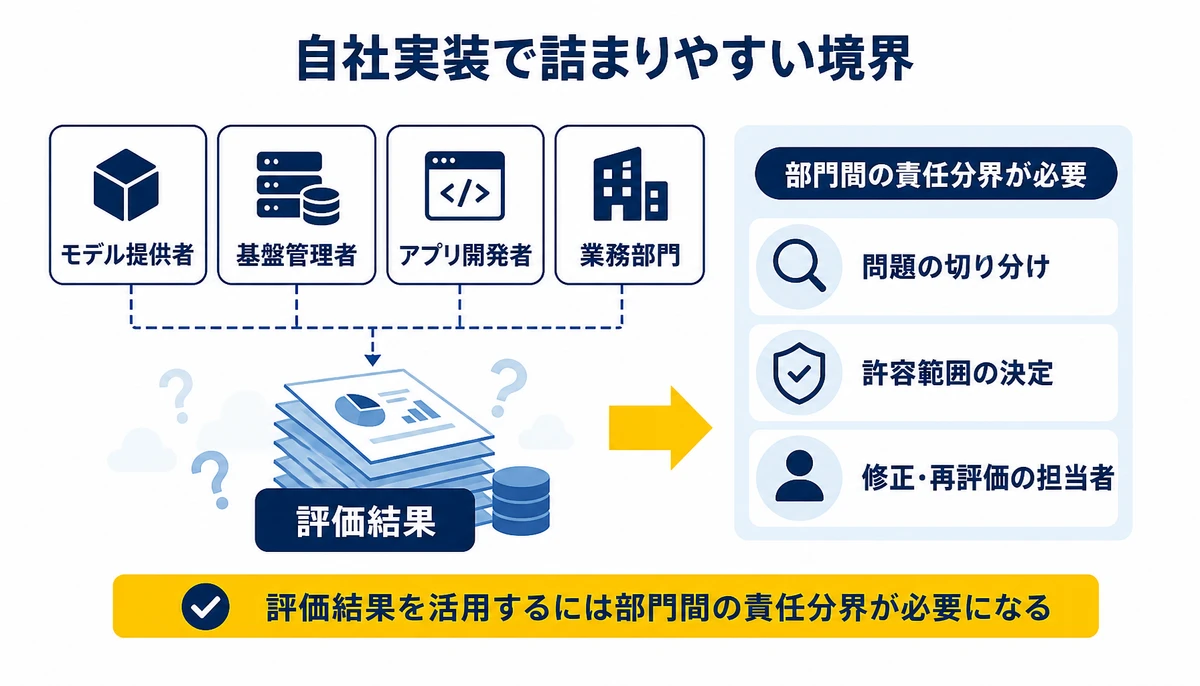
自社で評価を始めると、テスト技術より先に責任の境界で止まることがあります。モデル提供者、基盤管理者、アプリ開発者、業務部門のどこが判断するかを決めないまま、結果だけが蓄積される状態です。
- ツール呼び出しの失敗を、モデルの問題か連携設定の問題か切り分けにくい
- 権限の過剰利用を検出しても、業務部門が許容できる範囲を決めていない
- レッドチームの指摘を修正しても、再評価の条件と担当者が記録されていない
外部の支援を使う場合は、攻撃シナリオを増やすだけでなく、現行業務と接続構成を見たうえで評価範囲を定められるかを確認します。成果物の形式、承認者、運用への引き継ぎまで先に合意すると、検査後の空白を抑えられます。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。AIエージェントの評価でも、先に業務プロセス、接続システム、利用者権限を整理してから、検証する範囲を決めます。
見積は一式いくらという形にせず、要件を整理したうえで詳細を出します。契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進められる進め方です。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。本番環境への展開後は、運用の引き継ぎと内製化、担当者向けの研修まで支援します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
AIエージェントの評価は、回答品質の確認から実行権限と運用記録の確認へ広げて考えます。
Red Teaming Agentとは?
AIエージェントに対する攻撃シナリオの作成や評価を支援する仕組みです。MicrosoftはAI Red Teaming Agentや、エージェントを評価するためのツールを導入すると説明しています。自動化できる範囲と、人が判断する範囲を分けて設計しましょう。
通常のAIレッドチームと何が違いますか?
通常の生成AI評価では、回答の有害性や正確性を中心に確認することが多くあります。エージェント型AIでは、ツールの選択、引数、権限、実行順序、停止可否まで評価対象に加える考え方になります。
レッドチームの結果だけでリリースを判定できますか?
結果だけでは判定しにくいでしょう。検出されたリスクの影響範囲、発生条件、補完統制、修正予定、承認者を合わせて確認し、業務責任者が残存リスクを受け入れるか決めます。
モデルを変更しなければ再評価は不要ですか?
不要とは限りません。ツール、権限、接続データ、プロンプト、業務フローの変更でもリスクプロファイルは変わり得ます。変更記録と評価対象の対応表を作り、再評価の条件を先に定めましょう。
ISO 42001はAIエージェント評価にどう使いますか?
AIの管理体制を整理する枠組みとして参照し、レッドチームの結果をリスク台帳や是正記録へつなげます。規格の項目を埋めることだけでなく、評価、承認、監視、再評価が実際に回る状態を確認してください。
あわせて読みたい
MicrosoftのResponsible AI Standard再設計は、企業AIの評価をモデル単体からプラットフォーム、アプリケーション、運用まで広げる動きです。日本企業が取り組む際は、Red Teaming Agentの導入それ自体より、発見を調達、監査、リリース、監視の判断へ接続することが肝心です。
本記事のMicrosoftに関する内容は、2026年9月3日時点で公開されている情報に基づきます。各社の制度や提供内容は変更される場合があるため、契約や導入の前に各社へ確認してください。記事内容は特定の成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

AIガバナンス実装の実務:日本のソフトロー環境で今すぐ取るべき体制設計
罰則のないソフトロー環境だからこそ、AIガバナンスは競争優位に変えられる。EU・米国の外圧が日本企業のサプライチェーン要件を変えつつある今、経産省・総務省ガイドラインを起点に体制を先行設計するための4段階モデルと実務チェックポイントを解説する。

AIガバナンス体制は、3名の任命と既存会議体への統合から動かせる
「大企業向け」と思われがちなAIガバナンス体制を、最小コストで構築する実務フレームワークを解説。AI推進委員会の設置、利用ガイドラインの策定手順、PDCAサイクルの設計まで、組織・ルール・運用の3点セットを具体的に示す。

26件に1件が高リスク。生成AIプロンプトの情報漏洩、企業が今すぐ動くべき理由
Check Point Researchが2026年7月に公開した調査で、企業から送信された生成AIプロンプトの約3.9%(26件に1件)が機密情報漏洩リスクを含むと分かりました。生成AIを定期的に利用する組織の85%が高リスクプロンプトの影響を受けています。入力ルールの明文化からDLP連携まで、整備すべきガバナンス対策の全体像を解説します。















