
帳票と図面を外部APIへ送らないAI運用DeepSeek重み公開で広がる選択肢
要約
DeepSeek V4 Flash Vision Expの重み公開で、帳票や図面を外部APIへ送らずに検証する道が広がりました。GPU、推論基盤、日本語精度、ライセンスを確認し、オンプレミスAIを小さく試す進め方を整理します。
帳票や図面をAIで読み取りたい企業にとって、データを外部APIへ送ることは判断の壁になりやすい論点です。2026年8月31日、DeepSeek V4 Flash Vision Expの重み公開が報じられました。ローカルLLMやオンプレミスAIを検証する選択肢が増えたかたちです。
この記事の対象読者
次のような課題を抱え、マルチモーダルAIの社内利用を検討している企業や組織を想定しています。
- 機密画像をクラウドへ送れない企業や組織
- 図面や帳票をAIで処理したい企業や組織
- オンプレミスAIを検討している企業や組織
- 自社GPUでLLMを検証したい企業や組織
- APIとローカル運用を比較したい企業や組織
DeepSeek V4の重み公開
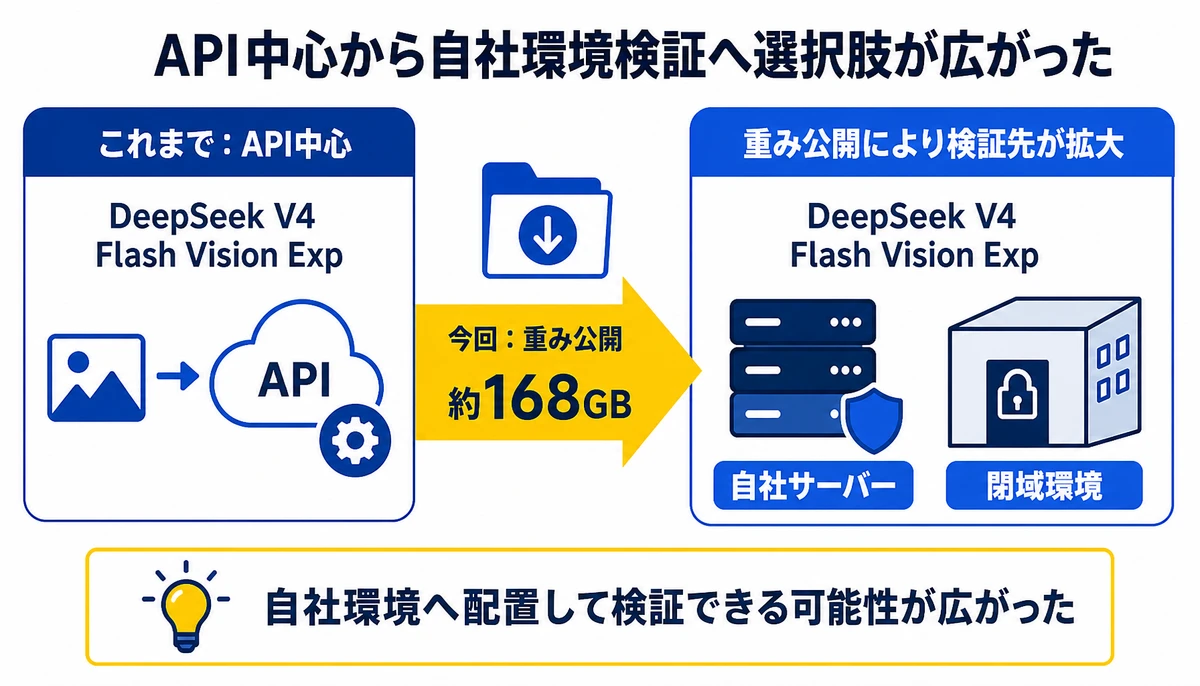
RuntimeWireは2026年8月31日、DeepSeekが重みを公開したと報じました。対象はDeepSeek V4 Flash Vision Expです。これまでAPI中心で提供されていたモデルを、自社環境へ配置して検証できる可能性が広がった形です。
NVIDIAの開発者フォーラムでも、このモデルがオープンウェイトとして公開されたことが取り上げられています。公開されたモデルは約168GBとされ、ダウンロード後の実行環境には相応の準備が必要です。
- 発表時期: 2026年8月31日
- 対象モデル: DeepSeek V4 Flash Vision Exp
- 提供形態の変化: API中心から重み公開へ
- 公開サイズ: 約168GBと報道
- 想定される検証先: 自社サーバーや閉域環境
APIで画像を送る以外の検証経路が示されたことが、今回のニュースの実務的な意味です。ただし、重みを取得できることと、現場で安定運用できることは同じではありません。

帳票と図面の適用範囲
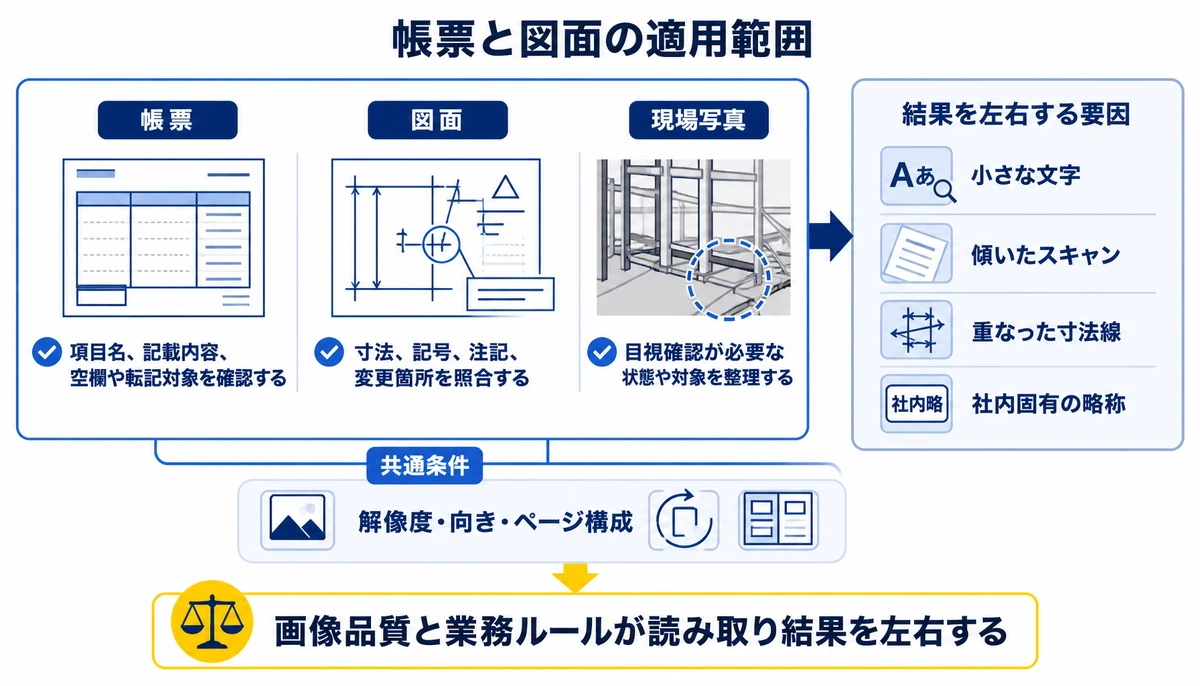
マルチモーダルAIは、文字だけでなく画像の内容も扱うAIです。帳票の項目確認、図面内の記号や注記の読み取り、現場写真の状態確認などが検証候補になるでしょう。
一方で、帳票や図面は画像品質と業務ルールに結果が左右されます。小さな文字、傾いたスキャン、重なった寸法線、社内固有の略称があると、回答の正しさだけでは判断しにくい場面も出てくるでしょう。
- 帳票: 項目名、記載内容、空欄や転記対象の確認
- 図面: 寸法、記号、注記、変更箇所の照合
- 現場写真: 目視確認が必要な状態や対象の整理
- 共通条件: 元画像の解像度、向き、ページ構成の標準化
検証では、正解が分かっている画像を少数選び、抽出結果と誤り方を記録。答えが合った件数だけでなく、見落としが業務上許されるか、確認者が修正できるかまで見ておくと判断しやすいでしょう。
GPUと推論基盤の確認
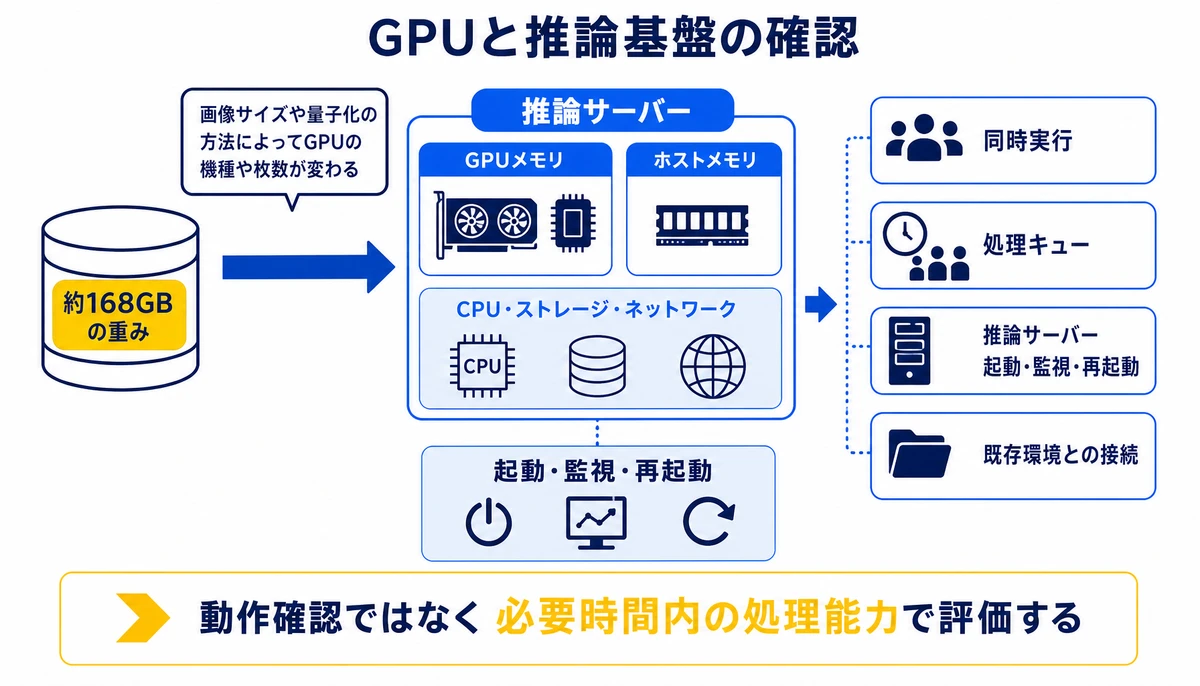
約168GBとされる重みを扱う場合、保存領域だけでなく、モデルを読み込むGPUメモリ、推論速度、同時利用者数を確認します。GPUの機種や枚数は、画像サイズや量子化の方法によって変わるため、想定する処理条件を先に決めておくことが出発点です。
- モデルを保持できるGPUメモリとホストメモリ
- 画像を前処理するCPU、ストレージ、ネットワーク
- 推論サーバーの起動、監視、再起動の方法
- 同時実行時の待ち時間と処理キュー
- 既存の文書管理や画像処理環境との接続方法
推論基盤とは、モデルへ入力を渡し、結果を返し、ログや障害を管理する実行環境です。モデル単体を動かす検証から業務利用へ進むと、認証、アクセス権、ログの保存、更新手順も必要になります。
自社GPUで動くかではなく、決めた時間内に必要な画像を処理できるかで評価します。1枚のデモが成功しても、月末に帳票が集中する場面や、複数人が同時に使う場面で待ち時間が増えるかもしれません。
日本語精度と利用条件
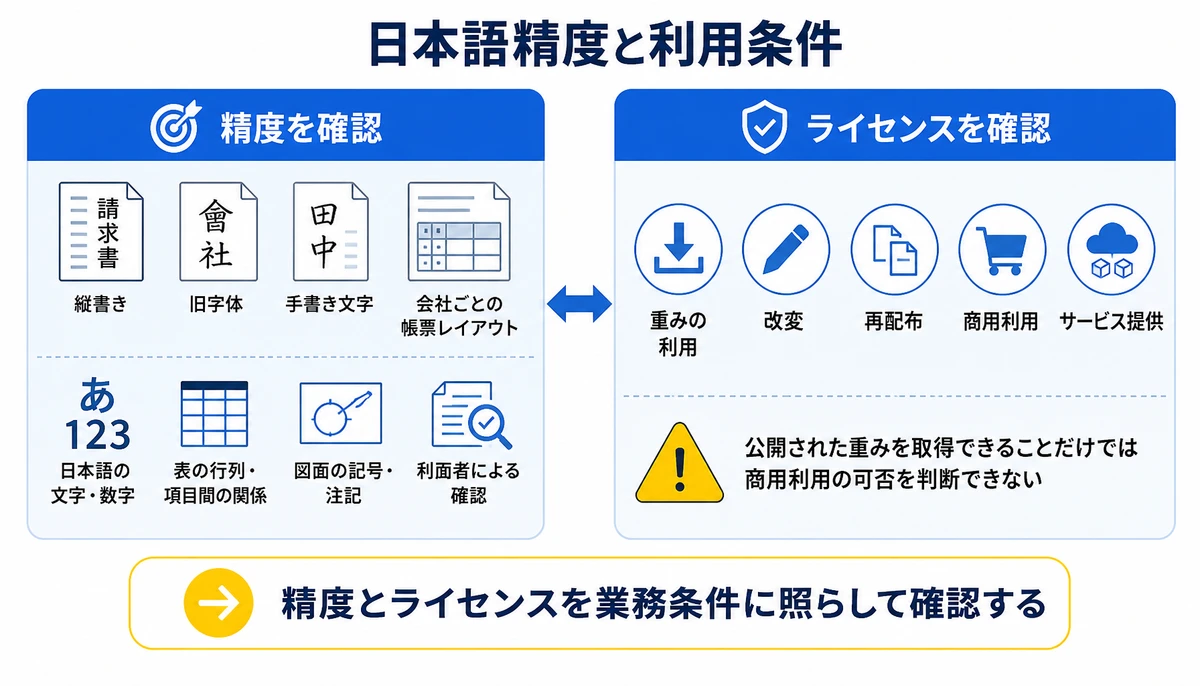
日本語の帳票では、文字認識だけでなく、項目の意味や表の構造を正しく捉える必要があります。縦書き、旧字体、手書き文字、会社ごとの帳票レイアウトを分けて評価すると、弱点を見つけやすいでしょう。
- 日本語の文字と数字を正しく抽出できるか
- 表の行列や項目間の関係を保てるか
- 図面の記号と注記を取り違えないか
- 誤読した結果を利用者が確認できるか
- 業務データを使う場合のライセンス条件に問題がないか
ライセンスは、重みの利用、改変、再配布、商用利用、モデルを組み込んだサービスの扱いを確認します。公開ページの説明だけで判断せず、自社の利用形態に当てはめて、必要なら専門家や提供元へ問い合わせを。

社内検証で詰まりやすい箇所
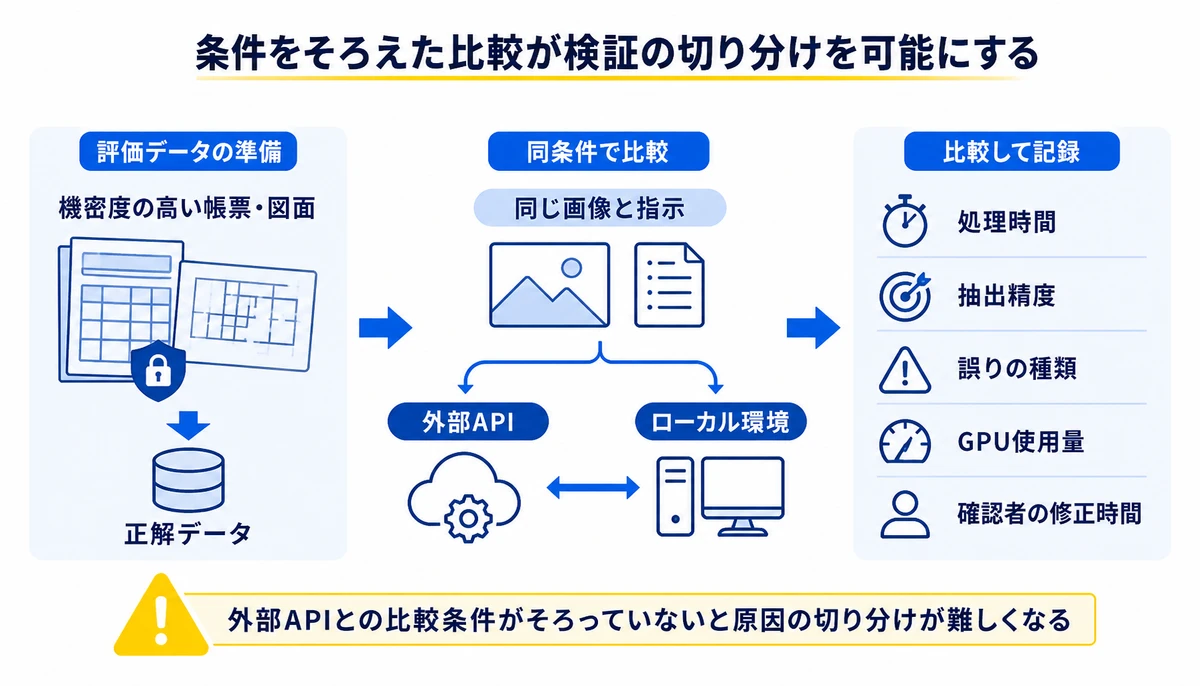
自社で試すときは、モデルの取得後に環境構築が止まりやすくなります。GPUの空き、推論基盤の選定、画像の前処理、日本語データの評価を別々に進めると、原因の切り分けが難しいでしょう。
- GPUの空き容量と処理速度を事前に確認できていない
- 帳票や図面を評価用データへ整理できていない
- 外部APIとの比較条件がそろっていない
- ライセンスを業務フローまで落として確認できていない
外部の支援を使うと、モデルを動かす作業だけでなく、評価対象の選定や運用条件の整理まで同じ計画に組み込めます。自社で残す作業と委ねる作業を先に分けておくと、検証後の引き継ぎも設計しやすいでしょう。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。帳票や図面の扱いでは、利用環境と評価条件を確認したうえで、必要な範囲を整理します。
見積は一式にまとめず、要件を整理した詳細な形で提示します。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められる進め方です。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。運用の引き継ぎ、内製化の支援、担当者向けの研修まで対応範囲に含めて進めます。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
DeepSeek V4はそのまま商用利用できますか?
公開された重みを取得できることだけでは、商用利用の可否は判断できません。ライセンス条件を確認し、自社の利用形態、改変、再配布、サービス提供への適用範囲を照合してください。
約168GBのモデルならGPUは何枚必要ですか?
必要なGPUの枚数は、GPUメモリ、精度設定、量子化、画像サイズ、同時実行数によって変わります。まずは想定する画像と処理時間を決め、実際の環境でメモリ使用量と待ち時間を測定してみましょう。
帳票の読み取り精度はAPIと同じですか?
同じモデル系列でも、前処理、推論設定、プロンプト、後処理によって結果は変わります。正解データを用意し、同じ画像と指示で外部APIとローカル環境を比較してください。
オンプレミスAIなら情報漏えいの心配はなくなりますか?
外部への送信を抑えやすくなりますが、社内のアクセス権、ログ、バックアップ、保守担当者の権限は別に管理します。画像を保存する場所と、推論結果を参照できる人も確認が必要です。
最初の検証では何を準備すればよいですか?
機密度の高い帳票や図面から、正解を確認できる少数の画像を選びます。処理時間、抽出精度、誤りの種類、GPU使用量、確認者の修正時間を記録すると、APIと自社運用を比べられます。
あわせて読みたい
参考・出典
DeepSeek V4 Flash Vision Expの重み公開は、帳票や図面を外部APIへ送らずにマルチモーダルAIを試す選択肢を広げました。導入を急がず、GPU、推論基盤、日本語精度、ライセンスを小規模な実データで確認するところから始めると、自社に合う運用像を描きやすくなります。
本記事の情報は2026年9月1日時点の公開情報に基づきます。モデルの提供条件、ライセンス、必要な環境は変更される可能性があるため、契約や導入の前に各社へ確認してください。本記事は特定の成果や導入効果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Geminiが動画を自律解析 コスト66%削減が企業にもたらす変化
Googleが発表したGemini Agentic Videoは、動画全体を一律に処理せず必要な場面を探して解析します。会議や店舗、製造現場での活用例と、コスト削減の前提になる保存・同意・人の確認工程を整理します。
既存Java資産にAIを組み込むJetBrains Koog 1.0入門
JetBrains Koog 1.0をPythonの代替ではなく、既存のKotlin・Java業務システムへAIエージェント処理を組み込む選択肢として整理します。構成、実装手順、認証やトランザクションの境界、本番前の評価項目を具体的に紹介します。
Red Hat llm-dでLLM推論コストは下げられるか
Red Hat llm-dとvLLMの役割を整理し、KVキャッシュ対応スケジューリングがLLM推論コストや応答速度に与える可能性を解説します。GPU利用率だけで判断せず、キャッシュヒット率、TTFT、キュー待ち時間、ピーク時レイテンシーを実測する導入手順と運用上の落とし穴も示します。















