
Red Hat llm-dでLLM推論コストは下げられるか
要約
Red Hat llm-dとvLLMの役割を整理し、KVキャッシュ対応スケジューリングがLLM推論コストや応答速度に与える可能性を解説します。GPU利用率だけで判断せず、キャッシュヒット率、TTFT、キュー待ち時間、ピーク時レイテンシーを実測する導入手順と運用上の落とし穴も示します。
この記事の対象読者
GPUを追加する前に、既存の推論基盤から得られる処理量を見直したい技術担当者に向けた内容です。モデル選定ではなく、分散推論の制御と実測に焦点を置きます。
- 自社環境でLLMを運用したい企業や組織
- GPU費用の増加に悩む企業や組織
- 生成AIサービスの応答速度を改善したい企業や組織
- プライベートクラウドをAI基盤に使う企業や組織
- LLM本番運用の構成を見直したい企業や組織
GPU追加だけでは解けない推論コスト
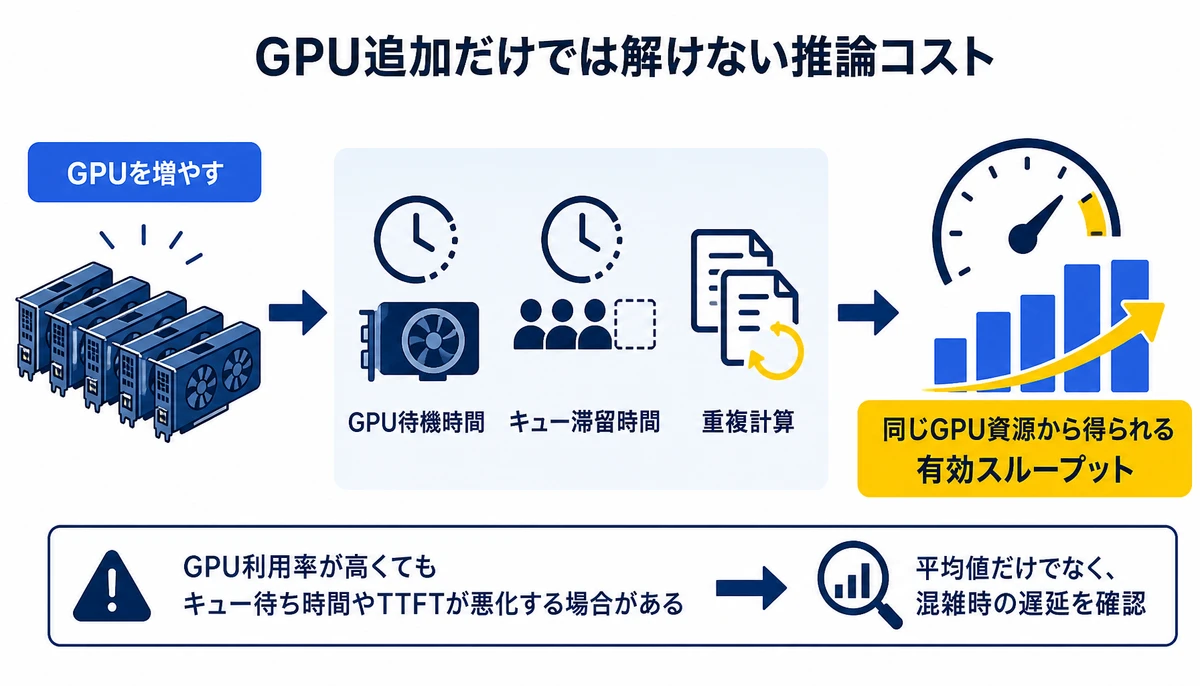
海外では、LLM推論の効率化をGPUの高速化だけでなく、推論リクエストの配置や状態再利用まで含む問題として議論する動きがあります。GPUを増やしても、処理待ちや重複計算が残れば、費用に見合う処理量を得られないかもしれません。
BinxAIが現場で見る範囲では、コストの議論がGPU単価やモデル料金だけに寄りやすい傾向があります。実際には、GPUが待機する時間、キューに滞留する時間、同じ長い入力を再計算する時間も、サービス全体の効率に影響します。
見るべき対象はGPUの台数ではなく、同じGPU資源から得られる有効スループットです。
- リクエストがどの推論インスタンスへ割り当てられたか
- 入力のどの部分が既存のKVキャッシュと一致したか
- プリフィルとデコードのどちらで時間を使ったか
- GPUが計算中か、メモリ待ちか、リクエスト待ちか
- ピーク時にSLOを満たせる同時実行数はいくつか

llm-dとvLLMの役割分担
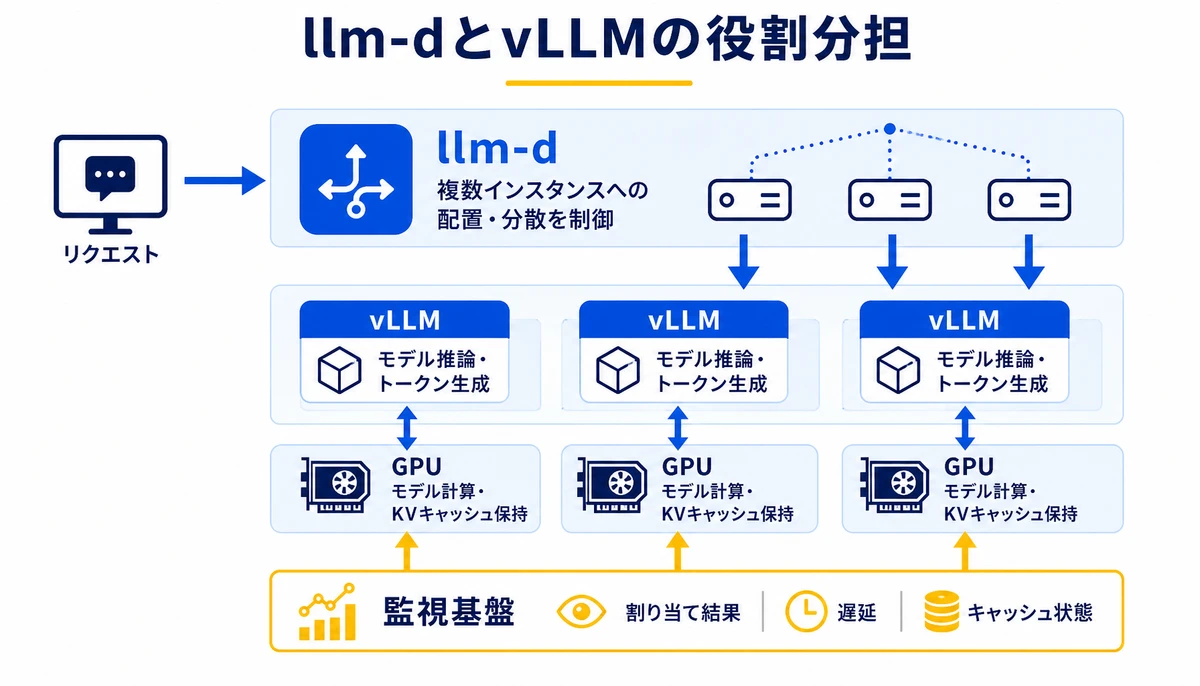
vLLMは、LLMの重みを読み込み、入力をトークン列へ変換し、生成処理を実行する推論エンジンです。GPUメモリの扱いやリクエストのバッチ処理など、1つの推論サーバー内部の効率化を担います。
llm-dは、複数のvLLMインスタンスを含む構成全体に対して、リクエストをどこへ送るかを考える層として整理できます。単純なラウンドロビンではなく、推論状態や負荷を判断材料にする点が、検討の出発点でしょう。
- vLLM、モデルを実際に推論し、トークンを生成する実行層
- llm-d、複数インスタンスへの配置や分散を制御する層
- GPU、モデル計算とKVキャッシュを保持する計算資源
- 監視基盤、割り当て結果と遅延、キャッシュ状態を観測する層
この分担を取り違えると、llm-dを導入すれば単体のvLLMが速くなると誤解しやすくなります。llm-dの検証では、実行エンジンの性能と、インスタンス間の割り当て効率を別々に評価します。
Red Hat AIの基盤にllm-dを組み込む場合も、既存のモデルサーバー、GPUオーケストレーション、認証、監視がそのまま適合するとは限りません。構成図では、実行層と制御層を分けて記載すると確認漏れを減らせます。
KVキャッシュを使う割り当てと測定指標
LLMの生成では、入力から得られた中間状態をKVキャッシュとして保持し、後続処理で再利用する考え方があります。長いシステムプロンプトや共通の文書を繰り返し使うサービスでは、状態の再利用が計算量に影響する可能性があるでしょう。
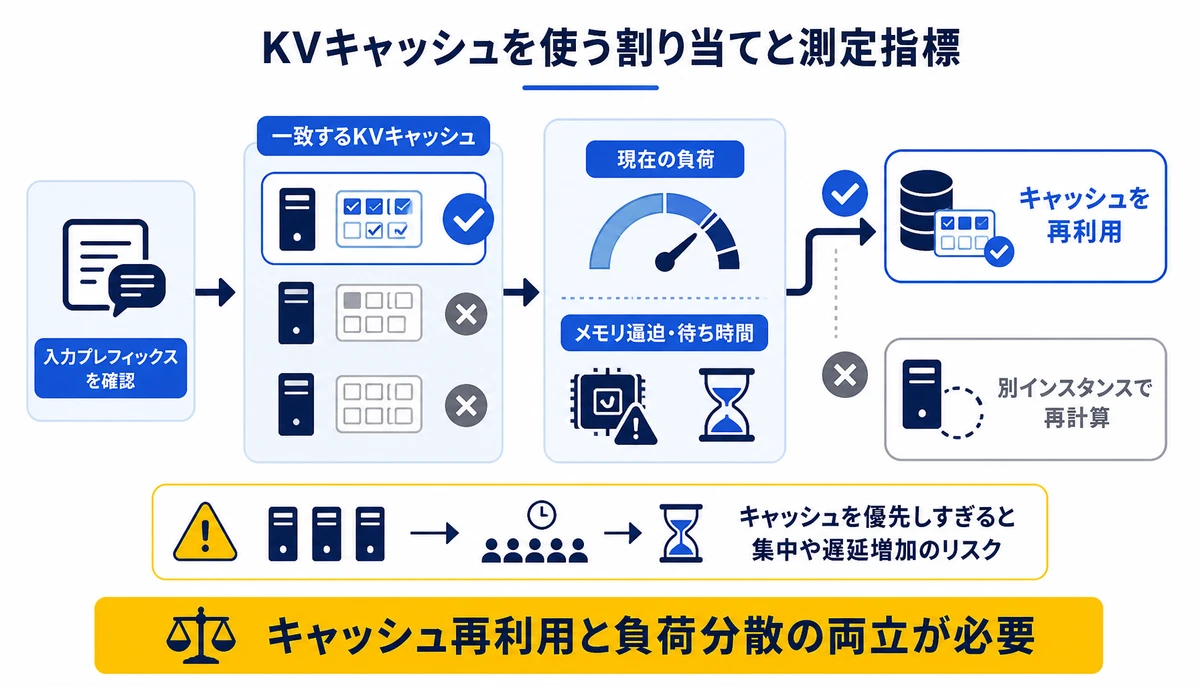
通常の分散では、空いているインスタンスへ送ることが優先されます。KVキャッシュを考慮する場合は、空き具合に加えて、必要な状態が残っているインスタンスかどうかを判断します。
- リクエストの入力プレフィックスを確認する
- 一致するKVキャッシュを持つインスタンスを候補にする
- キャッシュ再利用の効果と現在の負荷を比較する
- メモリ逼迫や待ち時間を考慮して送信先を決める
- 状態が利用できない場合は別インスタンスで計算する
ここでいう一致は、単に似た文章があるという意味ではありません。モデル、トークナイズ、並列化構成、入力の位置などが揃わなければ、期待した再利用にならないことがあります。
キャッシュを優先しすぎると、特定のインスタンスへリクエストが集中する可能性があります。再計算を避ける判断が、キュー待ちやメモリ不足によって全体の遅延を増やす場合もあるでしょう。
KVキャッシュ対応スケジューリングは、キャッシュを使えば必ず安くなる仕組みではなく、再利用と負荷分散の交換条件を制御する仕組みです。
キャッシュ効果を左右する条件
- 共通する入力プレフィックスがどれほど継続的に現れるか
- キャッシュを保持できるGPUメモリ容量があるか
- リクエストが同じモデルと並列化構成に届くか
- インスタンスの再起動や更新で状態が失われないか
- キャッシュを優先した結果、負荷が一部へ偏らないか
測定で分ける6つの指標
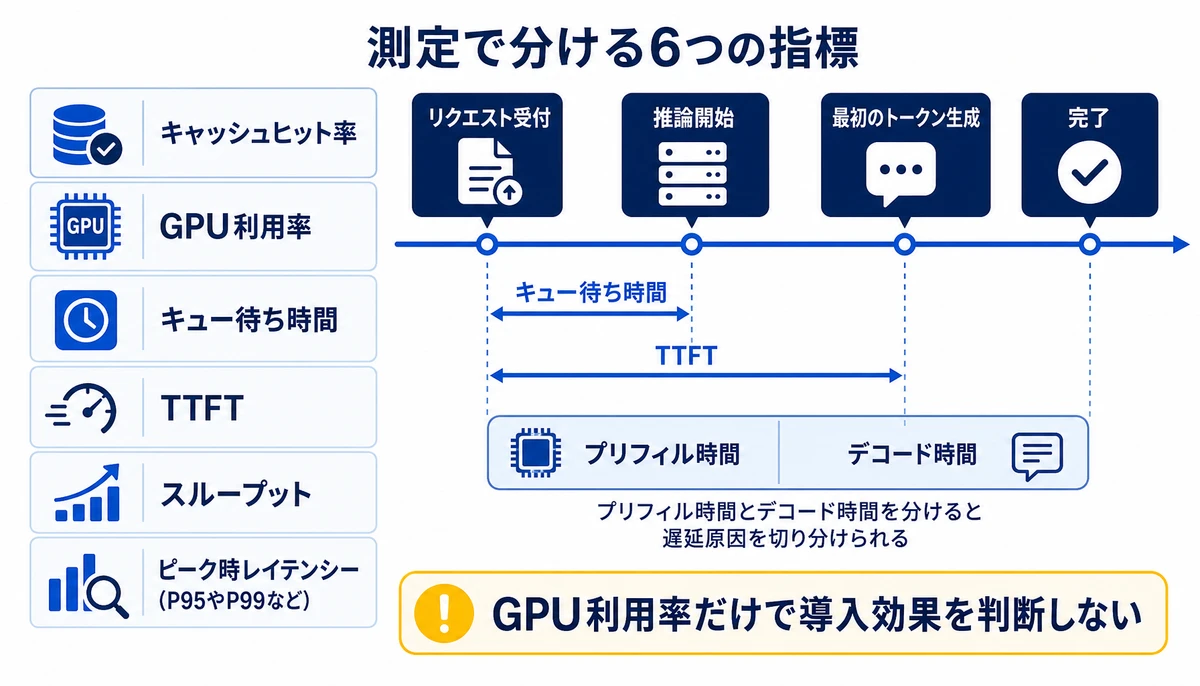
導入効果を調べるときは、GPU利用率を単独で見ないようにします。利用率が上がっても、生成速度や待ち時間が悪化すれば、サービスとしての改善とは言いにくいためです。
- キャッシュヒット率、再利用対象となった入力や状態の割合
- GPU利用率、計算資源が実際に処理へ使われた割合
- キュー待ち時間、受付から推論開始までの時間
- TTFT、Time to First Tokenの略で、受付から最初のトークンまでの時間
- スループット、一定時間に処理できた入力または出力トークン量
- ピーク時レイテンシー、混雑時のP95やP99などで見る応答時間
測定では、リクエスト受付時刻、推論開始時刻、最初のトークン生成時刻、完了時刻を記録します。プリフィル時間とデコード時間を分けると、長い入力が遅延の原因か、生成量が原因かを切り分けられるでしょう。
比較対象は3段階。単一vLLM構成、単純に分散した構成、KVキャッシュを考慮した構成です。同じモデル、入力分布、同時実行条件を使い、平均値だけでなくピーク時の分布も並べてください。
| 見る項目 | 確認する問い | 悪化時に疑う要因 |
|---|---|---|
| キャッシュヒット率 | 共通入力が状態再利用につながっているか | 入力のばらつき、保持時間、更新 |
| TTFT | 最初の応答までの待ち時間が短くなったか | キュー滞留、プリフィル負荷、偏ったルーティング |
| GPU利用率 | 待機時間を減らし計算へ使えているか | 過剰なGPU、メモリ待ち、負荷の集中 |
| スループット | 同じ資源で処理量が増えたか | 再計算、バッチ形成不足、通信負荷 |
| P95・P99レイテンシー | 混雑時もSLOを守れているか | キャッシュ偏り、障害復旧、キューの伸長 |
実トラフィックに近づける条件
検証用の入力をすべて同じ長さにすると、実運用の偏りを見落とします。短い質問、長い文書、共通プロンプト、キャッシュされにくい個別入力を混ぜると、構成の得意不得意が見えやすくなるでしょう。
- 入力長と出力長の分布を本番ログから抽出する
- 共通プレフィックスを持つリクエスト群を分ける
- 通常時とピーク時の同時実行条件を用意する
- モデル更新やインスタンス再起動後の状態も確認する
- 測定期間中にキャッシュの温まり方を記録する
設計で先に潰す落とし穴と互換性確認
llm-dの導入では、ルーティングを賢くするほど監視と障害対応の対象が増えます。推論が速くなるケースだけでなく、状態が消えた場合や負荷が偏った場合の動きも設計に含めます。
- キャッシュ偏り、再利用を優先した結果、一部のGPUだけが逼迫する
- 状態消失、再起動や更新でキャッシュが消え、再計算が増える
- 障害時の再配置、状態を持つインスタンスから別の場所へ移す必要が生じる
- 制御の複雑化、ルーター、推論サーバー、監視の責任分界が曖昧になる
互換性の確認項目
既存のAPI呼び出しが動くかだけでは、互換性の確認として不十分です。ストリーミング応答、タイムアウト、キャンセル、認証、モデル切り替え時の挙動まで、実際のクライアント条件で確認するのが基本です。
- OpenAI互換APIなど、既存クライアントが使う形式
- ストリーミングと途中キャンセルの扱い
- タイムアウト時にキューとGPU処理を解放できるか
- モデルや量子化設定が異なるインスタンスの混在可否
- ログにプロンプトや機密情報を残さない設定

段階的な検証と運用設計
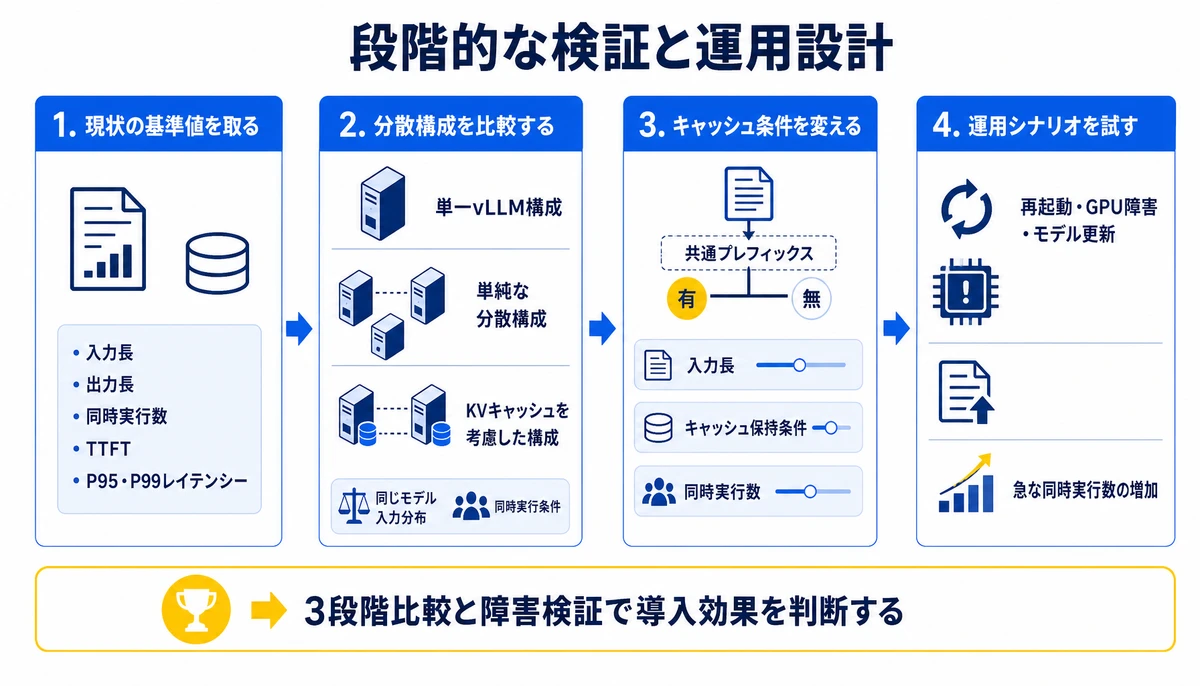
本番の全リクエストをいきなりllm-dへ移すのではなく、測定可能な小さな経路から始めます。構成を増やすたびに、性能だけでなく、誰が状態と障害を管理するかを確認するのが基本です。
1. 現状の基準値を取る
まず単一vLLM構成で、入力長、出力長、同時実行数、TTFT、生成中のトークン間隔、P95・P99レイテンシーを記録します。
GPU利用率は平均値だけでなく、時間帯ごとの変化も残しておきたいところです。
2. 分散構成を比較する
次に、同じモデルを複数インスタンスへ分散します。ラウンドロビンなど単純な割り当てを基準にすると、KVキャッシュを考慮した場合に何が変わったかを説明しやすくなります。
3. キャッシュ条件を変える
共通プレフィックスの有無、入力の長さ、キャッシュ保持の条件を変えて、ヒット率と遅延を比較します。キャッシュが効くワークロードだけでなく、効かないワークロードも同じ表に記録します。
4. 運用シナリオを試す
インスタンス再起動、GPU障害、モデル更新、急な同時実行数の増加を検証します。平常時の平均レイテンシーが改善しても、障害復旧時にSLOを大きく外すなら本番構成には課題が残ります。
- 構成ごとのメトリクスとログを同じ形式で保存する
- キャッシュヒット率とインスタンス別メモリ使用量を並べる
- P95・P99レイテンシーを通常時とピーク時で分ける
- 再起動後にキャッシュが温まるまでの時間を測る
- 費用をGPU利用時間、処理トークン量、運用工数に分ける
導入判断は、GPU利用率の上昇だけで決めません。SLOを満たしながら処理できる同時実行数と、1リクエストまたは一定量のトークンを処理するための総コストを比較します。
自社検証と外部支援の使い方
自社だけで検証すると、性能測定の前に入力ログの整理で止まることがあります。機密情報を含む実トラフィックをどう匿名化するか、どの入力分布を代表値とするかで判断が分かれるためです。
- 入力プレフィックスの一致条件を定義できない
- TTFTと生成中のトークン間隔を別々に計測できない
- キャッシュ偏りとGPUメモリ逼迫の関係を追えない
- モデル更新や障害時の再配置を検証環境で再現できない
外部の支援を使う場合は、単にllm-dを構築するのではなく、現状構成の診断、比較条件の設計、指標の定義まで先に揃えられるかを確認します。構成の採用を目的にせず、採用しない条件も明文化できる体制が必要でしょう。
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。llm-dの導入可否も、既存のvLLM構成や運用条件を確認したうえで検討する流れです。
見積は一式の金額ではなく、要件を整理したうえで詳細を示します。契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進められる形を取ります。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。内製化と社内定着まで含めて、運用を引き継ぐ担当者が判断できる状態を目指します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
llm-dを導入すればGPU台数を減らせますか?
必ず減らせるとは言えません。KVキャッシュの再利用や負荷分散によって同じGPU資源の有効スループットが高まれば、追加投資を遅らせられる可能性があります。
vLLMだけではコスト削減できないのでしょうか?
vLLM内部のバッチ処理やメモリ管理で改善できる余地はあります。複数インスタンス間で、どのリクエストをどこへ送るかまで最適化したい場合は、制御層の検討が別に必要になるでしょう。
KVキャッシュが効きやすいサービスはどのようなものですか?
共通のシステムプロンプト、定型的な文書、同じ前提情報を繰り返し使うサービスでは、再利用の余地があります。入力が毎回大きく異なる場合は、キャッシュヒット率を測ってから判断してください。
GPU利用率が上がれば導入成功と判断できますか?
それだけでは判断できません。GPU利用率が上がる一方で、TTFT、キュー待ち時間、P95・P99レイテンシーが悪化する場合があります。
SLOとスループットは必ずセットで確認を。
最初の検証では何を比較すべきですか?
単一vLLM構成、単純な分散構成、KVキャッシュを考慮した構成の3段階が比較の基本です。同じ入力分布と同時実行条件で、キャッシュヒット率、TTFT、スループット、ピーク時レイテンシーを記録してください。
導入前に互換性で確認する点は何ですか?
API形式だけでなく、ストリーミング、キャンセル、タイムアウト、認証、モデル更新、障害時の再配置を確認します。既存クライアントの実際の呼び出し方で試すことが必要です。
Red Hat llm-dは、GPUを増やさずに必ず費用を下げる製品として見るより、分散したvLLMインスタンスを推論状態まで考慮して制御する基盤として評価する方が、導入判断を誤りにくくなります。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
AIコードレビューの選び方と運用設計
AIコードレビューは検出率と誤検知がトレードオフで、万能の一択はない。Copilot・CodeRabbit・Greptile・Codexの性格、独立ベンチマークの読み方、ノイズを抑える運用設計までを、出典付きの実データで解説する。
個人のAI活用を組織の成果に変える:チーム開発の標準化
AIコーディングツールを導入しても、個人の使い方に留まればチームの成果にはつながりにくい。設定・知識・レビュー・テストの4階層を共有資産として標準化し、AIが自ら学習・改善するループを回すことで、人は設計と判断に集中できる。その設計手順を具体例とともに解説する。

その処理、本当に最上位モデルでないと駄目ですか
Claudeの現行モデルは、100万トークンあたりの入力単価が1ドルから10ドルまで10倍開いています。全部を上位モデルで回すと、判断の要らない処理にも10倍の単価を払うことになります。用途ごとにモデルを割り当てる設計を、Anthropicの公式ドキュメントをもとに整理します。















