
AIエージェントを本番業務へ移すMicrosoft Agent Framework運用設計の要点
要約
Microsoft Agent Frameworkを手がかりに、AIエージェントを本番業務へ移す際のタイムアウト、状態管理、OpenTelemetry監視、失敗復旧、責任分界を設計者の視点で整理します。
この記事の対象読者
- AIエージェントを本番業務へ移したい企業や組織
- 長時間タスクを自動実行したい企業や組織
- AzureやMicrosoft製品を利用している企業や組織
- エージェントの監視と復旧を設計したい企業や組織
- PoC後の運用基盤を選びたい企業や組織
評価の中心をデモの回答品質だけに置くと、本番で起きる待機、再実行、状態破損の判断が後回しになります。
本番導入では、処理が成功した瞬間よりも、途中で止まったときの扱いが設計品質を分けます。
回答性能から運用可能性へ
海外の開発者向け資料では、AIエージェントを単独のチャット機能ではなく、複数の処理や外部サービスを組み合わせるアプリとして扱う議論が増えています。
Microsoftが公開するMicrosoft Agent Frameworkも、AIエージェントやマルチエージェントアプリの構築を対象にしたフレームワーク。採用時は、実行制御や状態管理をどこまで担えるかを確認します。
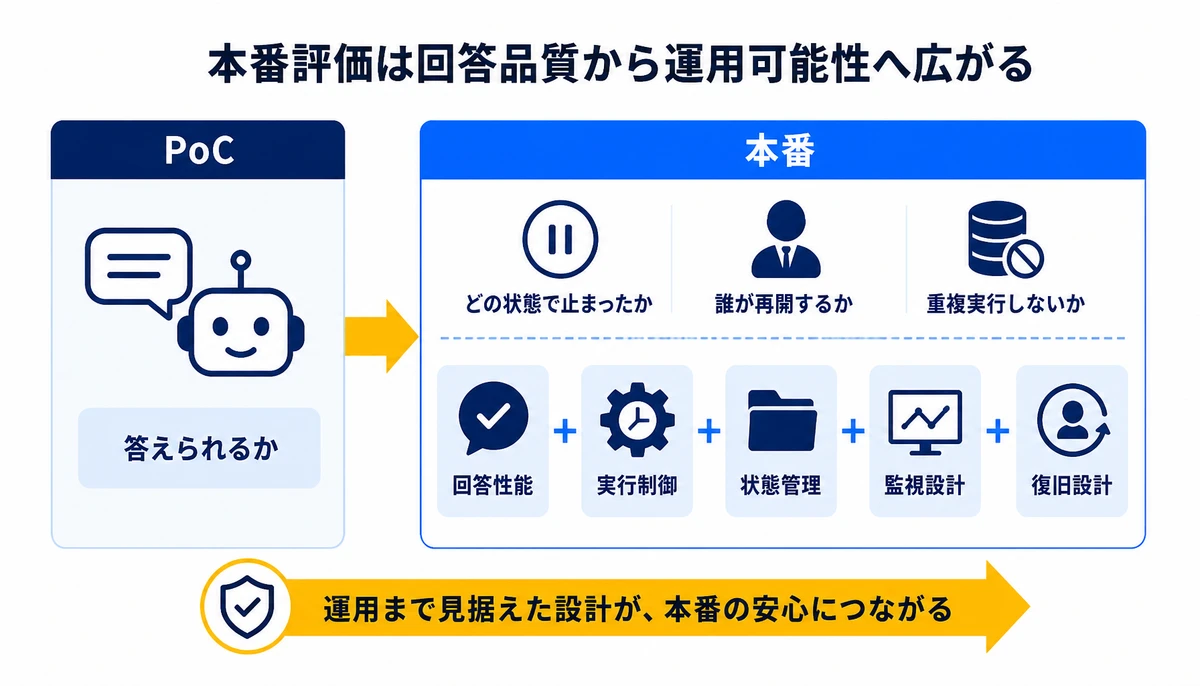
BinxAIが企業の検討現場で見てきた範囲では、PoC(概念実証)の段階では「答えられるか」が問われます。本番化の段階に入ると、どの状態で止まったか、誰が再開するか、同じ処理を重複実行しないかが論点になります。
- 回答性能、質問に対する内容の妥当性を確認する
- 実行制御、タイムアウトやキャンセルの扱いを定める
- 状態管理、途中経過と完了状態を区別して保存する
- 監視設計、処理の遅延や外部呼び出しを追跡できるようにする
- 復旧設計、失敗後に再試行する範囲と担当者への引き継ぎを決める
この変化は、フレームワークの機能数を競う話ではありません。アプリケーションの一機能として作ったエージェントを、企業システムの一部として管理できるかという話です。

長時間実行の設計要素
バックグラウンド処理のタイムアウト
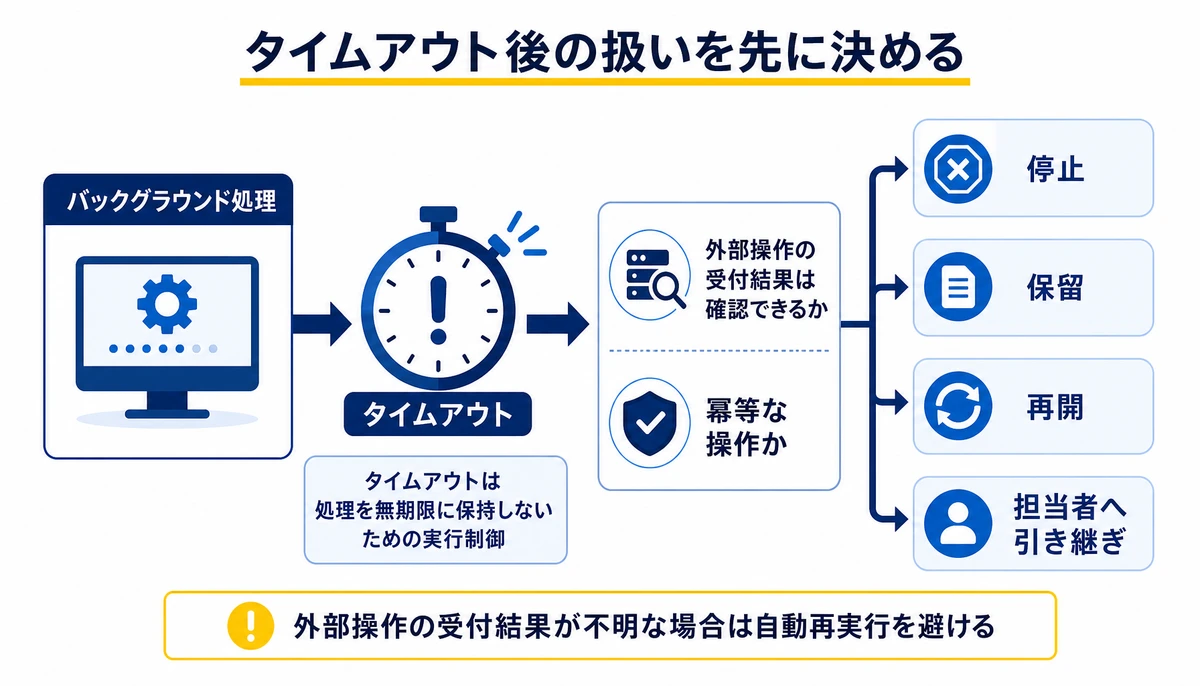
長時間タスクをバックグラウンドで動かす場合、待ち続けられることは成功ではありません。タイムアウトは、処理を無期限に保持しないための実行制御です。業務上の失敗を確定する境界とは、別に扱います。
外部システムの応答待ちで時間を使い切った場合、処理を即時失敗にする設計もあれば、状態を保存して後から再開する設計もあります。どちらを選ぶかは、外部処理が冪等(同じ要求を複数回受けても結果が重複しない性質)かどうかによるでしょう。
- タイムアウト時に処理を停止するのか、保留状態へ移すのか
- 外部サービスへの要求が送信済みかどうかを確認できるのか
- 再試行の回数ではなく、再試行してよい業務操作かを判定できるのか
- 担当者へ渡す場合に、最後の実行状態と次の作業を表示できるのか
状態保存とチェックポイント
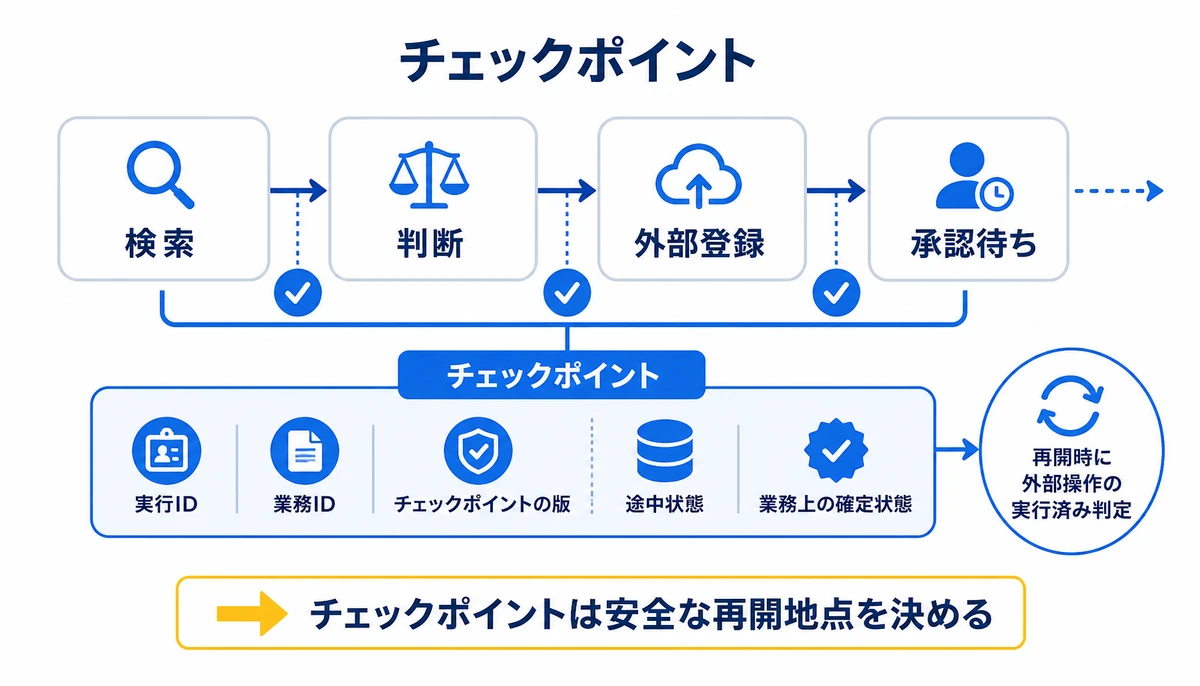
長時間実行では、最初から最後までを1回の処理として扱わない設計が向いています。検索、判断、外部登録、承認待ちのように、再開可能な単位へ分けてチェックポイントを置きます。
チェックポイントは単なるログではありません。次にどの処理から再開するかを決める状態です。変更を保護できない場合、異なる実行の状態が混ざったり、古い状態で新しい状態を上書きしたりするリスクが残ります。
- 実行ID、業務ID、チェックポイントの版を分けて管理する
- 状態を更新する前に、対象の実行が一致しているか確認する
- 途中状態と業務上の確定状態を別の項目として保存する
- 再開時に外部操作の実行済み判定を行う
- 状態変更の履歴を、担当者が追える形で残す
タイムアウトとチェックポイントは、実装上の設定値ではなく、再開の権限と業務の確定条件を決める仕組みです。
OpenTelemetryで追う実行経路
監視対象を処理単位で分ける
AIエージェントの応答が遅いとき、モデルだけを見ても原因は分かりません。検索、ツール呼び出し、認証、外部API、キュー、状態ストアのどこで時間を使ったかを分解する必要があります。
OpenTelemetryを使う場合は、エージェント全体の実行時間だけでなく、処理を構成するスパン(開始と終了を持つ追跡単位)を設計します。既存の監視基盤へ接続する前に、何を記録し、何を記録しないかを決めておく段取りです。
- 実行IDと業務IDを追跡情報へ付与する
- モデル呼び出しとツール呼び出しを別の処理として記録する
- タイムアウト、再試行、キャンセルを異なる状態として扱う
- 外部APIの応答時間とエラー種別を記録する
- プロンプト、個人情報、機密データをテレメトリーへ残す範囲を制限する
監視から復旧へつなぐ
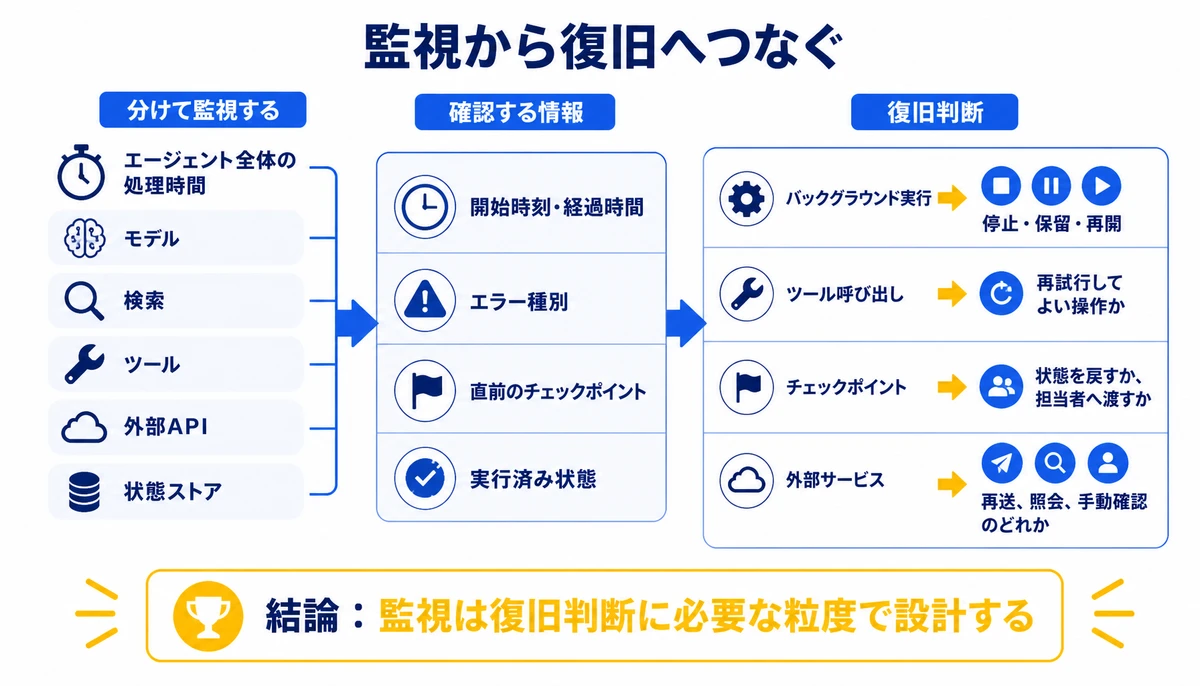
監視の目的は、ダッシュボードを増やすことではありません。異常を検知した後に、処理を止めるのか、再試行するのか、担当者へ渡すのかを判断できる情報を揃えることです。
たとえば「応答時間が長い」という情報だけでは、モデルの遅延と外部APIの遅延を区別できません。復旧手順に結び付く粒度で、失敗した処理名、直前のチェックポイント、再実行の可否を確認できるようにします。
| 観測する対象 | 確認する情報 | 復旧判断 |
|---|---|---|
| バックグラウンド実行 | 開始時刻、経過時間、タイムアウト状態 | 停止、保留、再開のどれか |
| ツール呼び出し | 呼び出し先、要求結果、実行済み状態 | 再試行してよい操作か |
| チェックポイント | 実行ID、版、直前の処理 | 状態を戻すか、担当者へ渡すか |
| 外部サービス | 応答時間、エラー種別、受付結果 | 再送、照会、手動確認のどれか |
Azure AI Foundryなどの既存環境と組み合わせる場合も、監視の責任を製品名だけで決めないことが大切です。モデル、エージェント実行基盤、業務システムの境界ごとに、どの情報を誰が保持するかを確認します。
失敗時の責任分界
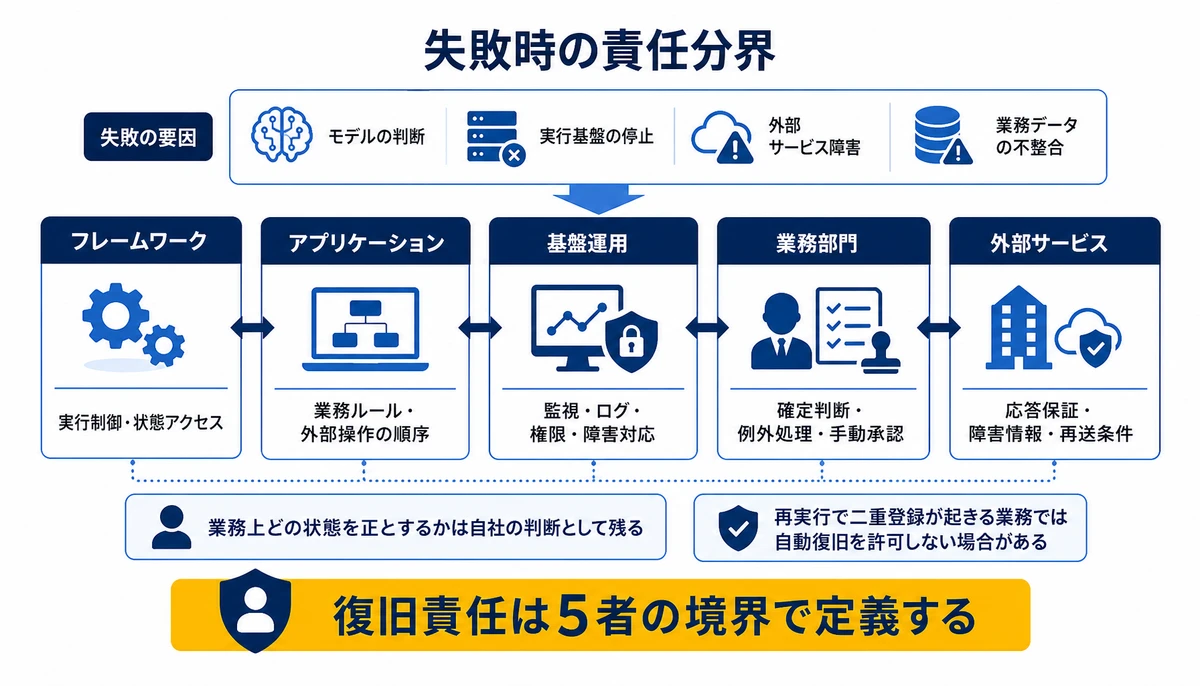
AIエージェントの失敗には、モデルの判断、実行基盤の停止、外部サービスの障害、業務データの不整合が含まれます。これらを「エージェントの失敗」と一括りにすると、復旧担当者が決まりません。
フレームワークがタイムアウト、状態保存、テレメトリーを扱いやすくしても、業務上どの状態を正とするかは自社の判断です。再実行で二重登録が起きる業務なら、技術的に再実行できても自動復旧を許可しない場合があります。
- フレームワークの責任、実行制御や状態アクセスの仕組み
- アプリケーションの責任、業務ルールと外部操作の順序
- 基盤運用の責任、監視、ログ保管、権限、障害対応
- 業務部門の責任、確定判断、例外処理、手動承認
- 外部サービスの責任、応答保証、障害情報、再送条件
復旧設計では「誰が直すか」だけでなく、「どの状態を正として再開するか」を先に決めます。この定義がないまま自動再試行を足すと、障害を隠したまま重複処理を増やすことがあるでしょう。

本番評価の確認項目
PoCの評価表に正答率や応答速度だけを置いている場合は、運用項目を追加します。Microsoft Agent Frameworkを候補にする場合も、フレームワークが提供する機能と自社で実装する責任を切り分けて確認することが出発点です。
| 評価領域 | 確認する問い | 合格条件の例 |
|---|---|---|
| タイムアウト | 時間切れ後に処理と状態はどうなるか | 停止後の状態と次の担当が確認できる |
| 状態管理 | 異なる実行の状態を混在させないか | 実行IDと版を照合して更新する |
| 監視 | 失敗箇所を外部サービス単位で追えるか | 処理経路とエラー種別を確認できる |
| 再実行 | 同じ業務操作を重複させないか | 実行済み判定または手動確認を挟む |
| 責任分界 | 障害時に誰が判断し、誰が復旧するか | 担当部署と判断基準が文書化されている |
失敗シナリオから試験する
本番評価では、正常系のデモを長く続けるより、失敗シナリオを先に作ります。外部APIが応答しない、状態ストアが一時的に使えない、担当者の承認が期限を超える、といった事象を業務単位で再現しましょう。
検証結果は、機能の可否だけでなく、採用した責任分界と未解決のリスクまで記録します。
- 途中でタイムアウトした実行を保留状態から再開する
- 外部登録の受付結果が不明な状態で再試行する
- チェックポイントを古い版で更新しようとする
- 監視情報から失敗したツール呼び出しを特定する
- 自動復旧を止めて担当者へ引き継ぐ
導入判断を記録する
検証結果は、機能の可否だけでなく、採用した責任分界と未解決のリスクまで記録します。「タイムアウトは設定できる」と書くのではなく、「時間切れ後は状態を保留する。業務担当者が外部システムの受付結果を確認して再開する」と書く形です。
この記録があると、モデルやクラウドサービスを変更したときも、再確認すべき境界が見えます。Azureを利用している組織では、既存の認証、ログ、アラート、データ保管のルールとの整合性も同じ表で確認すると進めやすくなります。
自社実装で詰まりやすい箇所
自社で進める場合、最初に詰まりやすいのは、タイムアウトの値そのものではありません。業務上の完了条件と、チェックポイントから再開してよい条件が決まっていないことです。
- エージェントの状態と業務システムの状態を、どちらが正か決められない
- OpenTelemetryの記録項目に機密情報が混ざり、監視基盤へ送れない
- 失敗時の再試行と手動確認の境界を、開発部門だけでは決められない
外部の支援を使うと、技術選定だけでなく、現場の業務手順と実行基盤の境界を同時に整理できます。失敗シナリオの作成、監視項目の棚卸し、復旧担当の合意形成を開発前に進めやすくなるでしょう。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。
AIエージェントの導入でも、回答機能だけでなく、状態管理、監視、復旧の境界を業務に合わせて確認。見積は一式ではなく、要件を整理したうえで詳細を示します。
契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えながら進められます。企画、課題整理、要件整理から開発までを同じ担当が受け持ち、内製化と社内定着まで支援します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Microsoft Agent Frameworkは何を対象にしていますか?
AIエージェントやマルチエージェントアプリケーションの構築を対象とする開発フレームワークです。採用時は、対象業務で必要な実行制御、状態管理、監視、復旧をどこまで担えるかを確認します。
バックグラウンド処理のタイムアウトは何を決めますか?
タイムアウトは、処理を待ち続ける時間の上限と、時間切れ後の実行状態を決めるもの。停止、保留、再試行、担当者への引き継ぎを分け、外部操作の受付結果が不明な場合は自動再実行を避けます。
OpenTelemetryで何を監視すべきですか?
エージェント全体の処理時間だけでなく、モデル、検索、ツール、外部API、状態ストアの処理を分けて監視します。実行IDや業務IDを追跡しつつ、プロンプトや個人情報を記録しすぎない設計も必要です。
チェックポイント変更を保護する理由は何ですか?
長時間実行では、途中状態から処理を再開することがあるでしょう。変更を保護しないと、古い実行が新しい状態を上書きしたり、異なる実行の状態が混ざったりするため、実行IDや状態の版を照合します。
失敗時の復旧責任は誰が持ちますか?
フレームワーク、アプリケーション、基盤運用、業務部門、外部サービスに分けて定義することが基本。フレームワークが実行制御を支えても、業務上の完了条件や再実行の可否は、導入企業と業務部門が決める領域として残ります。
Azure AI Foundryと組み合わせる際の確認点は何ですか?
モデルや検索の構成だけでなく、エージェントの実行状態、監視データ、機密情報の扱いを確認します。既存のAzure環境で利用する場合は、認証、ログ保管、アラート、障害対応の担当部署との境界も明文化しましょう。
AIエージェントを本番へ移すときは、回答品質の比較に加えて、タイムアウト後の状態とチェックポイントの保護を確認します。OpenTelemetryによる監視と失敗時の復旧責任も、あわせて整理しておきましょう。
Microsoft Agent Frameworkを候補にする場合も、フレームワークと自社運用の分界を先に書き出すことが出発点。PoCから本番へ進む準備として、まずその一覧を作ることをおすすめしたいのが第一歩です。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Microsoft Agent Framework 1.18.0を企業導入前に確認すること
Microsoft Agent Framework 1.18.0の公開を受け、企業導入前に確認したいProduction Stableの範囲、ワークフロー構成、状態管理、失敗復旧、Azure資産との接続方法を整理します。
既存Java資産にAIを組み込むJetBrains Koog 1.0入門
JetBrains Koog 1.0をPythonの代替ではなく、既存のKotlin・Java業務システムへAIエージェント処理を組み込む選択肢として整理します。構成、実装手順、認証やトランザクションの境界、本番前の評価項目を具体的に紹介します。

LLM比較2026年版:GPT・Claude・Gemini・DeepSeekをポートフォリオで使い分ける
「最強モデル探し」はもう終わった。2026年のLLM選定は、RAG・エージェント・コーディング・社内文書検索という4ユースケースに対し、コスト・ガバナンス・統合コストの三軸で複数モデルを使い分けるポートフォリオ設計に移行している。日本企業特有の制約を踏まえた実践的な選定フレームワークを解説する。















