
GPT-5.6 Sol Ultrafast限定プレビュー 最大14倍速がエージェント設計を変える
要約
GPT-5.6 Sol Ultrafastの限定プレビュー開始を受け、最大14倍の速度向上がAIエージェントの待ち時間や業務KPIにどう影響するかを整理します。導入前の検証項目や費用、精度、安全性の見方も紹介します。
AIエージェントの導入で、回答の正しさだけを比べる時期が変わりつつあります。顧客対応や受注処理では、返答を待つ数秒が業務体験を左右する場面もあるでしょう。
この記事では、新機能の発表内容を確認したうえで、速度を業務設計へどう組み込むかを見ていきます。
この記事の対象読者
- GPT-5.6 SolやGPT-5.6 Ultrafastの情報を追っている担当者
- カスタマーサポート、受注、営業支援にAIエージェントを検討するチーム
- モデル変更による速度、費用、精度の差を測りたい責任者
- AIエージェントの処理を人間の業務フローへ組み込みたい企業
GPT-5.6 Solに速度重視のUltrafastモードが加わる
限定プレビューの現状
SBbitの記事によると、OpenAIはGPT-5.6 Solに「Ultrafast」モードを追加しました。2026年8月15日時点では、一部顧客を対象に限定プレビューを開始した段階です。
同記事では、GPT-5.6 Sol Ultrafastは知能水準を維持しながら、最大14倍の速度向上を目指すモードと説明されています。速度の数値は最大値であり、すべての処理で同じ結果になるとは限りません。
GPT-5.6の3層構成とUltrafastの位置づけ
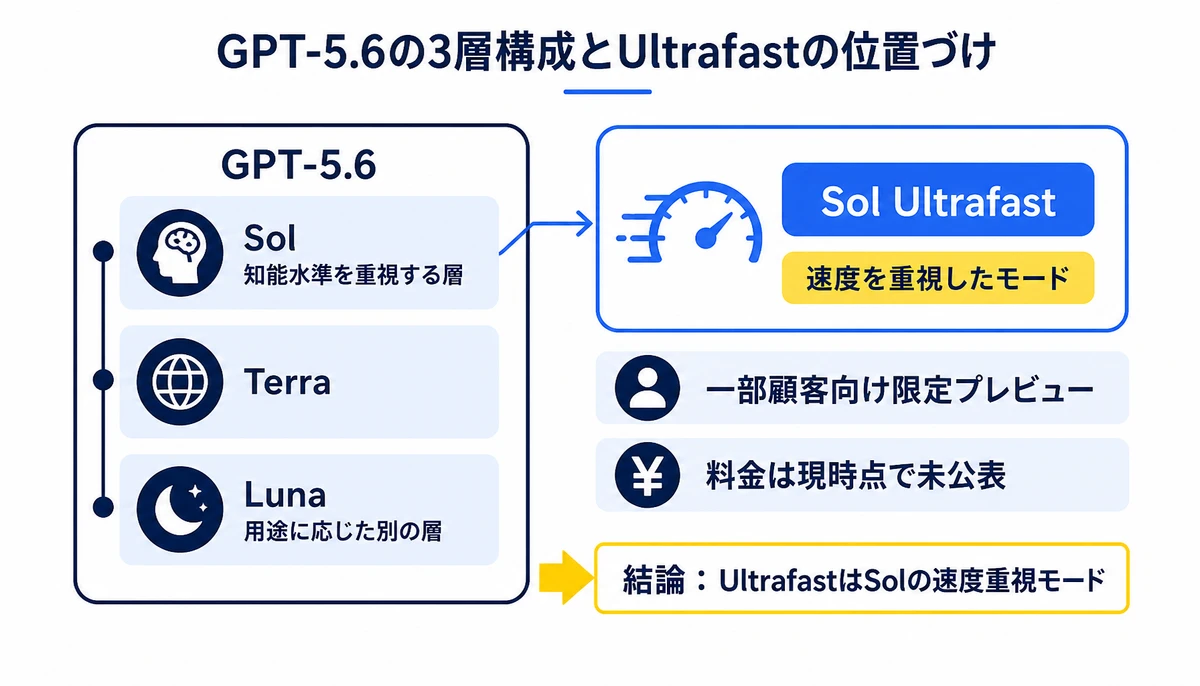
- GPT-5.6 Sol、知能水準を重視する層
- GPT-5.6 Terra、中間に位置する層
- GPT-5.6 Luna、用途に応じた別の層
- Sol Ultrafast、Solの速度を重視するモード
GPT-5.6の構成はSol、Terra、Lunaの3層です。SBbitの記事では、Ultrafastはそのうち速度を重視したモードとして整理されています。

高速推論はモデル選びを待ち時間まで広げる
積み上がる待ち時間が体感を決める
海外では、高速な推論モデルを実際の業務へ組み込む議論が進んでいます。これまでのモデル比較は、回答品質やベンチマークの差に目が向きやすいものでした。
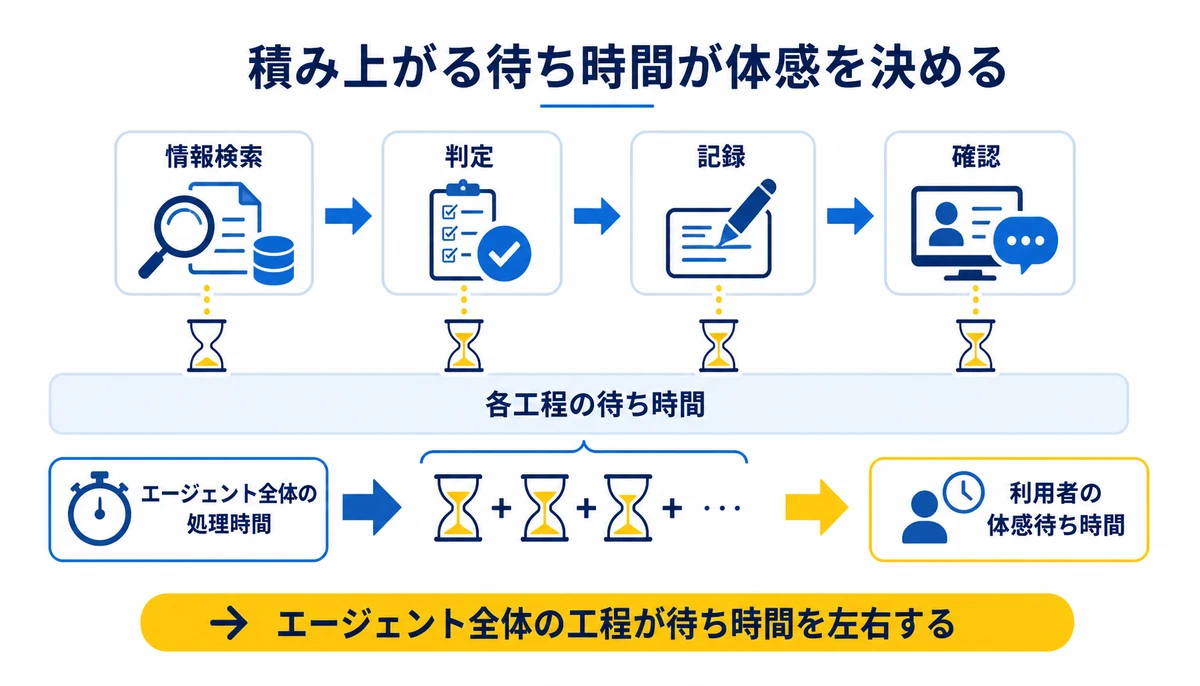
BinxAIが現場で見てきた範囲では、エージェントは一度の回答だけで完結しないケースが多くあります。情報検索、判定、記録、確認を順に呼び出すと、各工程の待ち時間が利用者の体感へ積み上がるのです。
速度が上がると、モデルを選ぶ軸は知能水準だけでなく、知能水準と応答速度の組み合わせになります。
- 顧客の質問に返すまでの待ち時間
- 担当者が確認してから引き継ぐまでの時間
- 複数回のモデル呼び出しにかかる処理時間
- 同じ時間内に処理できる問い合わせや受注の量
- 人間が介入するタイミングの設計
たとえばサポート業務では、回答案の生成が速くても、確認画面や社内検索が遅ければ体験は変わりません。エージェント全体の処理時間を測り、どこが待ち時間を作るのかを見る必要があります。
処理が速くなるほど、確認を省いて自動実行へ寄せたくなるかもしれません。そこで、権限管理や誤回答時の停止条件を先に決めておくことが求められます。
導入前に業務KPIで速度の価値を確かめる
測るべき5つの指標
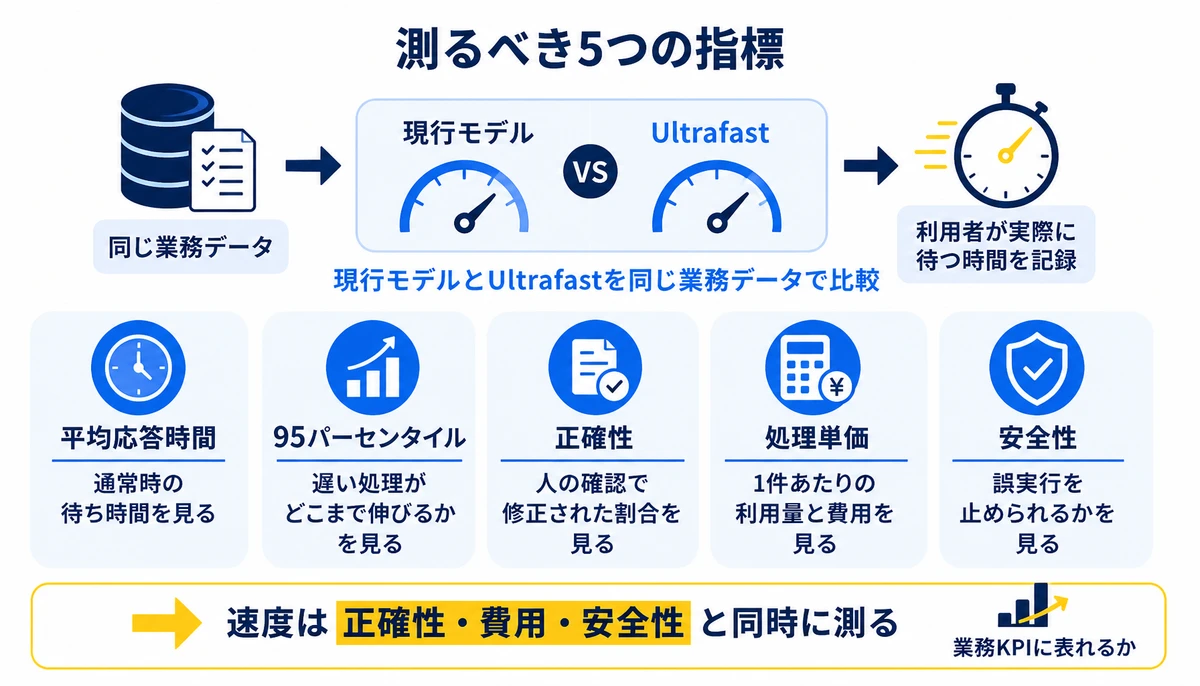
導入を検討する企業は、現在のモデルとUltrafastを同じ業務データで比べます。最大14倍という表現だけで判断せず、利用者が実際に待つ時間を記録してください。
- 平均応答時間、通常時の待ち時間を見る
- 95パーセンタイル、遅い処理がどこまで伸びるかを見る
- 正確性、人の確認で修正された割合を見る
- 処理単価、1件あたりの利用量と費用を見る
- 安全性、誤実行を止められるかを見る
| 検証対象 | 確認する問い | 判断の材料 |
|---|---|---|
| サポート | 顧客の待ち時間は短くなったか | 応答時間と再問い合わせ |
| 受注 | 確認待ちで処理が止まらないか | 処理時間と人の介入回数 |
| 営業支援 | 提案準備の時間を減らせたか | 作成時間と修正回数 |
速度の改善が業務KPIに表れない場合、モデルを変えても成果は見えにくいでしょう。検索基盤、承認フロー、画面操作など、周辺工程の見直しが先になることもあります。

自社検証で詰まりやすい点を先に切り分ける
現場で起きやすい3つの障壁
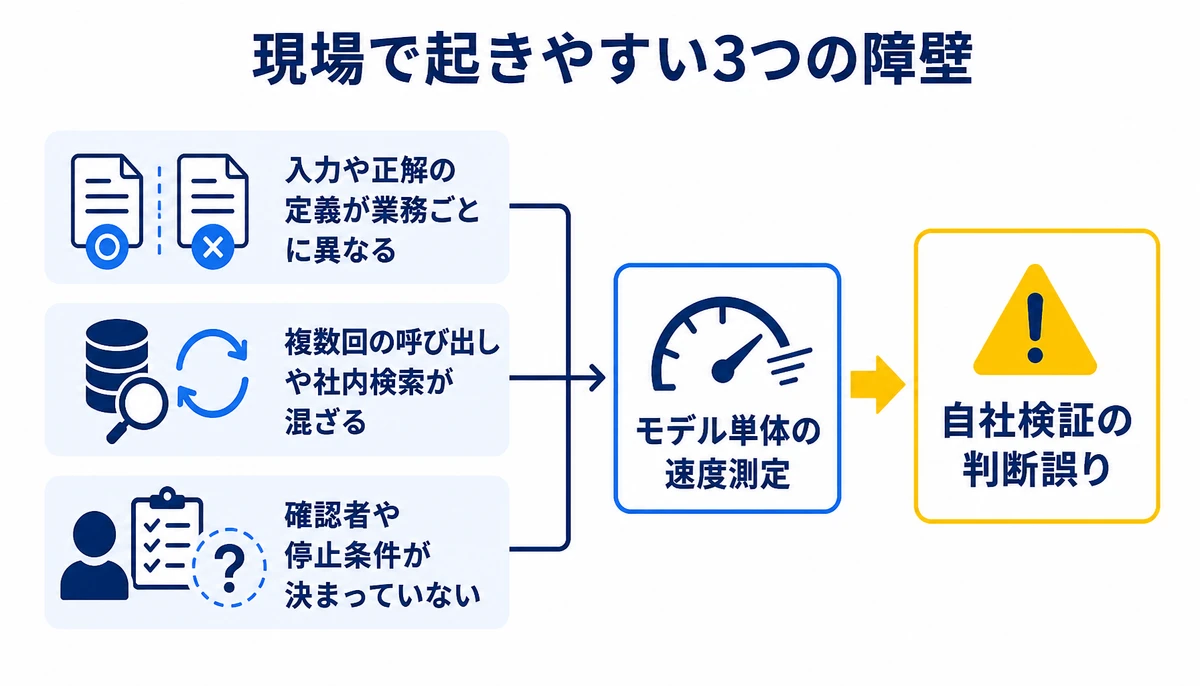
GPT-5.6 Sol Ultrafastを自社で試す場合、モデルの速度だけを測ると判断を誤りやすくなります。
実務では、次のような障壁が起きがちです。
- 業務ごとに入力や正解の定義が違い、比較条件がそろわない
- 複数回の呼び出しや社内検索が混ざり、モデル単体の速度が見えない
- 速い回答を優先するあまり、確認者や停止条件が決まらない
外部の支援を使うと、業務タスクの棚卸しから検証条件をそろえやすくなります。データ基盤、業務アプリ、社内規約まで分けて考えることで、モデル変更だけでは解けない問題も切り分けられます。
BinxAIの「みっちゃくん」は、月額5万円からで初期費用はありません。追加費用はなく、API・サーバー・ツールの費用は実費です。
業務タスクの棚卸し、データ基盤構築・改善、業務アプリ開発、AI研修、AIアドバイザーなどを提供しています。社内規約策定、月次レポート、セキュリティ対応、社内での横展開も対象です。

よくある質問
GPT-5.6 Sol Ultrafastは誰でも使えますか?
2026年8月15日時点では、一部顧客向けの限定プレビューです。SBbitの記事では、提供容量の拡大に応じて対象を広げる方針とされています。
最大14倍の速度はすべての処理で出ますか?
最大値として示された速度向上の目標です。実際の応答時間は、入力内容、処理手順、外部ツール、ネットワークなどで変わるため、自社業務での測定が必要です。
Ultrafastの料金はいくらですか?
SBbitの記事では、Ultrafastの料金は現時点で公表されていません。利用できる場合も、契約条件や利用量あたりの費用を確認してから比較してください。
最初にどの業務で試すべきですか?
待ち時間が利用者の行動に影響しやすい業務から始めます。サポート、受注、営業支援などを候補にし、処理時間と正確性を同じ条件で記録すると比較しやすくなります。
速度が上がれば人の確認は不要になりますか?
不要になるとは限りません。受注確定や顧客への最終回答など、誤りの影響が大きい処理では、確認者と停止条件を残す設計が安全です。
GPT-5.6 Sol Ultrafastの登場は、AIエージェントを速くするニュースにとどまりません。自社業務で待ち時間がどのKPIに影響するかを測り、費用、精度、安全性と並べてモデルを選ぶ機会になるでしょう。
まず、自社で最も待ち時間が目立つ業務を1つ選び、現状の応答時間をストップウォッチで記録するところから始めてみてください。
あわせて読みたい
本記事は2026年8月15日時点の公開情報をもとにしています。提供対象、料金、仕様は変更される可能性があるため、契約や利用開始の前に各社へ確認してください。記事内の見解は成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
MetaがMuse Glimmerをオープンウェイト公開 ローカルLLMの選択肢が本格化してきた
MetaがMuse Glimmerのオープンウェイト公開を発表し、さらに最上位モデルMuse Spark 1.2も数週間以内に解放予定と明かした。クラウドAPIへのデータ送出を規制で制限される企業にとって、フロンティア水準のモデルがオンプレミスで動く意味は小さくない。この記事ではニュースの事実と、企業が今すぐ検討すべき実務上の論点を整理する。
GPT-5.6 Solプレビュー公開。OpenAIがモデル選択を企業に委ねる時代に入った
OpenAIが2026年7月29日にGPT-5.6 Solのプレビューを公開し、Sol・Terra・Lunaの3モデル構成を発表しました。単なる性能更新ではなく、企業が予算帯・用途帯に応じてモデルを選ぶ設計が求められる時代への転換点です。各モデルの位置づけと、日本企業が今押さえておくべき実装判断の論点を整理します。
GLM-5.3がClaudeやChatGPT超えのベンチマークCursorの脆弱性も確認を
GLM-5.3がClaudeやChatGPTを上回ると紹介されたベンチマーク結果と、Cursorの脆弱性報告を整理します。企業がコーディングAIを導入する際に、自社コードや権限、情報流出、検証環境をどう確認すべきかを具体的に解説します。















