
Grok 4.7は企業で使えるか500Kコンテキストと料金を検証する
要約
Grok 4.7の公開情報とAPI料金を確認し、500Kコンテキストの真偽を含めて企業導入の判断軸を整理します。GPTやClaudeとの比較方法、日本語業務データでの検証手順、長時間タスクの失敗率と処理時間、業務単位の費用計算まで解説します。
Grok 4.7について、500KコンテキストやAPI料金を示す情報が広がっています。ただし、2026年9月28日時点で、提示された一次ソースからは公開日や仕様を確認できません。
xAIは公式サイトでAIサービスを案内しています。企業利用を検討する場合は、Grok APIの公式仕様、提供モデル、料金、利用条件を確認するところが出発点です。
海外ではモデルのコンテキスト長や価格競争が盛んに議論されています。BinxAIが企業の検証で見るのは、数字の大きさよりも、実際の日本語業務で安定して成果が出るかです。
この記事の対象読者
- AIモデルの選択肢を増やしたい企業
- コード修正をAIに任せたい開発組織
- 長文調査を効率化したい企業
- API料金を業務単位で見直したい企業
- GPTやClaude以外のモデルを評価したい企業
Grok 4.7で確認できる公開情報
確認できる事実と未確認情報の切り分け方
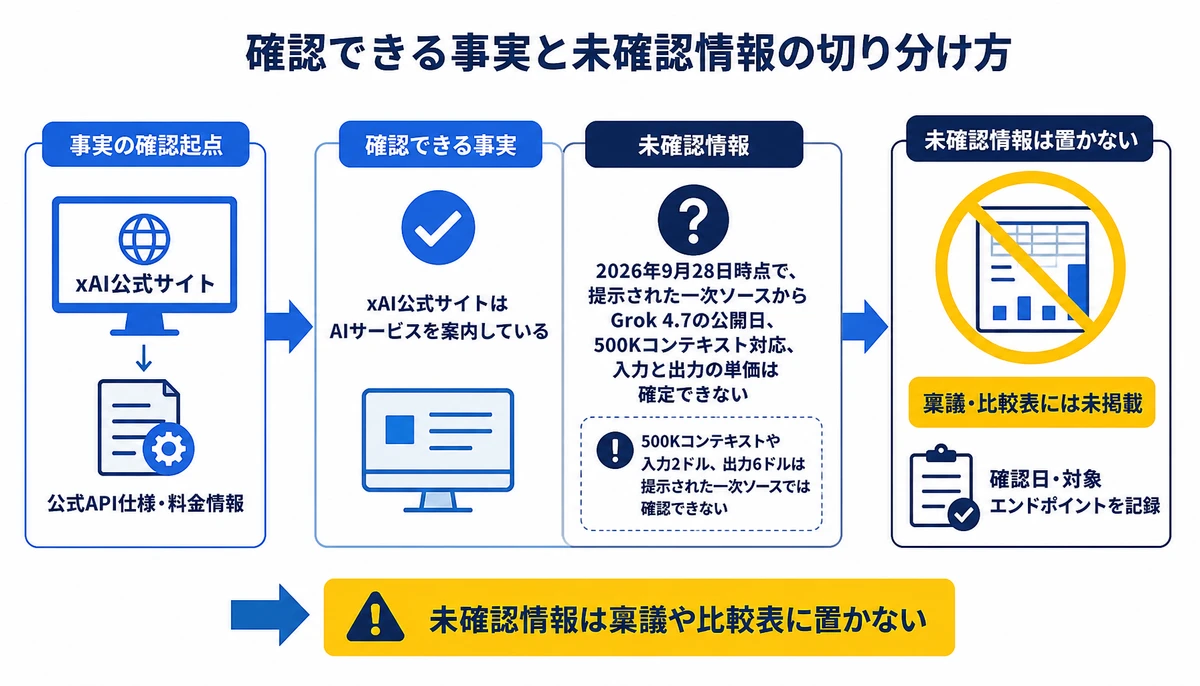
まず、確認できる事実と未確認の情報を分けます。xAIの公式サイトは、同社のAIサービスを案内しています。企業利用の候補として見る場合も、公式のAPI仕様と料金情報が確認の起点です。
一方、今回の確認材料だけでは、Grok 4.7の公開日、500Kコンテキスト対応、入力と出力の単価は確定できません。したがって、500Kという容量や具体的な料金を事実として稟議や比較表に置く段階ではありません。
- 公開日、公式発表とAPI提供開始日を分けて確認する
- 対応範囲、チャット、API、コード、ツール利用の対象を分ける
- コンテキスト長、最大値だけでなく実際に処理できる文書量を測る
- 料金、入力、出力、キャッシュ、ツール利用などの課金条件を確認する
- 利用条件、データ保持、学習利用、権限管理、障害時の扱いを確認する

500Kコンテキストを業務で測る視点
容量の大きさより参照精度と処理時間を見る
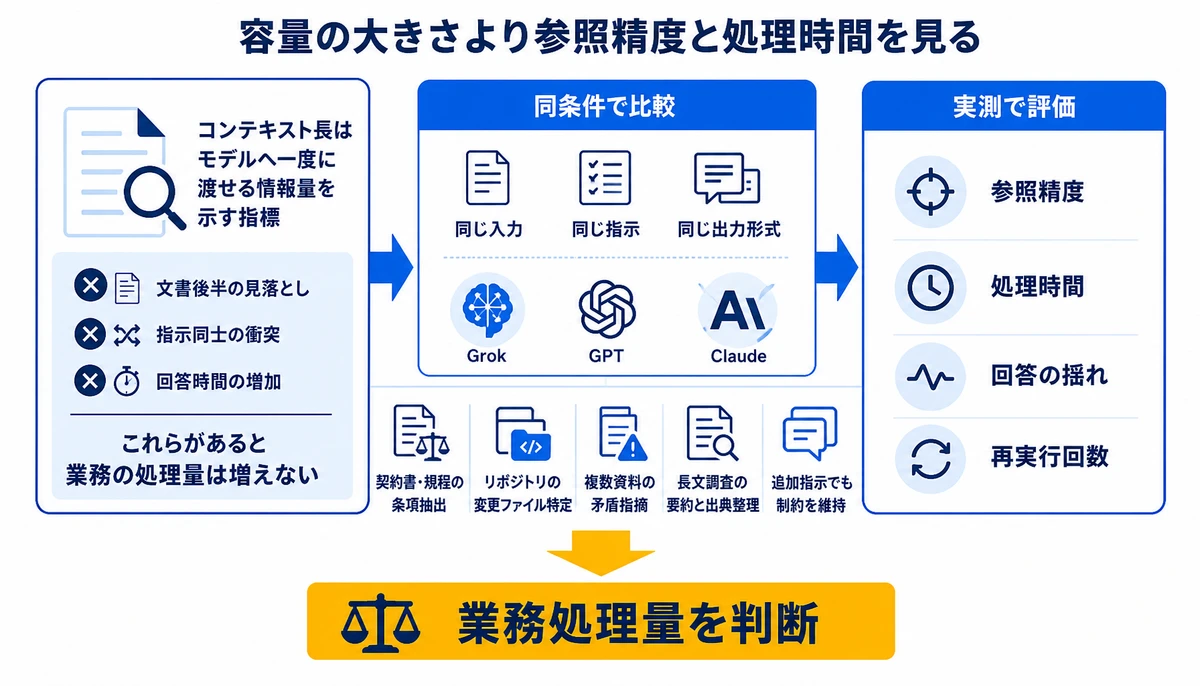
コンテキスト長は、モデルへ一度に渡せる情報量を示す指標です。上限が大きくても、文書の後半を見落とす、指示同士が衝突する、回答までの時間が伸びるなら、業務の処理量は増えません。
Grok 4.7をGPTやClaudeと比べるときは、同じ入力、同じ指示、同じ出力形式にそろえます。長文を読めるかではなく、必要な箇所を正しく参照し、根拠を残せるかを確認します。
- 契約書や規程から、指定した条項だけを抜き出す
- 長いリポジトリから、変更が必要なファイルを特定する
- 複数資料の矛盾を指摘し、該当箇所を示す
- 長文調査を日本語で要約し、出典と未確認点を分ける
- 途中で追加指示を出しても、元の制約を維持する
ここで測るのは、最大入力の一度きりの成功ではありません。資料量を増やしたときの処理時間、回答の揺れ、再実行の回数を業務ごとに記録します。
料金を1業務あたりで比較する
単価より「完了コスト」で判断する
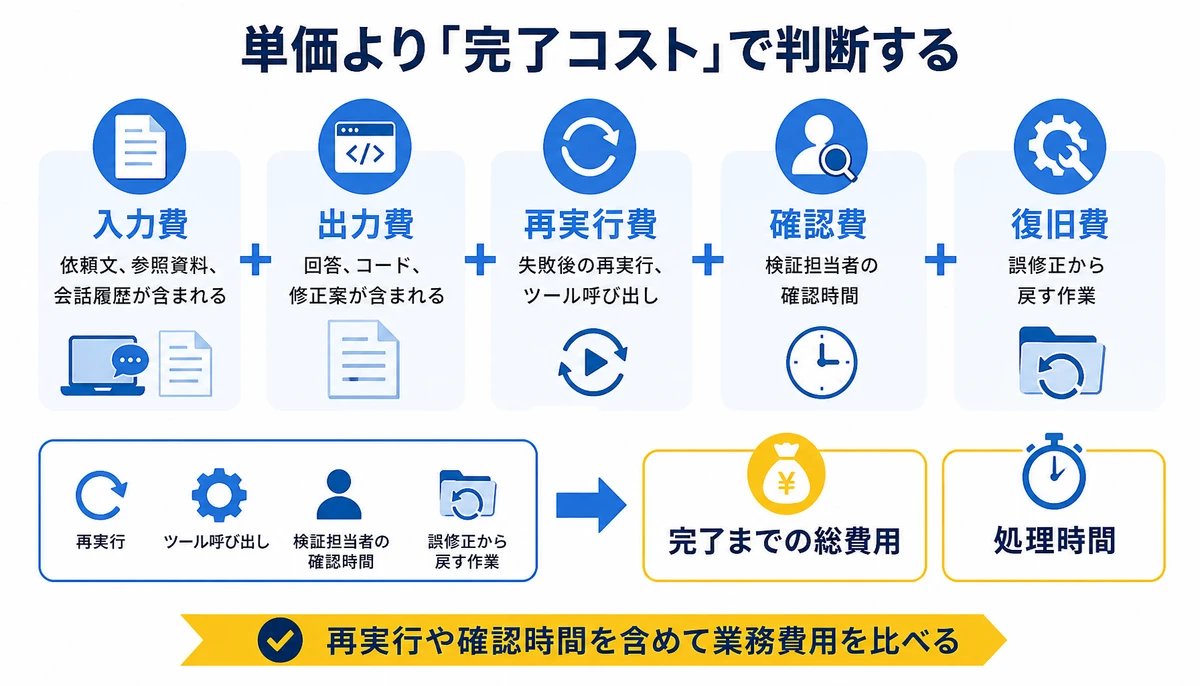
API料金は、モデル単価だけでは比較できません。1回の入力と出力に加えて、失敗後の再実行、ツール呼び出し、検証担当者の確認時間まで含めると、業務単位の費用が見えてきます。
たとえばコード修正では、初回のパッチが通らず再実行することがあります。調査業務では、要約の誤りを人が再確認する時間が生じることも少なくないでしょう。単価が低いモデルでも、やり直しが多ければ比較結果は変わるでしょう。
- 入力費、依頼文、参照資料、会話履歴の量を記録する
- 出力費、回答、コード、修正案の長さを記録する
- 再実行費、失敗や指示変更で何回呼び出したかを数える
- 確認費、人が事実確認やテストに使った時間を測る
- 復旧費、ツール失敗や誤修正から戻す作業を記録する
Grok APIの料金が公式に確認できた後は、同じ業務データでGPTやClaudeにも実行します。比較表には、単価ではなく、完了までの総費用と処理時間を並べてください。
日本語業務データの検証設計
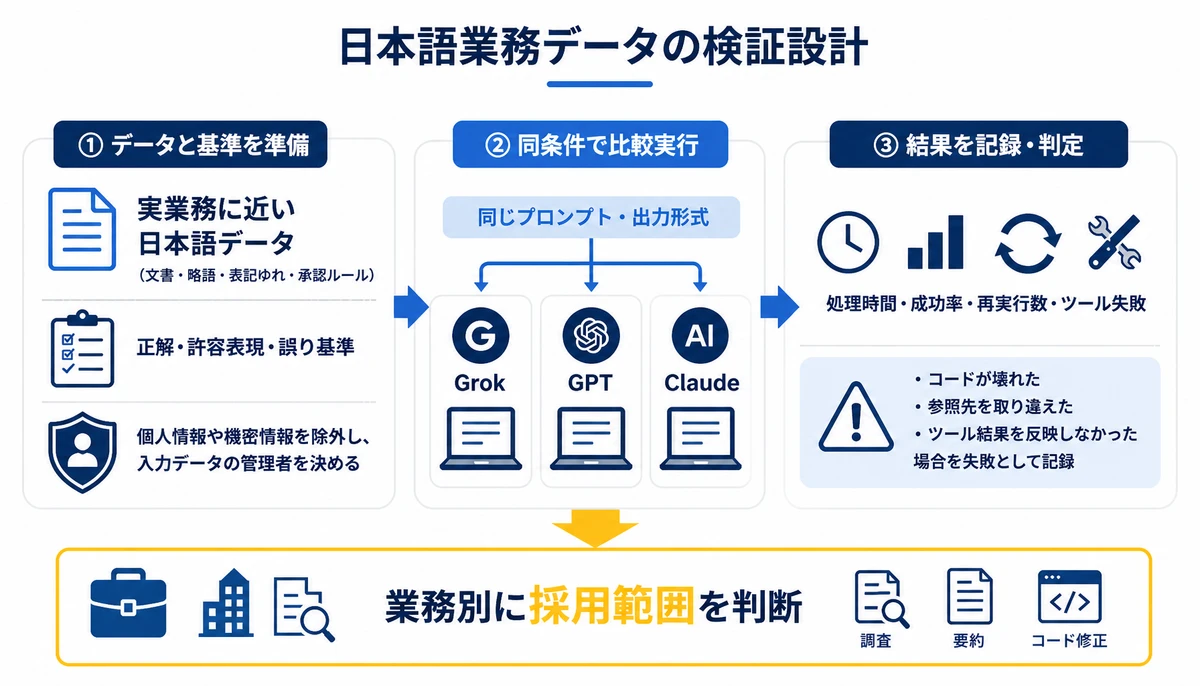
日本語品質は、一般的な質問への印象だけでは測れません。社内で実際に使う文書、略語、表記ゆれ、承認ルールを含むデータを用意し、モデル名を隠して評価します。
- 過去に完了した問い合わせや調査を評価用に分ける
- 正解、許容できる表現、誤りとして扱う表現を先に決める
- 同じプロンプトと出力形式でGrok、GPT、Claudeを実行する
- 処理時間、成功率、再実行数、ツール失敗を記録する
- 個人情報や機密情報を除外し、入力データの管理者を決める
長時間タスクの失敗率は、作業単位で数えます。途中でコードが壊れた、参照先を取り違えた、ツールの結果を反映しなかった場合を失敗として記録し、最終回答だけで合否を決めない方法です。
評価結果は、モデルの優劣を一度で決めるために使いません。調査、要約、コード修正など、業務ごとに適したモデルが分かれる可能性を残して、採用範囲を判断します。

自社検証で詰まりやすい箇所
企業が自社だけで比較を始めると、評価データの選び方と合否基準で止まりやすくなります。長文資料を用意しても、正解や確認時間を決めていなければ、500Kコンテキストの実用性を判断できません。
- 実業務に近い日本語データを匿名化できない
- Grok、GPT、Claudeで同じ条件を保てない
- 長時間タスクの失敗と再実行を記録できない
- API料金を人の確認時間と合わせて集計できない
外部の支援を使う場合は、モデルを先に決めるのではなく、現場の課題と現在の作業を診断してから要件を整理できます。BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めるのが特徴です。
見積は一式ではなく、要件を整理したうえで詳細に示します。契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進め、企画から開発、内製化まで同じ担当が一気通貫で受け持ちます。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Grok 4.7は企業で使えますか?
現時点では、企業利用の可否をGrok 4.7固有の仕様として断定できません。公式APIの提供範囲、データ保持、権限、料金、障害時の扱いを確認し、自社データで評価してください。
500Kコンテキストなら長文業務に最適ですか?
容量だけでは判断できません。長文の後半まで正確に参照できるか、処理時間が許容範囲か、追加指示後も制約を守れるかを、実際の文書で測る必要があります。
GrokとGPTやClaudeはどう比較しますか?
同じ日本語データ、同じ指示、同じ出力形式で実行します。品質だけでなく、処理時間、長時間タスクの失敗率、再実行数、ツール利用の復旧負荷、1業務あたりの費用を並べてください。
AIコーディングで最初に測る業務は何ですか?
既存コードの小さな修正、テスト作成、エラー原因の調査から始めるのがおすすめです。変更ファイル数、テスト通過、レビュー修正、処理時間を記録すると、長時間タスクへ広げる判断材料になります。
料金表が見つからない場合はどうしますか?
未確認の単価を予算に入れず、xAI公式のAPI仕様と料金情報を確認しましょう。確認できるまでの比較では、費用を仮置きせず、入力量、出力量、再実行回数を先に測っておくと後から計算できます。
参考・出典
Grok 4.7の企業導入を考えるとき、500Kコンテキストや見かけの単価だけで採用を決めるのは早計です。公式情報を確認したうえで、日本語の実業務を使い、処理時間、失敗率、復旧負荷、1業務あたりの費用をGPTやClaudeと同じ条件で比べることから始めてください。
本記事に挙げた他社の料金や制度は、執筆時点で公開されていた情報です。お申し込みの前に、各社の最新の内容をご確認ください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
自社モデルではないAIを標準搭載Mistralの狙いと企業の注意点
Mistral AIがVibe CodeやVS Code拡張などにGLM 5.3を標準搭載したと報じられました。AIコーディングツールの選定で確認すべきモデルの出自、コード送信、データ保持、切り替え方を整理します。
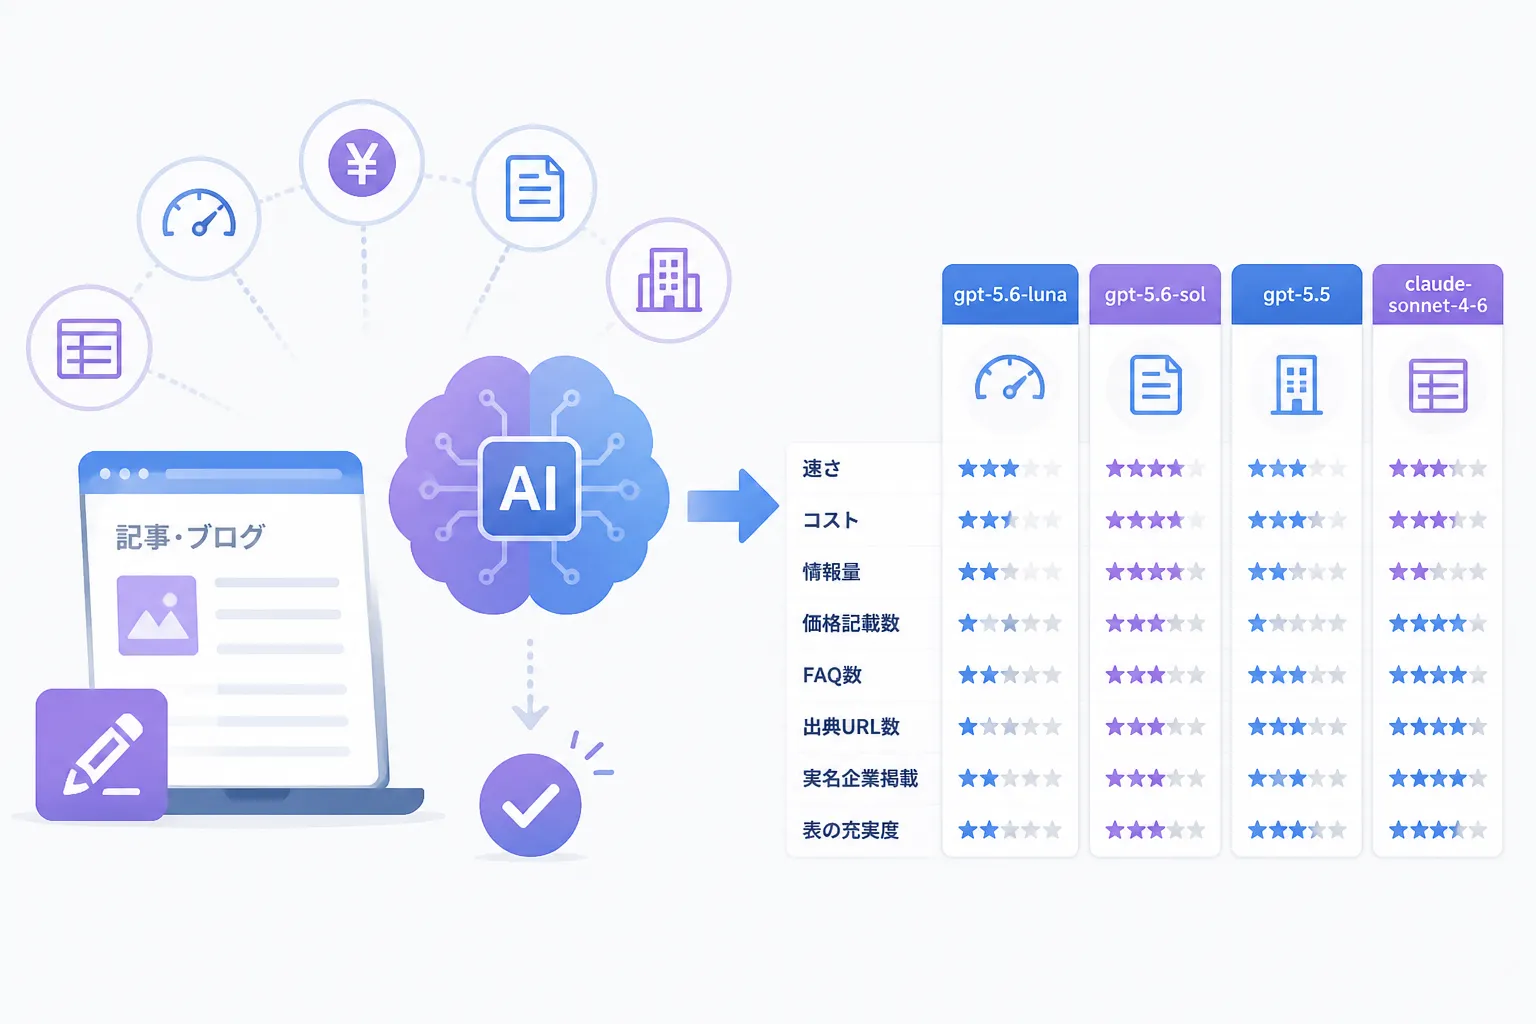
記事・ブログ自動生成に最適な生成AI(ChatGPT/Grok/Claude)モデル比較【最新版】
BinxAIの一次データをもとに、同じ指示文・テーマ・ウェブ検索条件でChatGPT系、Claude系、Grokの8モデルを比較。生成時間やコスト、文字数、価格・FAQ・出典URLの記載数を検証し、SEO記事や比較記事など用途別の選び方を解説します。
GLM-5.3-FlashはGPTやClaudeの代替になるか
GLM-5.3-Flashが2026年8月に発表されました。GPTやClaudeとの単純な性能比較ではなく、API費用、機密データ、自社GPUやクラウド運用、ライセンス、安全性を踏まえた検証手順を整理します。















