
データを外に出せない現場へ、Meta Muse Glimmer 30Bが変えるローカルAI
要約
Meta Superintelligence LabsがApache 2.0ライセンスのオープンウェイト・マルチモーダルモデル「Muse Glimmer 30B」を発表しました。クラウドへのデータ送信なしにエージェント機能を動かせる同モデルが、製造・医療・金融のオンプレミスAI導入にどう影響するかを解説します。
「AIを使いたいが、データを外に出せない」という声は、私たちが関わってきた現場でも繰り返し聞かれます。
2026年8月、その状況を変え得るモデルがMetaから登場しました。Muse Glimmer 30Bです。
オープンウェイト・マルチモーダル・ローカル動作という三つの条件を同時に満たす点が、業界の注目を集めています。
この記事の対象読者
- オンプレミスまたはプライベートクラウドでのAI導入を検討している情報システム部門・DX推進担当者
- クラウドAPIへのデータ送信に制約がある製造・医療・金融業界の実務担当者
- ローカルLLMの選択肢を定期的に調査しているエンジニアやAIプロジェクトリーダー
- Apache 2.0ライセンスのオープンウェイトモデルで商用プロダクトを構築したい開発者
Meta Superintelligence Labsが「Muse Glimmer 30B」を発表
モデルの基本スペック
2026年8月10日前後、Meta Superintelligence LabsがMuse Glimmer 30Bを公開しました。
パラメータ数は30Bで、テキストと画像を統合して処理するマルチモーダルアーキテクチャを採用しています。
Apache 2.0ライセンスの意味
ライセンスはApache 2.0。改変・再配布・商用利用を幅広く認める条件です。
企業が自社製品やサービスに組み込む際の法的ハードルが低い点が特徴になります。
ローカルGPU動作への対応
もう一つの柱がローカルGPU動作への対応です。
同モデルはクラウドAPIを経由せず、社内に設置した一般向けGPU上で推論を完結させることを前提に設計されています。

ローカルLLM市場の競争が30Bクラスで激化している背景
小さくても高性能という潮流
ここ数年、Kimi K3やGLM系モデルなど、海外発のオープンウェイトモデルが相次いで登場してきました。
共通するトレンドは「高性能を保ちながらパラメータ数を絞り、民生GPU上での実行を現実的にする」という方向性です。
Muse Glimmer 30Bの新しさ
Muse Glimmer 30Bはその流れにマルチモーダルとエージェント機能を加えた点が新しい。
テキストだけでなく画像も入力として扱えるため、図面・帳票・スキャン書類を処理するユースケースに対応しやすくなっています。
| モデル | パラメータ規模 | マルチモーダル | ライセンス | ローカル動作 |
|---|---|---|---|---|
| Muse Glimmer 30B | 30B | 対応 | Apache 2.0 | 前提として設計 |
| Llama 3シリーズ | 8B〜70B | 一部対応 | Llama Community License | 対応 |
| GLM系モデル | 6B〜130B | 一部対応 | モデルにより異なる | 対応 |
| Kimi K3 | 非公開 | 対応 | 商用条件あり | 限定的 |
上の比較はあくまでも公開情報をもとにした整理です。各モデルのベンチマーク性能や実運用での動作は環境によって大きく異なります。
製造・医療・金融の現場でオンプレミス導入議論はどう変わるか
最大のボトルネックはクラウド接続
私たちがこれまで見てきた範囲では、データセキュリティ要件が厳しい業種ほど導入が難しくなります。
とりわけ「クラウドAPIへの接続」がAI導入の最大のボトルネックになりがちです。
データを社内に留めたまま動かす選択肢
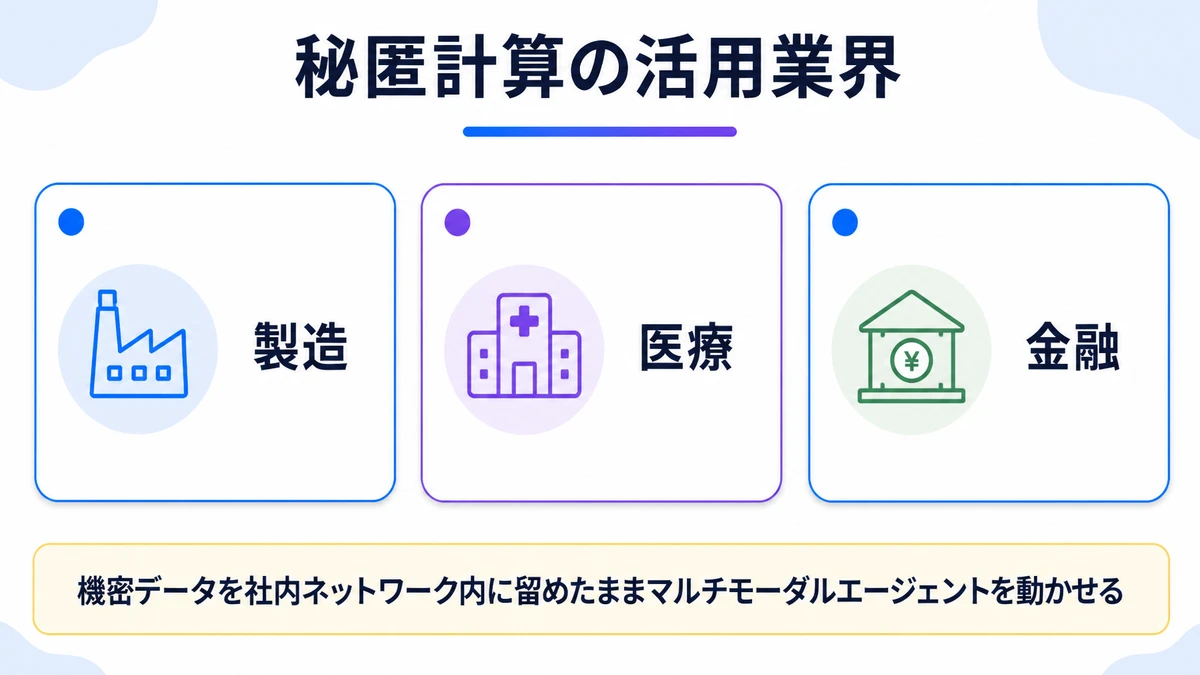
Muse Glimmer 30Bが実用的に使えると判断した場合、新しいシナリオが見えてきます。
機密データを社内ネットワーク内に留めたままマルチモーダルエージェントを動かせるという選択肢が現実的になります。
- 製造: 設計図・検査画像・不具合レポートをローカルで一括処理し、外部送信なしに品質判定を補助する
- 医療: 画像診断支援や電子カルテ要約を院内サーバーで完結させ、個人情報を院外に出さない
- 金融: 契約書・帳票のOCR処理と内容分析をオンプレミスで行い、規制対応コストを抑える
GPUメモリという前提条件
ただし、30Bモデルを快適に動かすにはGPUメモリの確保が前提です。
現時点で想定される目安はVRAM 24GB以上。量子化(4bit・8bit)によって要件を下げられる可能性もあります。
実際の導入前には自社の既存GPUスペックとの照合が欠かせません。
よくある質問
Apache 2.0ライセンスなら社内システムに自由に組み込めますか?
Apache 2.0は商用利用・改変・再配布を幅広く認めるライセンスです。ただし「著作権表示とライセンス文書の保持」が条件になります。
社内法務・コンプライアンス部門と確認したうえで利用規約を整備することをお勧めします。
30Bモデルはどのくらいのスペックのサーバーで動きますか?
フルprecisionで動かす場合、VRAM 40GB以上のGPUが現実的です。4bit量子化を使えばVRAM 24GB前後まで要件を下げられる可能性があります。
ただし量子化による精度変化は用途ごとに評価が必要です。
Llama 3との使い分けはどう考えればよいですか?
Llama 3系はテキスト中心の用途で実績が豊富です。
一方、Muse Glimmer 30Bはマルチモーダル入力とエージェント機能を最初から想定している点が異なります。
画像・図面・帳票を扱うユースケースではMuse Glimmer 30Bを先に評価する価値があるでしょう。
Kimi K3やGLM系との比較でMetaモデルを選ぶ理由は?
ブランド信頼性と法務的な明確さが一つの判断軸になります。
Apache 2.0ライセンスの解釈はIT法務の実務でも蓄積があり、Metaの継続的なモデル更新実績も参照しやすい。
Kimi K3は商用条件の解釈が複数あり得るため、法務確認に時間がかかるケースが多い印象です。
エージェント機能とはどういう意味ですか?
単純な質問応答だけでなく、ツール呼び出し・複数ステップの推論・環境との対話を自律的にこなせる機能を指します。
例えば「図面を見て部品リストを抽出し、在庫DBと照合してレポートを作る」といった処理を想定してください。
こうした一連の作業を人が介在せずに実行できる点が、通常の生成モデルとの違いです。

あわせて読みたい
まとめと最初の一手
Meta Muse Glimmer 30Bの登場は、「ローカルで動くマルチモーダルエージェント」という選択肢を現実的にしました。
まだ発表直後であり、実運用での性能評価はこれから積み上がっていく段階です。
まず今日、社内サーバーのGPU型番とVRAM容量を1枚のリストにまとめてください。
そのうえで自社のセキュリティ要件とユースケースを照らし合わせ、早めにPoC計画を立てることが次の一手になります。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
MetaがMuse Glimmerをオープンウェイト公開 ローカルLLMの選択肢が本格化してきた
MetaがMuse Glimmerのオープンウェイト公開を発表し、さらに最上位モデルMuse Spark 1.2も数週間以内に解放予定と明かした。クラウドAPIへのデータ送出を規制で制限される企業にとって、フロンティア水準のモデルがオンプレミスで動く意味は小さくない。この記事ではニュースの事実と、企業が今すぐ検討すべき実務上の論点を整理する。

GLM-5.2とKimi K2.7が示すオープンLLMの実用域。Fuguは別の道を行く
2026年6月、GLM-5.2とKimi K2.7の登場でオープンソースLLMが実用水準に近づき、Sakana FuguはAPI型のマルチエージェント基盤という別路線で注目を集めました。自社環境でのLLM運用を検討するときの、各モデルの特徴と選定の考え方を整理します。
Ornith-1.5公開 オープンウェイトLLMは企業で使えるか
Ornith-1.5が9B密モデルから397B MoEまでの構成と複数の量子化形式で公開されました。MITライセンスの商用利用、自社GPUでの実行、APIとの費用や運用負担の違いを整理し、企業が検証前に確認すべき項目を解説します。















