
Meta Muse Spark OpenでローカルAIは次の段階へ
要約
Metaが公開したMuse Spark Openは、オープンウェイトとローカル実行の選択肢を企業に広げます。性能や計算資源、APIとの費用、安全性、責任分界を整理し、導入前に比較すべき項目を紹介します。
Metaが新しいオープンウェイトモデルを公開しました。企業が生成AIを利用する場所は、クラウドAPIだけでなく、自社GPUや国内クラウドを含む構成へ広がりつつあります。
この記事の対象読者
次の課題を抱え、ローカルLLMや企業向け生成AIの選択肢を調べている方に向けた内容です。
- 機密情報を外部AIへ送れない企業
- 自社GPUでLLMを運用したい組織
- AIエージェントを内製したい企業
- クラウドAPI費用を見直したい企業
- 複数のLLMを比較調達したい企業
Metaが公開したMuse Spark Open
モデルの概要と提供形態
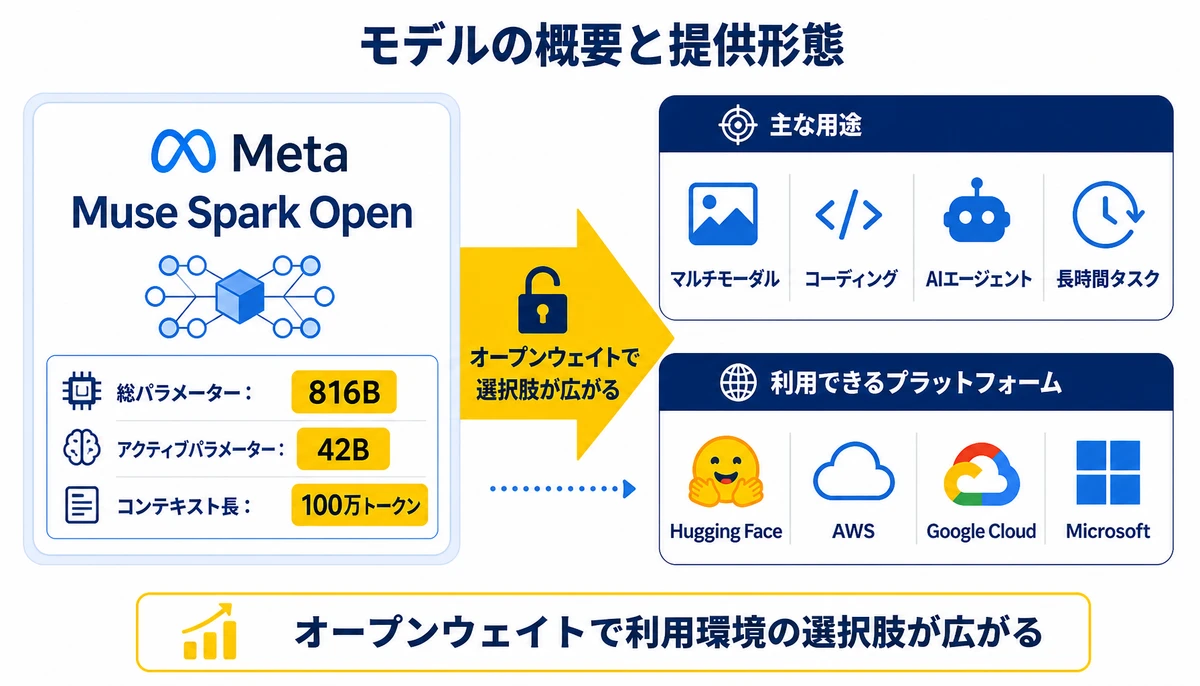
Metaは2026年10月15日、オープンウェイトモデルMuse Spark Openを公開しました。オープンウェイトは、モデルの重みを利用者が取得し、自社の環境で動作検証しやすい提供形態です。
Metaの公開情報では、総パラメーターは816B、アクティブパラメーターは42Bです。コンテキスト長は100万トークンに対応するとされています。
- マルチモーダル対応を掲げるモデル
- コーディングを想定した利用
- AIエージェントによる長時間タスク
- Hugging Face、AWS、Google Cloud、Microsoftでの利用
MetaはApple M5 Ultra搭載Mac Studio 2台によるローカル実行例も示しています。ただし、この例だけで一般的な企業環境の必要スペックや処理速度を判断することはできません。

ローカル実行で増える判断材料
環境構成で確認すべき項目
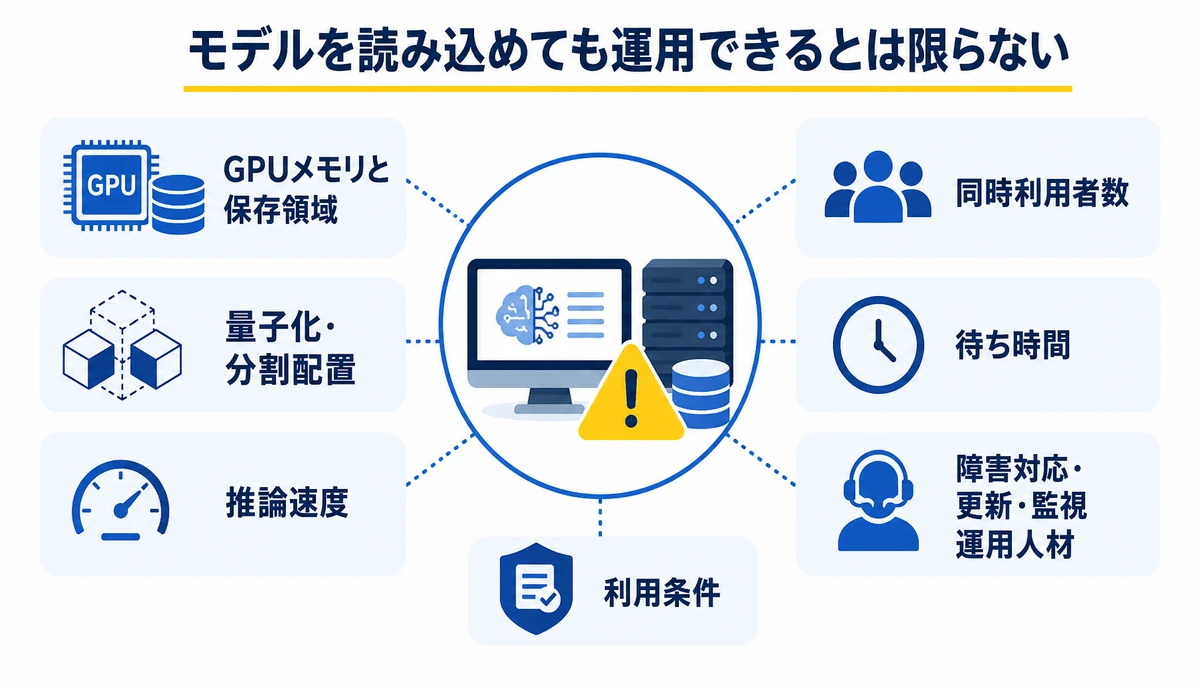
大規模モデルを自社環境で動かす場合、モデルを読み込めるかだけでは足りません。推論速度、同時利用者数、保存領域、監視方法まで含めて構成を考える必要があります。
- モデルを保持するためのGPUメモリと保存領域
- 量子化や分割配置を含む推論方式
- 利用者数に応じた処理速度と待ち時間
- 障害対応、更新、監視を担う運用人材
- モデルの利用条件と社内データの管理範囲
Metaが示したMac Studio 2台の例は、ローカル実行の可能性を示す材料です。自社で同じ構成を再現できるという保証ではないため、実際の業務データと利用人数で検証する必要があります。
API費用と自社運用費用の比較
比較表で見る費用構造の違い
クラウドAPIは、初期のGPU調達や保守を抑えて始めやすい選択肢です。一方で、利用量が増えるとAPI利用料が積み上がり、データを外部環境へ送る設計も確認対象になります。
| 比較項目 | クラウドAPI | 自社運用・ローカル実行 |
|---|---|---|
| 開始時の負担 | 環境構築を抑えやすい | GPUや推論環境の準備が必要 |
| 費用の出方 | 利用量に応じて変動 | 設備、電力、保守、人材の費用が発生 |
| データ境界 | 送信先と保存条件の確認が必要 | 自社で管理しやすい構成を設計可能 |
| 運用責任 | API提供側と自社で分担 | モデルからインフラまで自社の責任範囲が広い |
比較では、1回の推論単価だけを見ないことが大切です。GPUの調達費、電力、保守、監視、障害対応、担当者の稼働を含めた継続費用で並べると、用途ごとの向き不向きが見えやすくなります。
企業導入で分ける安全性と責任
社内に置いても設計が必要な理由
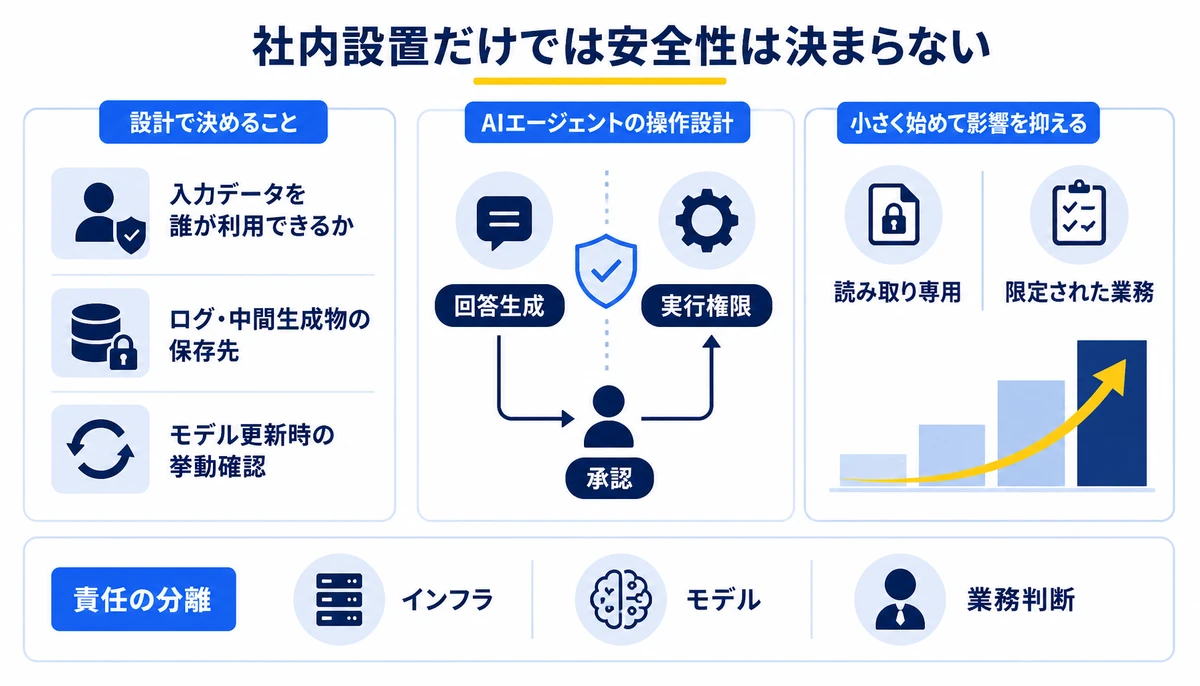
機密情報を外部AIへ送れない場合、ローカル実行は検討しやすい構成です。ただし、社内に置けば自動的に安全になるわけではありません。
- 入力データを誰が利用できるか
- ログや中間生成物をどこに保存するか
- モデル更新時に挙動をどう確認するか
- 誤回答や誤操作が起きた際の確認者を誰にするか
- インフラ、モデル、業務判断の責任をどこで分けるか
AIエージェントに社内システム操作を任せる場合は、回答生成と実行権限を分けて設計します。最初は読み取り専用のデータや限定された業務から始めると、失敗時の影響を抑えやすくなるでしょう。海外では、オープンウェイトモデルを自社環境で検証する動きが広がっています。

小さく比べるローカルAIの用途
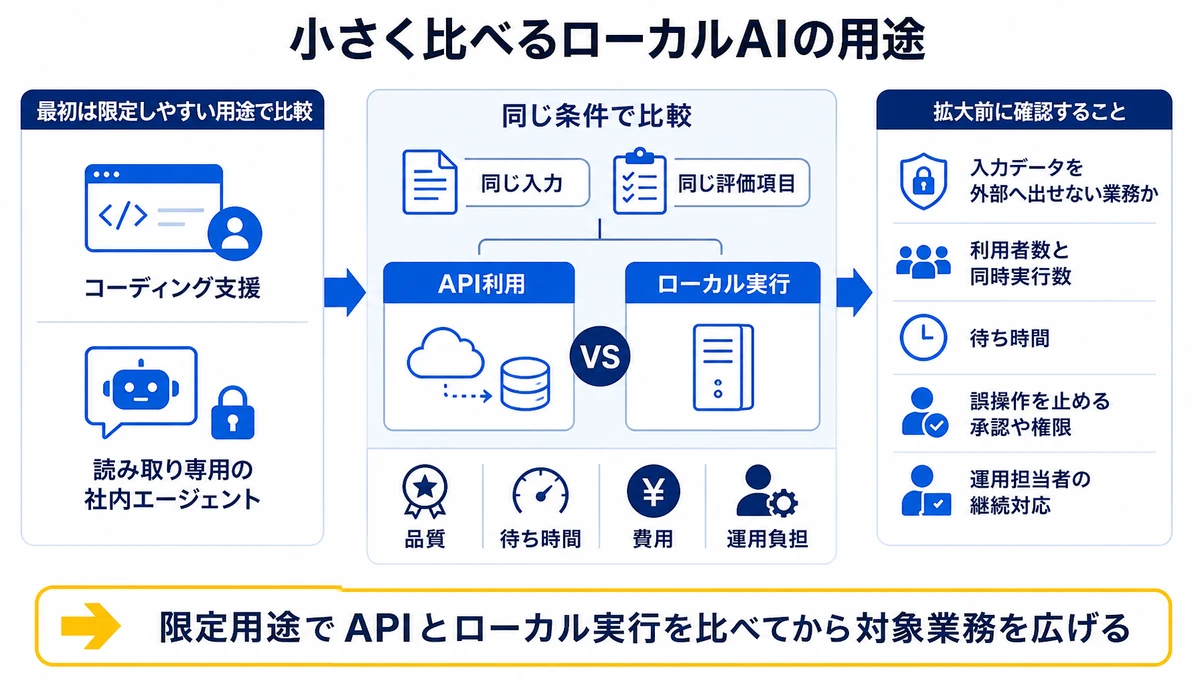
BinxAIが見てきた範囲では、現場で問われるのはモデルを動かせるかより、継続して使える構成かどうかです。
まずはコーディング支援や社内エージェントのように、対象データと権限を限定しやすい用途で比べるのがおすすめです。API利用とローカル実行を同じ入力、同じ評価項目で確認すると、費用と品質の差を説明しやすくなるでしょう。
- 入力データを外部へ出せない業務か
- 利用者数と同時実行数を見積もれるか
- 回答品質だけでなく待ち時間も許容できるか
- 誤操作を止める承認や権限を置けるか
- 運用担当者が更新と障害対応を続けられるか
ローカルAIの採否は、モデルの性能だけでなく、データ境界と運用責任を含む業務単位で決める段階に入っています。
自社検証で詰まりやすい箇所
Muse Spark Openのような大規模モデルを試すと、GPU構成の選定だけでなく、評価用データの準備や権限設計も必要になります。
検証担当者がモデル、インフラ、業務のすべてを抱えると、比較が止まりがち。
- 自社データを使った評価条件が決まらない
- APIとローカル実行の費用項目を揃えられない
- モデル更新後の再評価と責任者が決まらない
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく、要件を整理した詳細な見積を提示し、契約後に要件が動いても決めた範囲で優先順位を入れ替えて進めます。
企画、課題整理、要件整理から開発までを同じ担当が受け持ちます。ローカル実行とAPIの比較を踏まえ、運用の引き継ぎや内製化まで見据えて進める形です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Muse Spark Openは完全に無料で使えますか?
オープンウェイトであることと、運用費用が不要であることは別です。GPU、電力、保存領域、保守、人材、利用条件を確認して判断してください。
ローカル実行にはどのGPUが必要ですか?
必要な計算資源は、モデルの配置方法、量子化、処理速度、同時利用者数で変わります。Metaが示したMac Studio 2台の例は参考になりますが、自社環境での再現性は別途検証が必要です。
APIより自社運用が安くなりますか?
利用量や運用体制によって結果は変わります。API単価だけでなく、GPU調達、電力、保守、監視、担当者の稼働を含めて比較すると判断しやすくなります。
社内の機密情報を扱うAIエージェントに使えますか?
候補にはなりますが、モデルを置く場所だけで安全性は決まりません。権限、ログ、承認、誤操作時の責任者を設計し、限定された業務から検証してください。
まず何を検証すればよいですか?
コーディング支援や読み取り専用の社内エージェントなど、データ境界と権限を限定しやすい用途が候補です。同じ評価データでAPIとローカル実行を比べ、品質、速度、費用、運用負担を記録します。
Muse Spark Openの公開は、企業が生成AIを利用する場所を選びやすくする動きです。まずは限定用途でAPIとローカル実行を比べ、データ境界、総運用費、責任分界を確認してから対象業務を広げていくとよいでしょう。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Metaが企業向けAI基盤へ モデル単体競争の次に来るもの
Meta Enterprise Platformの構想から、企業向けAIの競争軸がモデル性能から基盤全体へ移る可能性を読み解きます。既存システムとの接続、マルチモデル、データ管理境界、ロックインを避ける調達条件まで、導入前に確認したい論点を整理します。
GLM-5.3-FlashはGPTやClaudeの代替になるか
GLM-5.3-Flashが2026年8月に発表されました。GPTやClaudeとの単純な性能比較ではなく、API費用、機密データ、自社GPUやクラウド運用、ライセンス、安全性を踏まえた検証手順を整理します。
Step 5 Previewの性能とコスト 企業のAIエージェント運用に使えるか
StepFunのStep 5 Previewが発表されました。600B規模のMoEモデルを企業のAIエージェントで使うとき、API利用と重みを使った自社運用をどう比較するか、GPU費用やライセンス確認を含めて整理します。















