
AIエージェントの学習と運用を分断しないMicrosoft Agent Lightningの実力
要約
Microsoft Agent Lightning v1.0が公開されました。既存コードやツールを活かしてAIエージェントを強化する仕組みと、SWE-benchの性能報告を整理し、企業が評価・安全設計・小規模検証を進める手順を解説します。
AIエージェントを試作したものの、本番業務で使い始めると改善が止まる。そんな分断は、学習用の環境と運用中のコードを別々に作る負担から生まれやすいでしょう。
海外では、AIエージェントの実行結果を強化学習へつなぎ、複数の手順を含むタスクを改善する実装が議論されています。Microsoft Agent Lightningは、その議論を既存のエージェント開発へ近づける取り組みです。
この記事の対象読者
次のような課題を抱える企業や組織に向けた内容です。
- AIエージェントを本番業務へ広げたい企業
- AI開発を内製化したい企業
- PoC後の改善が止まっている組織
- 既存システムを変えずにAIを強化したい企業
- AIの評価環境を整えたい企業
Microsoft Agent Lightning v1.0の公開
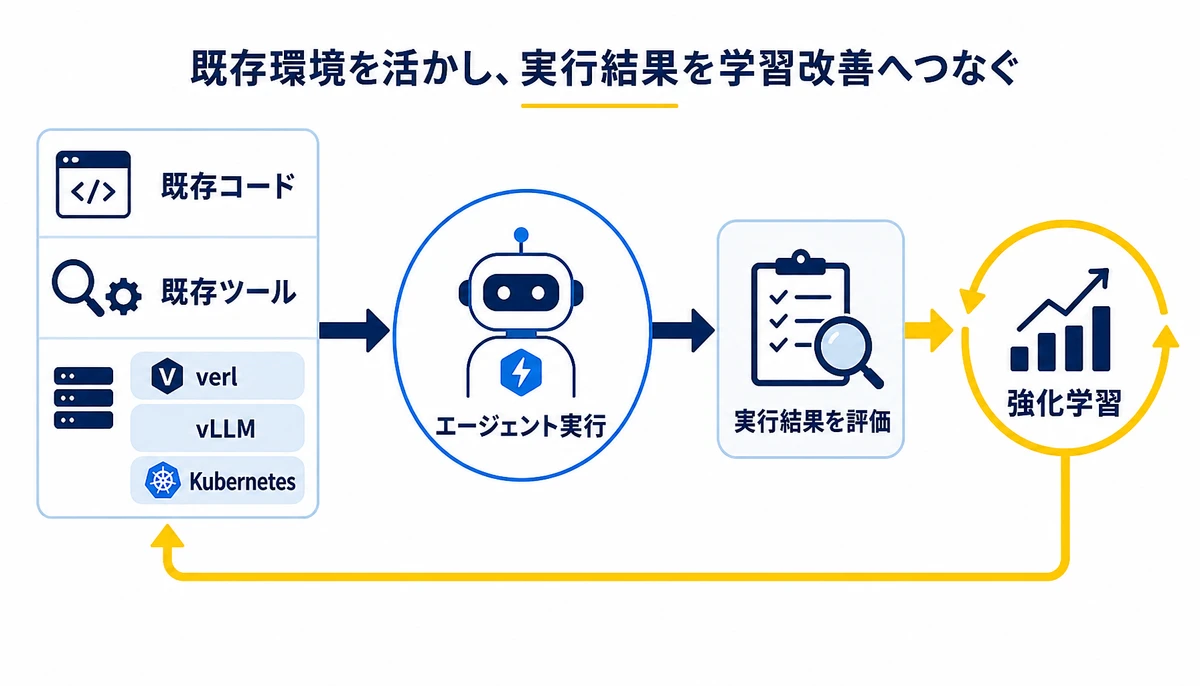
Crypto Briefingが報じた内容によると、Microsoftは2026年8月17日、オープンソースの強化学習フレームワークAgent Lightning v1.0を公開しました。既存のコードやツール、実行環境を大きく変更せず、AIエージェントを強化できる点を打ち出しています。
ここでいう強化学習は、エージェントの行動結果を評価し、その結果を次の改善に反映する手法です。一般的なチャット応答だけでなく、ツール呼び出しや複数段階の処理を含む業務で検証しやすい設計が意識されています。
- 既存コードを活かす、エージェント本体を大きく書き換えずに学習へ接続する
- 既存ツールを活かす、業務で使っている検索や処理手段を前提に改善する
- 実行基盤に対応する、verl、vLLM、Kubernetesと組み合わせられる
- 改善結果を測る、エージェントの実行結果を評価し、学習に使う

SWE-benchで報告された性能向上
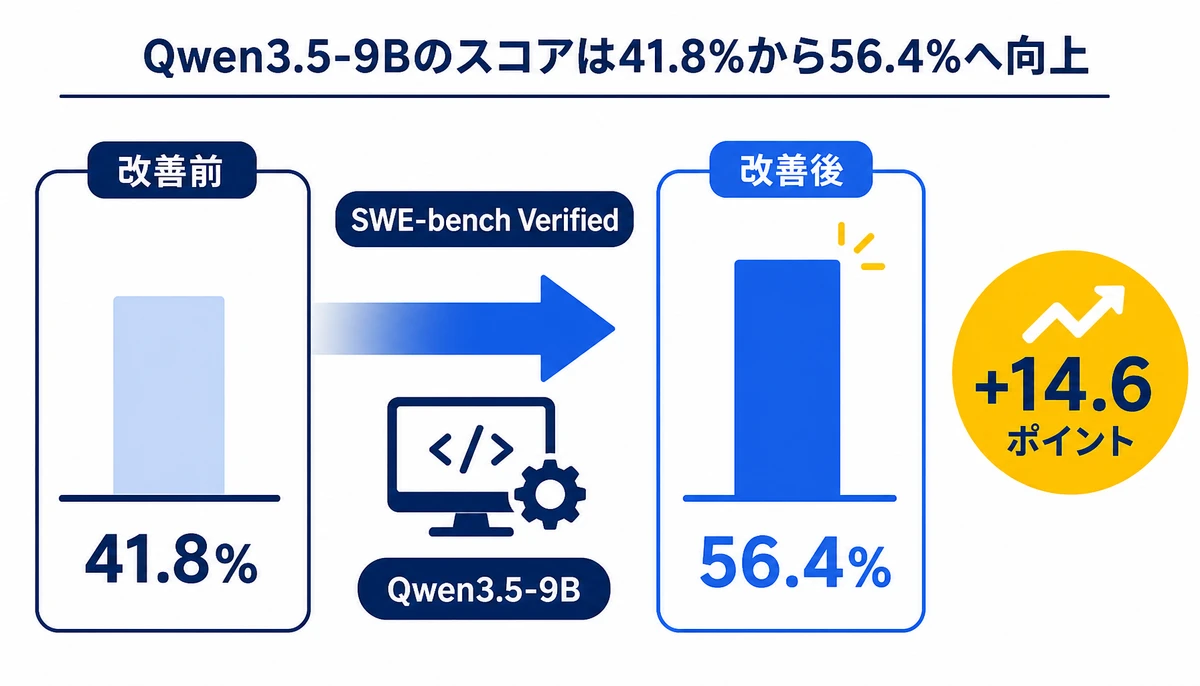
公開情報では、コード修正能力を測るベンチマークSWE-bench Verifiedを使った検証結果も示されています。Qwen3.5-9Bを用いた検証で、スコアは41.8%から56.4%へ上がり、14.6ポイントの改善が報告されました。
| 検証項目 | 改善前 | 改善後 | 差分 |
|---|---|---|---|
| SWE-bench Verifiedのスコア | 41.8% | 56.4% | 14.6ポイント |
この結果は、強化学習によって特定のベンチマーク上の性能が改善する可能性を示します。一方で、社内文書の参照、顧客対応、承認処理などの業務品質を直接表す数字ではありません。
ベンチマークの向上と、業務で安全に使えることは同じ指標ではありません。企業では、モデル性能と業務成果を別の評価軸で記録することが求められるでしょう。
本番コードと学習環境の接続
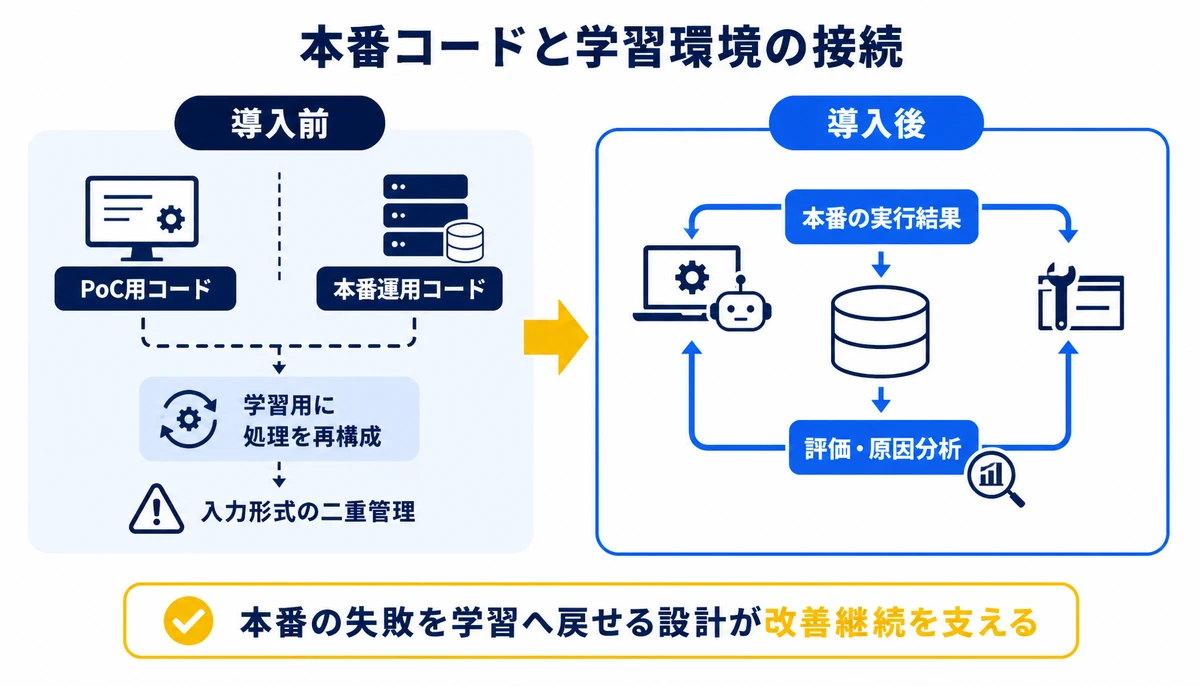
AIエージェント開発では、PoC(概念実証)用のコードと本番運用のコードが分かれるケースがあります。学習用に処理を組み直すほど、本番で起きた失敗を学習へ戻す作業が重くなります。
Agent Lightningの方向性は、運用中のエージェントやツールを活かしながら、実行結果を改善サイクルへ取り込むことです。BinxAIが見てきた範囲でも、導入後に残りやすい課題はモデル選びより、評価データと運用ルールの接続にあります。
- 本番の処理と学習用の処理で、入力形式を二重に管理しないか
- 失敗した実行を、原因別に再現できる記録として残せるか
- エージェントの回答だけでなく、ツール選択や権限利用も評価できるか
- 学習による変更を、本番へ反映する前に承認できるか
学習と運用を同じ流れで扱えるかは、導入後に改善が続くかを左右する設計論点です。既存コードを変えないこと自体ではなく、変更を小さく保ちながら評価を反復できることが焦点といえるでしょう。
企業導入で先に決める評価と安全設計
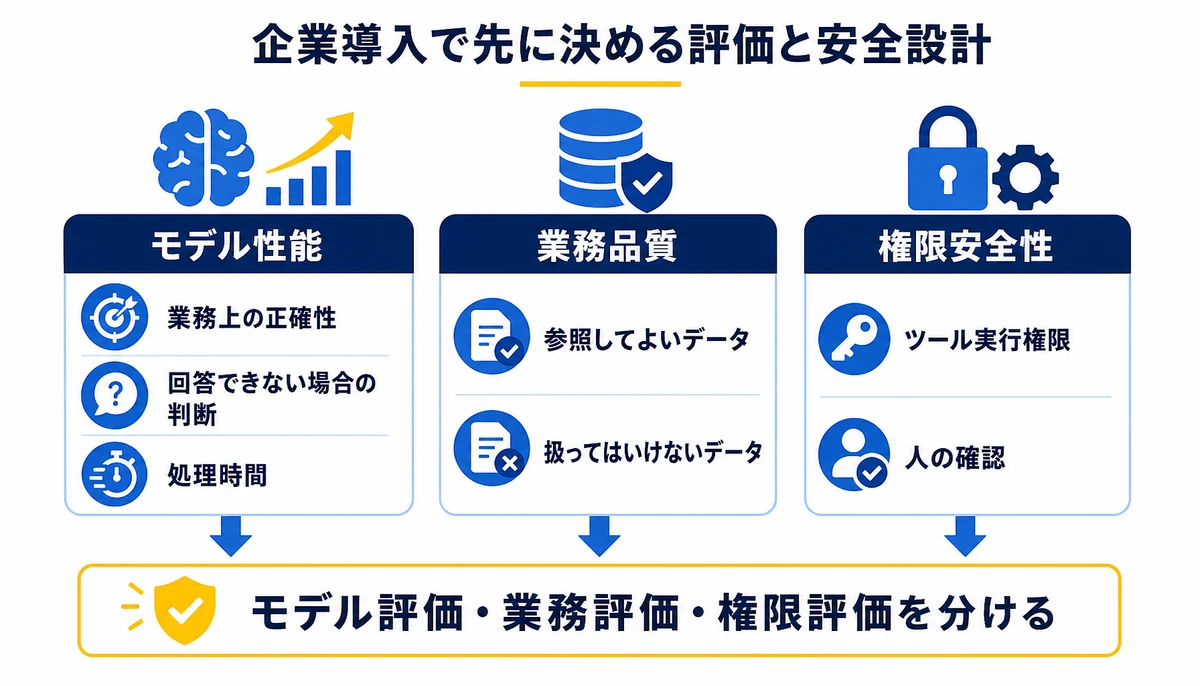
企業が検証を始めるなら、まず既存業務を1つ選ぶところからです。問い合わせ分類や社内文書検索のように、入力、期待する結果、失敗時の扱いを記録しやすい業務が候補になります。
- 正確性、回答できない場合の判断、処理時間を評価項目に分ける
- 参照してよいデータと、扱ってはいけないデータを定義する
- ツールごとに実行権限と人の確認が必要な操作を分ける
- 学習前後の結果を同じテストケースで比較する
- 本番反映の条件と、問題発生時の停止手順を決める
強化学習でスコアが上がっても、誤った処理を自動で実行する危険が消えるわけではありません。モデル評価、業務評価、権限評価を分けると、改善の効果と残るリスクを説明しやすくなるでしょう。

自社検証で詰まりやすい設計作業
自社だけで始める場合、既存エージェントの実行ログを学習に使える形へ整理する作業で止まりやすくなります。評価指標が「回答が良いか」に留まると、ツール選択や権限利用の失敗を見落とすことも。
本番反映の判断では、モデルの変更と業務フローの変更を切り分ける必要があります。外部の支援を使う場合は、現状の診断から評価項目、要件、運用引き継ぎまでを一続きで整理できるかを確認してください。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく、要件を整理した詳細な見積を示し、契約後に要件が動いても決めた範囲で優先順位を入れ替えて進める体制です。
企画、課題整理、要件整理から開発までを同じ担当が受け持ちます。本番展開後は、運用の引き継ぎや内製化、担当者向けの研修まで支援します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Agent Lightning v1.0は何を変えるフレームワークですか?
既存のコードやツール、実行環境を大きく変更せず、AIエージェントを強化学習の改善サイクルへ接続するフレームワークです。既存環境をそのまま使える範囲は、個別の構成で確認する必要があります。
SWE-bench Verifiedの56.4%は業務精度を示しますか?
SWE-bench Verifiedはコード修正能力を測るベンチマークです。Qwen3.5-9Bの検証では56.4%が報告されましたが、社内業務の正確性や安全性を直接示す数値ではありません。
vLLMやKubernetesを使っていない企業でも検討できますか?
Agent Lightning v1.0は、verl、vLLM、Kubernetesに対応しています。現在の環境で利用できるかは、モデル提供方法、実行基盤、既存エージェントの構成を確認して判断してください。
最初の検証では何を測ればよいですか?
正確性だけでなく、回答不能時の判断、処理時間、ツール選択、権限利用、確認依頼の有無を分けて測ります。学習前後を同じテストケースで比較すると、変更の影響を追いやすくなります。
強化学習で改善すれば本番へすぐ投入できますか?
すぐに投入できるとは限りません。人の確認が必要な操作、扱えるデータ、停止条件、変更履歴を決めたうえで、限定した業務から段階的に確認する進め方が現実的です。
あわせて読みたい
Microsoft Agent Lightning v1.0は、AIエージェントの学習と運用を近づける選択肢です。導入を急ぐ前に、既存業務の評価指標と安全条件を定め、小さな範囲で改善サイクルを回せるか確かめてください。
本記事の情報は2026年8月23日時点の公開情報に基づきます。Agent Lightning v1.0の対応範囲や各社の提供条件は変更される可能性があるため、契約や導入の前に各社へ確認してください。記事内の情報だけで成果や安全性を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Anthropicがエージェント運用の制御層を強化。コスト上限とデータ居住地指定が標準機能に
Anthropicは2026年8月7日、Claude Managed Agentsにセッション予算・アドバイザーモデル・推論ジオコントロールなど4機能を追加した。コスト暴走リスクの封じ込めとGDPR・個人情報保護法への対応をインフラレベルで実現する今回のアップデートが、日本企業のAIエージェント本番移行にどう影響するかを解説します。
JiraがAIエージェントの司令塔になる。要件定義自動化とClaude Code連携の意味
アトラシアンがJiraにAI要件定義の自動作成・タスク自動割り当て・Claude CodeやGitHub Copilotとの連携機能を発表した。プロジェクト管理ツールがAIエージェントのオーケストレーション基盤へと役割を拡張するこの動きが、開発現場の実務にどう影響するかを整理します。
Claude CodeやCodexの対抗馬となるかDeepSeek Harnessリリース
DeepSeek HarnessはClaude CodeやCodexのような完成品ではなく、モデルやツール、サンドボックスを組み替えられるAIエージェント基盤です。公開情報をもとに、企業が確認すべき構成自由度と運用負担を整理します。















