
DeepSeek V4 Pro 0813がAPI提供開始 推論レベルでLLM選定はどう変わる
要約
DeepSeek V4 Pro 0813がOpenRouterでAPI提供を始めました。低・中・高の推論レベルを業務ごとに切り替える考え方と、GPTやClaude、自社運用を含めたモデル選定の進め方を解説します。
生成AIの選定では、最も高性能なモデルを全業務に使う考え方が注目されがちです。海外では、推論の強さを業務単位で切り替えるAPI運用も議論されています。
今回のニュースは、モデルの能力だけでなく、推論レベルをどう配分するかに焦点を移します。API利用と自社運用を比べる企業にも、検討材料になりそうです。
この記事の対象読者
対象は、生成AIのAPI導入を検討する担当者です。すでにGPTやClaudeを使い、処理ごとのモデル分担を見直したいチームにも関係します。
- DeepSeek APIやOpenRouterの選択肢を確認したい方
- 推論レベルと処理時間の関係を業務で試したい方
- 生成AIコスト最適化の評価軸を整理したい方
- API利用とオープンウェイトモデルの運用を比較したい方
DeepSeekは8月12日にV4 Pro 0813のAPI提供を開始
OpenRouterからのAPI提供という発表内容
DeepSeekは2026年8月12日、推論過程を扱えるDeepSeek V4 Pro 0813のAPI提供を開始しました。Simon Willison氏の記事では、提供先としてOpenRouterが紹介されています。
推論レベルは低・中・高から選択できる
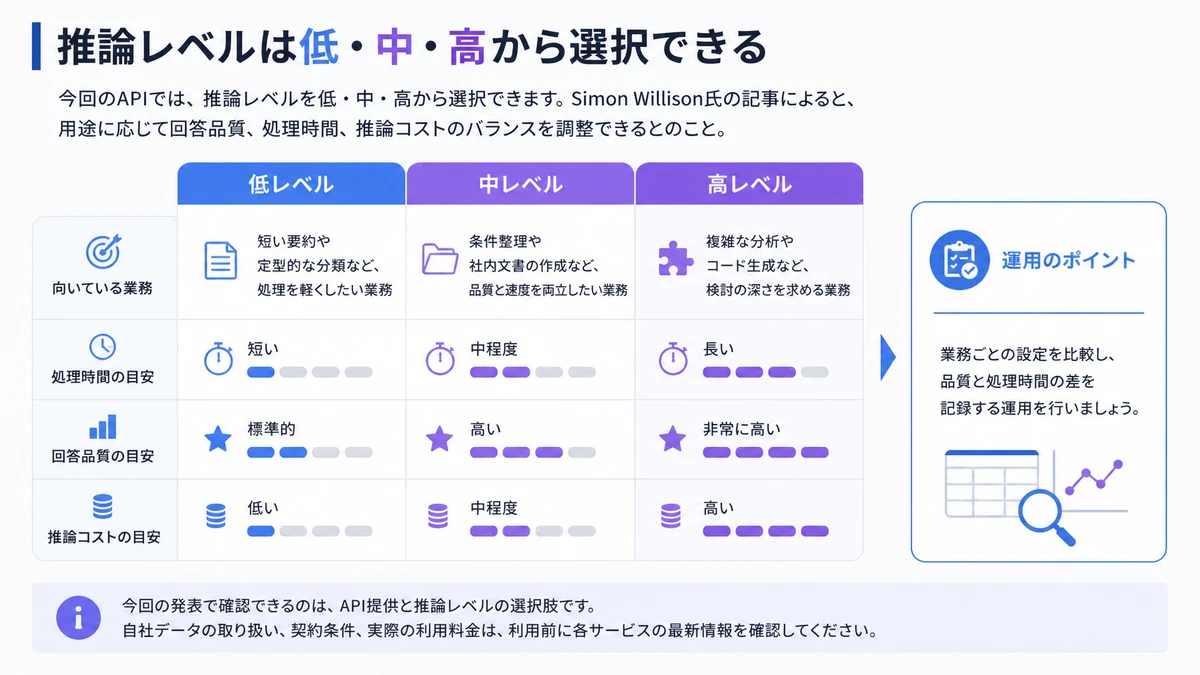
今回のAPIでは、推論レベルを低・中・高から選択できます。Simon Willison氏の記事によると、用途に応じて回答品質、処理時間、推論コストのバランスを調整できるとのこと。
- 低レベル、短い要約や定型的な分類など、処理を軽くしたい業務
- 中レベル、条件整理や社内文書の作成など、品質と速度を両立したい業務
- 高レベル、複雑な分析やコード生成など、検討の深さを求める業務
- 業務ごとの設定を比較し、品質と処理時間の差を記録する運用

推論レベルの切り替えがLLM選定を業務別に変える
モデルを選ぶ単位を業務タスクへ移す
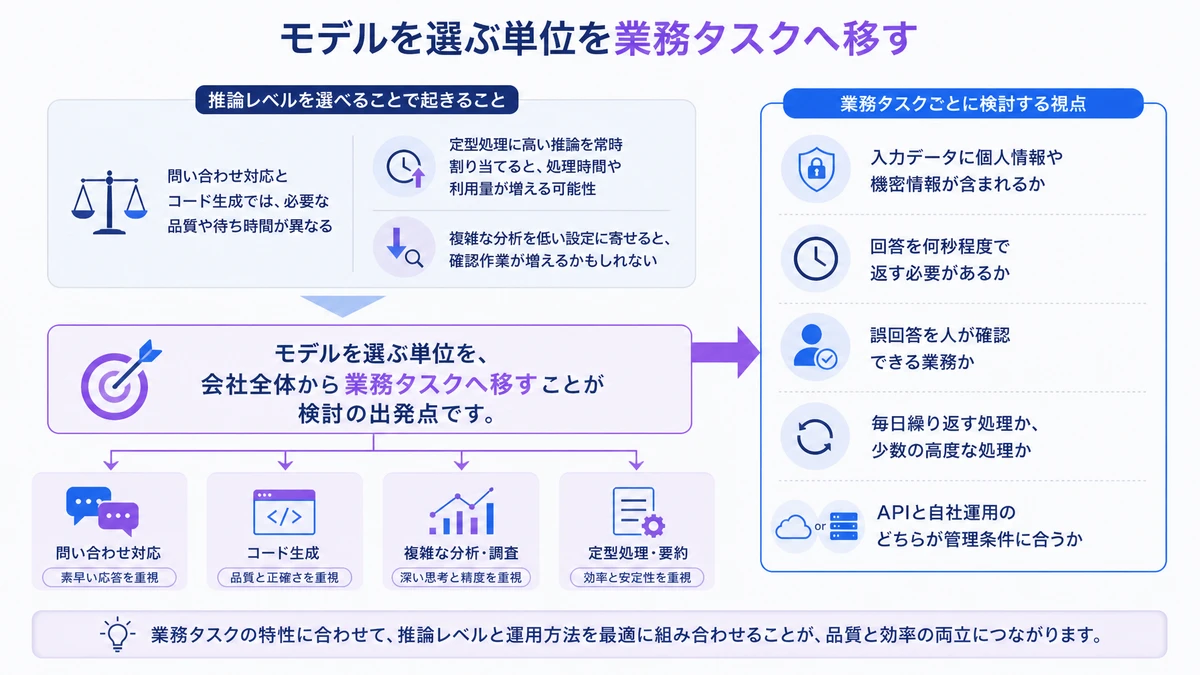
推論レベルを選べると、モデル選定を一つの順位表だけで決めにくくなります。BinxAIが見てきた範囲では、同じ会社でも、問い合わせ対応とコード生成では必要な品質や待ち時間が異なります。
定型処理に高い推論を常時割り当てると、処理時間や利用量が増える可能性があります。反対に、複雑な分析を低い設定に寄せると、確認作業が増えるかもしれません。
モデルを選ぶ単位を、会社全体から業務タスクへ移すことが検討の出発点です。
- 入力データに個人情報や機密情報が含まれるか
- 回答を何秒程度で返す必要があるか
- 誤回答を人が確認できる業務か
- 毎日繰り返す処理か、少数の高度な処理か
- APIと自社運用のどちらが管理条件に合うか
自社運用とAPIを業務ごとに分ける
海外で推論レベルの切り替えが議論される一方、現場ではモデル単体の優劣だけで決まりません。データ管理を優先する処理は自社運用、迅速な導入を優先する処理はAPIという分担も候補です。
既存システムとの互換性が大きい業務では、GPTやClaudeを残す判断もあります。オープンウェイトモデルを含め、同じ業務データで比較してから役割を決める流れが現実的でしょう。
導入前に業務タスク別の比較表を作る
同じ入力と合格条件で試す
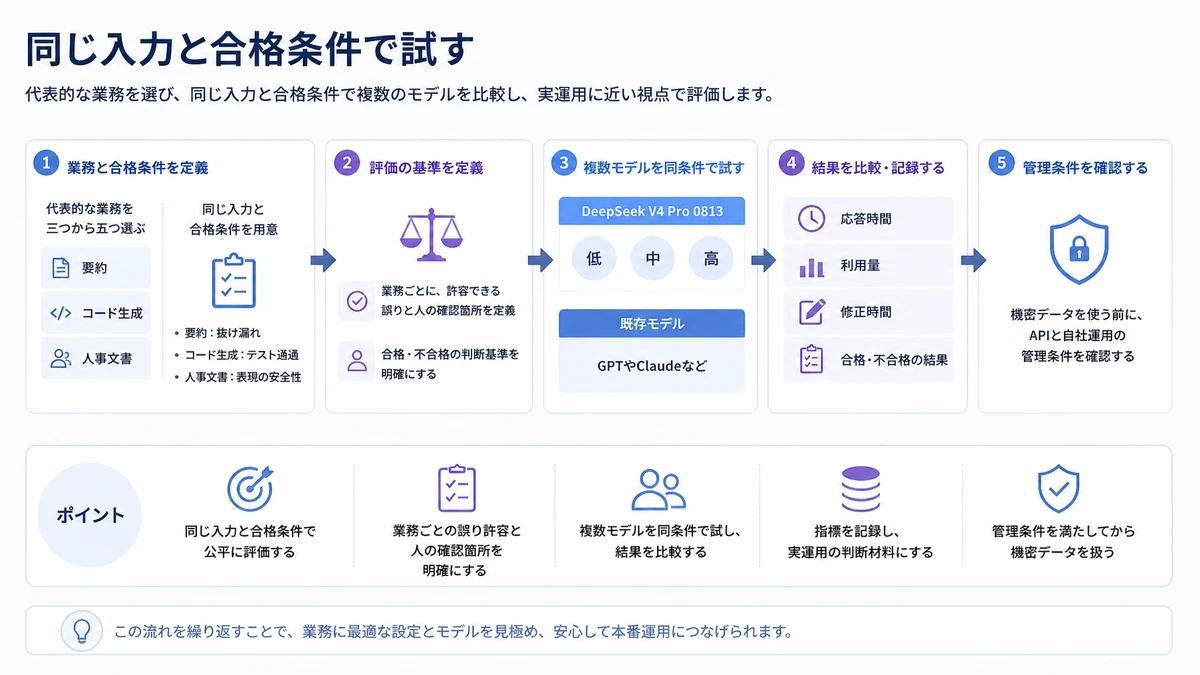
まず代表的な業務を三つから五つ選び、同じ入力と合格条件を用意します。例えば、要約なら抜け漏れ、コード生成ならテスト通過、人事文書なら表現の安全性を確認しましょう。
- 業務ごとに、許容できる誤りと人の確認箇所を定義する
- DeepSeek V4 Pro 0813の低・中・高を同じ条件で試す
- GPTやClaudeなど既存モデルとも結果を比較する
- 応答時間、利用量、修正時間を記録する
- 機密データを使う前に、APIと自社運用の管理条件を確認する
推論レベルと修正時間をセットで残す
評価結果は、モデル名だけでなく、推論レベルと人の修正時間をセットで残します。高品質でも修正に時間がかかれば、業務全体の効率は読み違えやすくなるでしょう。
小さな検証では、正答率だけでなく、1件あたりの処理時間と確認工数まで並べると判断しやすくなります。

自社検証で詰まりやすいのはデータと評価条件の整理
比較対象の業務選びでつまずく
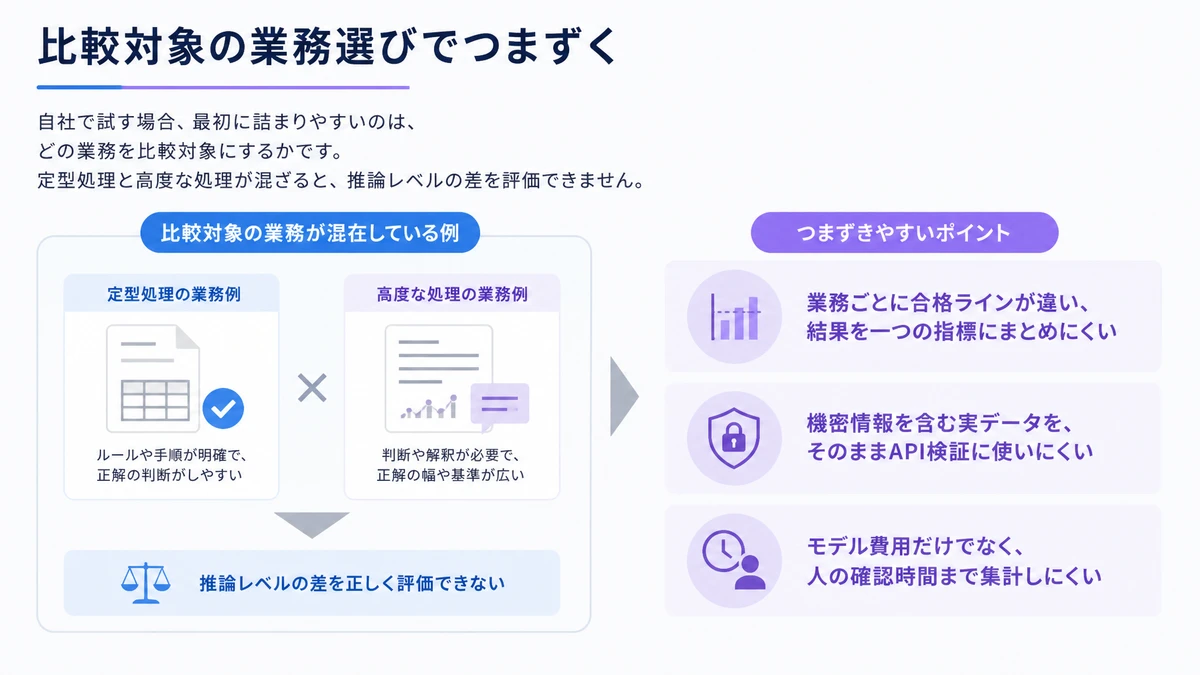
自社で試す場合、最初に詰まりやすいのは、どの業務を比較対象にするかです。定型処理と高度な処理が混ざると、推論レベルの差を評価できません。
- 業務ごとに合格ラインが違い、結果を一つの指標にまとめにくい
- 機密情報を含む実データを、そのままAPI検証に使いにくい
- モデル費用だけでなく、人の確認時間まで集計しにくい
みっちゃくんで検証範囲を切り分ける
外部の支援を使うと、業務タスクの棚卸しから評価条件の設計までを切り分けやすくなります。自社で判断する部分と、専門家に任せる部分も整理しやすくなるでしょう。
みっちゃくんは月額5万円からで、初期費用と追加費用はありません。API、サーバー、ツールの費用は実費で、データ基盤構築・改善、業務アプリ開発、AI研修などを提供しています。
AI推進や社内規約策定、AIアドバイザー、月次レポート、セキュリティ対応、社内での横展開にも対応可能。

よくある質問
DeepSeek V4 Pro 0813を検討するときは、APIの機能と自社の運用条件を分けて考えましょう。次の質問から、検証前に確認する項目を整理できます。
DeepSeek V4 Pro 0813はどこでAPI利用できますか?
2026年8月12日時点では、Simon Willison氏の記事でOpenRouterからのAPI提供が紹介されています。利用条件や提供状況は、契約前に最新情報を確認してください。
推論レベルはどのように使い分けますか?
低・中・高を、定型処理、判断を含む処理、複雑な分析の順に仮置きします。その後、品質、処理時間、人の修正時間を実データに近い条件で比べます。
DeepSeekにすべての業務を移すべきですか?
一つのモデルに統一する必要はありません。データ管理、既存システムとの互換性、応答速度を業務ごとに確認し、GPTやClaude、自社運用を含めて役割を分けましょう。
API利用と自社運用は何を比べますか?
データをどこで処理するか、運用担当者を置けるか、更新や障害対応をどうするかを比べます。API料金だけでなく、環境構築と保守の負担も同じ表に入れましょう。
最初の検証では何を決めればよいですか?
対象業務を一つに絞り、入力例、合格条件、確認担当者を決めます。DeepSeek V4 Pro 0813の推論レベルを変え、既存モデルとの結果を記録してください。
参考・出典
DeepSeek V4 Pro 0813の登場で、LLMモデル選定は性能の順位付けから業務別の配分へ広がります。今日はまず、社内で扱う業務を一つ選んでください。
その業務でDeepSeek V4 Pro 0813の低・中・高を同じ入力で試し、修正時間を記録します。そこからAPI、自社運用、既存モデルの役割を決めていくと進めやすくなるでしょう。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
ホワイトカラー500人が現場へRIZAPのAI活用と人員再配置が示す次の一手
RIZAPグループが進めるAIによるバックオフィス効率化と約500人の建設職人育成を整理します。AI省人化を雇用削減で終わらせず、リスキリングと人員再配置へつなげる設計、社内で進める際の判断項目を解説します。

Sakana AIの「Fugu」とは:複数のフロンティアモデルを束ねる学習型オーケストレーションを徹底解説
Sakana AIが2026年6月に提供を開始したマルチエージェント基盤モデル「Fugu」を解説します。複数の最先端モデルを単一APIでまとめる仕組み、FuguとFugu Ultraの違い、使い方、性能主張への注意点、自社にとっての意味までを出典付きで整理します。
NEDOがフィジカルAIを国策に据えた。P26013公募が示す日本のAI基盤戦略の転換点
NEDOは2026年度、マルチモーダル基盤モデルとフィジカルAIの開発支援を正面から掲げたP26013公募を実施しました。採択先が今後の国産AI基盤の勢力図を左右する可能性があり、AI調達戦略を検討する企業が今から注視すべき理由を整理します。















