
毎秒280トークンが変えるGemini 3.5 Flash。エージェント選定の新しい軸
要約
2026年5月のGoogle I/O 2026で登場したGemini 3.5 Flashは、出力速度で他のフロンティアモデルの約4倍を記録しつつ、上位モデルを複数ベンチマークで上回った。この記事では、モデル選定の軸が「精度か速度か」から「タスク粒度ごとの使い分け」へと移行する背景と、Vertex AI・Gemini APIでエージェント設計を行うチームへの実務的な影響を整理します。
「Flashは速いけど精度を落とせないタスクには使えない」という判断が、エージェント設計の現場では長く続いてきました。
その前提が、Google I/O 2026で変わりました。Gemini 3.5 Flashは速度だけでなく、複数のベンチマークで上位モデルを超える性能を示しています。
対象はコーディング・エージェント・マルチモーダルの各領域です。
この記事の対象読者
- Vertex AIまたはGemini APIを使ってAIエージェントを設計・開発しているエンジニアやアーキテクト
- モデル選定とAPIコストのバランスに頭を悩ませているプロダクトマネージャー
- Google I/O 2026の発表を実務にどう落とし込むか整理したいAIプロジェクトのリード
Google I/O 2026で起きたこと
発表と提供開始のタイミング
Gemini 3.5 Flashは2026年5月19日のGoogle I/O 2026で発表されました。提供も同日から始まっています。
Googleの公式ブログによると、コーディング・エージェント・マルチモーダルの各ベンチマークで、上位モデルのGemini 3.1 Proを上回る性能を示しています。対象領域の広さが特徴でしょう。
出力速度は毎秒約280トークンで、他のフロンティアモデルと比較して約4倍とされています。
同時発表されたエージェントとマルチモーダル
同イベントでは、常時駆動のAIエージェントGemini Sparkも披露されました。マルチモーダル生成モデルGemini Omniも同時に登場しています。
Flashモデル単体の性能向上だけでなく、エージェントとマルチモーダルを一体として押し出すのが今回の特徴です。Googleの方向性が鮮明になったイベントといえるでしょう。
| 項目 | Gemini 3.5 Flash | 備考 |
|---|---|---|
| 発表日 | 2026年5月19日 | Google I/O 2026と同日 |
| 提供開始 | 2026年5月19日 | 即日提供 |
| 出力速度 | 毎秒約280トークン | フロンティアモデル比約4倍 |
| ベンチマーク比較対象 | Gemini 3.1 Pro | コーディング・エージェント・マルチモーダルで上回る |
| 後継モデル | Gemini 3.6 Flash | 2026年7月21日登場・エージェント向けコスト最適化 |

「速くて賢い」が成立した理由と、その先にある論点
従来のLLMが抱えていたジレンマ
従来のLLMは、推論精度を高めるほどレイテンシとトークン単価が上がる構造でした。エージェント設計では、リアルタイム応答にProクラスを使うとAPIコストが跳ね上がります。
かといってFlashに落とすと精度リスクが生まれる、というジレンマを抱えることが多かったです。
毎秒280トークンがもたらす変化
Gemini 3.5 Flashはその構図を崩す候補です。毎秒280トークンという速度は、バッチ処理や非同期ループに十分な応答性を持ちます。
人間が待つ同期型のやり取りにも対応できるでしょう。
私たちが見てきた範囲では、エージェント設計の悩みの多くは一つの二択に集約されます。「高精度モデルをすべての工程に使うとコストが合わない、でもFlashに落とすと信頼性が下がる」という二択です。
Vertex AI・Gemini APIでエージェントを設計するチームへの影響
選定の軸はタスク粒度と頻度へ
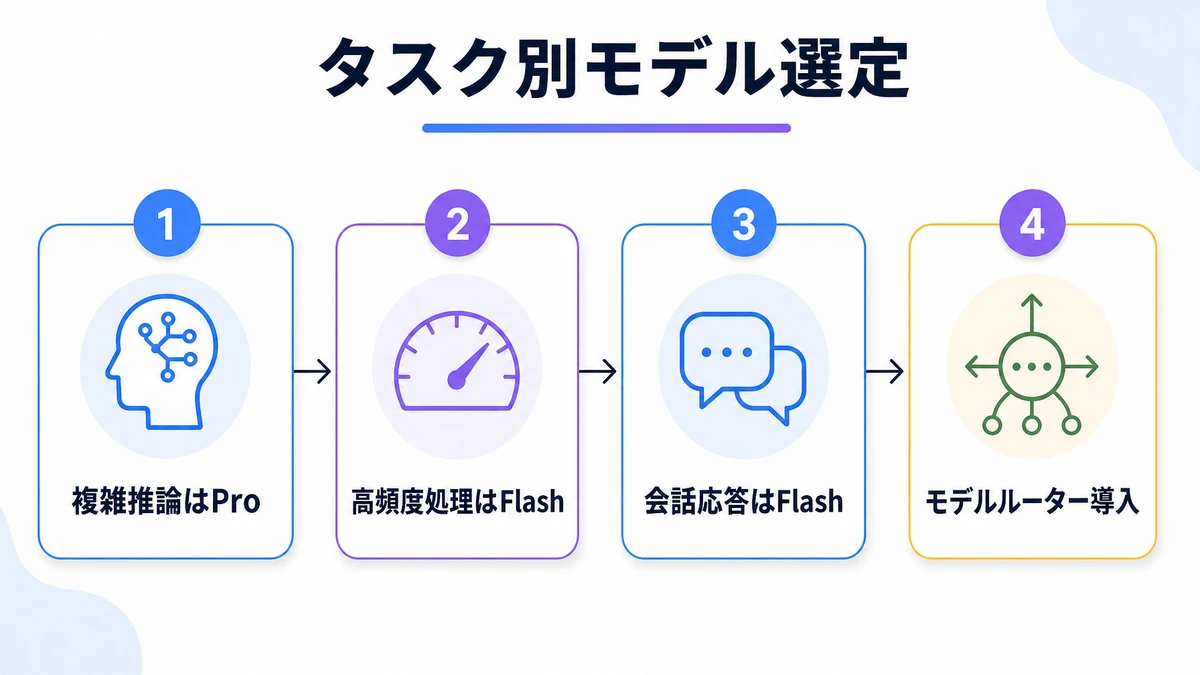
モデル選定の軸が変わります。「精度が必要だからPro」「速度が必要だからFlash」という二択ではありません。
タスクの粒度と頻度を基準にした使い分けの設計が現実的になります。
- 複雑な推論・長文の文脈整理: 引き続きProクラスを使うが、出番を絞り込む
- 高頻度のツール呼び出し・短い判断ループ: Flashで代替し、レイテンシとコストを同時に下げる
- リアルタイムの会話応答: 毎秒280トークンの速度を活かし、Flashを第一選択肢に置く
- モデルルーターの導入: Flashのリリースサイクルに対応するため、モデルバージョンを抽象化する層を設計段階で組み込む
移行コストとバージョン依存のリスク
Google WorkspaceやVertex AIをすでに使っている組織では、Gemini Flash系モデルへの移行コストは低めです。先行実験を始めやすい環境が整っています。
一方で、モデルバージョンは短期間で更新されていきます。特定のバージョンに依存した設計は、後から修正コストを生みやすいでしょう。
設計の優先順位は「今どのモデルが速いか」より「モデルが変わっても設計が壊れない構造か」に移っています。
よくある質問
Gemini 3.5 FlashはいつからVertex AIで使えますか?
2026年5月19日のGoogle I/O 2026発表と同日から提供が開始されています。Gemini APIおよびVertex AIでの利用が可能です。
既存のエージェントをGemini 3.5 Flashに切り替えるリスクはありますか?
ベンチマーク上はProを上回る領域がありますが、自社のタスクで同様の結果が出るかは個別に検証が必要です。
まずは特定の工程や呼び出し頻度の高いループから試験的に切り替え、本番への展開はそのあとというステップが現実的でしょう。
Gemini 3.6 Flashが出たなら、3.5 Flashを使う意味はありますか?
2026年7月21日に登場したGemini 3.6 Flashは、エージェント向けのコスト最適化に焦点を当てています。とはいえ3.5 Flashもまだ現役のモデルです。
どちらが自社のユースケースに合うかは、レイテンシ・コスト・タスク性能の三軸で評価するのが合理的でしょう。
Google I/O 2026で発表されたGemini Sparkとは何ですか?
Gemini Sparkは常時駆動型のAIエージェントとしてGoogle I/O 2026で披露されました。Gemini 3.5 Flashとは別のプロダクトで、バックグラウンドでタスクを継続処理するエージェント形態を指します。
詳細な仕様・提供時期については現時点でGoogleの公式発表をご確認ください。
モデルルーターとは何ですか?なぜ今必要なのですか?
モデルルーターとは、タスクの種類や負荷に応じて呼び出すモデルを動的に切り替える抽象化層のことです。Flashファミリーのリリースサイクルは短くなっています。
特定バージョンに直接依存した設計を続けると、更新のたびに手戻りが発生します。設計初期にルーター層を置いておくことで、モデルの更新を局所的な変更で吸収できるでしょう。

あわせて読みたい
あわせて読みたい
参考・出典
参考・出典
Gemini 3.5 Flashの登場は、エージェント設計における選択肢の幅を広げました。速度と精度の両立が現実になった今、問われるのはモデルの性能ではありません。
タスク粒度を整理してモデルを使い分ける設計者の判断軸です。
Gemini 3.6 Flashへの流れが示すように、Flashファミリーは今後も短いサイクルで更新され続けるでしょう。特定バージョンに依存しすぎない設計が、長く使えるエージェントを作る上での現実的な出発点になります。
FlashとProの使い分けラインが見えてくるはずです。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Claude Opus 5正式公開、Fable 5相当の性能が半額に。移行の波が来た
Anthropicが2026年8月初旬にClaude Opus 5を正式リリース。最上位モデルFable 5に近い思考・コーディング精度を持ちながら価格は半額に設定され、Amazon Bedrock・Google Cloud Vertex AI・Microsoft Foundryで即日利用可能。Opus 4.1廃止と同時に訪れたこの変化が、LLMコスト設計にどう影響するかを整理します。
Mistral Agentic Search登場 文書検索は答えを探すだけで終わらない
Mistral AIが発表したAgentic Searchは、文書を検索して終わらず、閲覧と検証を重ねて回答を組み立てます。従来のRAGとの違い、社内文書への適用領域、コストと権限管理の注意点を整理します。

デジタル庁が国産LLM7モデルを選定。18万人が使う「源内」で、選び方の材料は増えるのか
デジタル庁は2026年3月6日、政府向け生成AI基盤「源内」で試用する国産LLMとして7モデルを選定しました。tsuzumi 2・PLaMo 2.0 Prime・Llama-3.1-ELYZA-JP-70Bなど7モデルの事業者と展開スケジュールを整理し、民間企業が自社のモデル選定に何を持ち帰れるかをまとめます。















