データを外へ出さないAIエージェント運用 ローカルとクラウドの使い分け方
要約
PerplexityのPortable Computerが示したローカルAIエージェントの可能性を整理します。24GB以上のVRAM要件、クラウドとの使い分け、端末権限と機密データの管理を確認し、検証時の判断軸を解説します。
生成AIを業務へ組み込むとき、入力データを外部APIへ送れるかが最初の壁になります。クラウドモデルは導入しやすい一方、機密情報を扱う処理では社内規程や契約条件の確認が欠かせません。
この記事の対象読者
- 機密データを外部APIへ送れない企業や組織
- ローカルAIを検証したい企業や組織
- GPU搭載PCの業務利用を検討する企業や組織
- AI API費用を抑えたい企業や組織
- オンプレミスとクラウドを併用したい企業や組織
Portable Computerの発表内容
端末で動かすエージェント基盤の概要
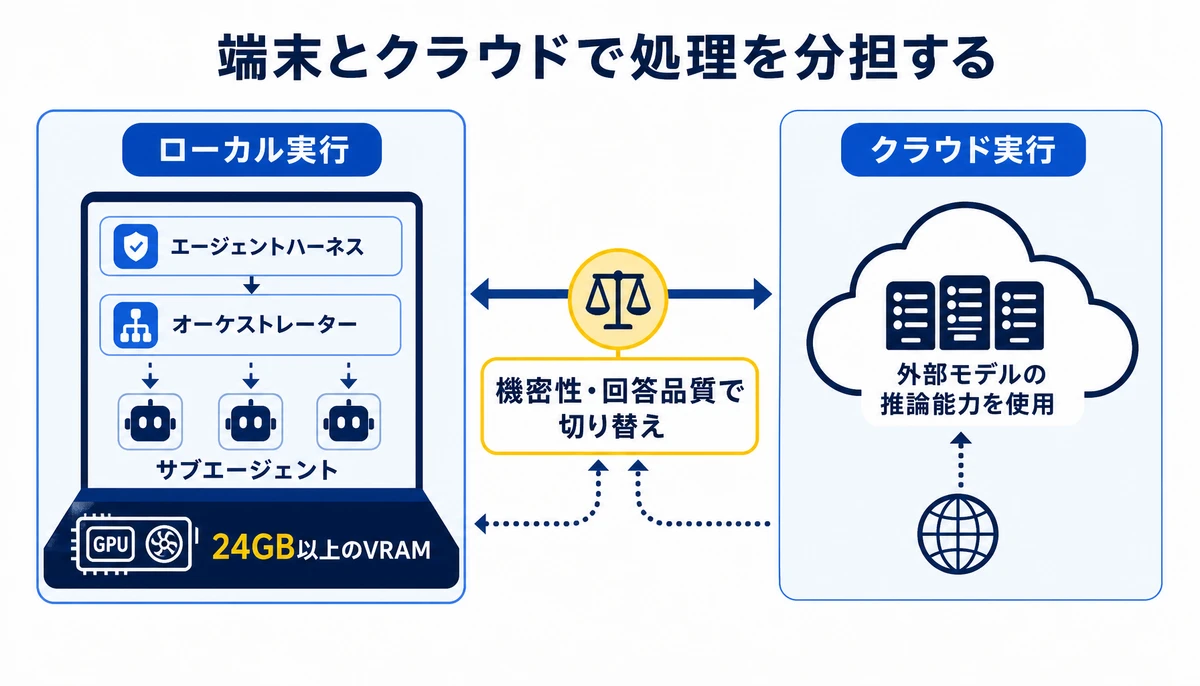
2026年9月14日、PerplexityのPortable Computerが、NVIDIA RTXを搭載したWindows PCでAIエージェントを動かす選択肢として示されました。クラウドAPIだけに処理を集めない構成が、企業向けの検討対象になっています。
案内されている構成では、エージェントハーネス、オーケストレーター、サブエージェントを端末側で実行します。エージェントハーネスは処理の実行基盤、オーケストレーターは複数処理の振り分け役です。
- ローカル実行、端末上のモデルやエージェント基盤で処理する領域
- クラウド実行、外部モデルの推論能力を使う領域
- 切り替え条件、機密性や回答品質に応じて処理先を選ぶルール
- 端末要件、24GB以上のVRAMを含むGPU環境と更新管理

ローカルとクラウドの境界
役割を分ける考え方
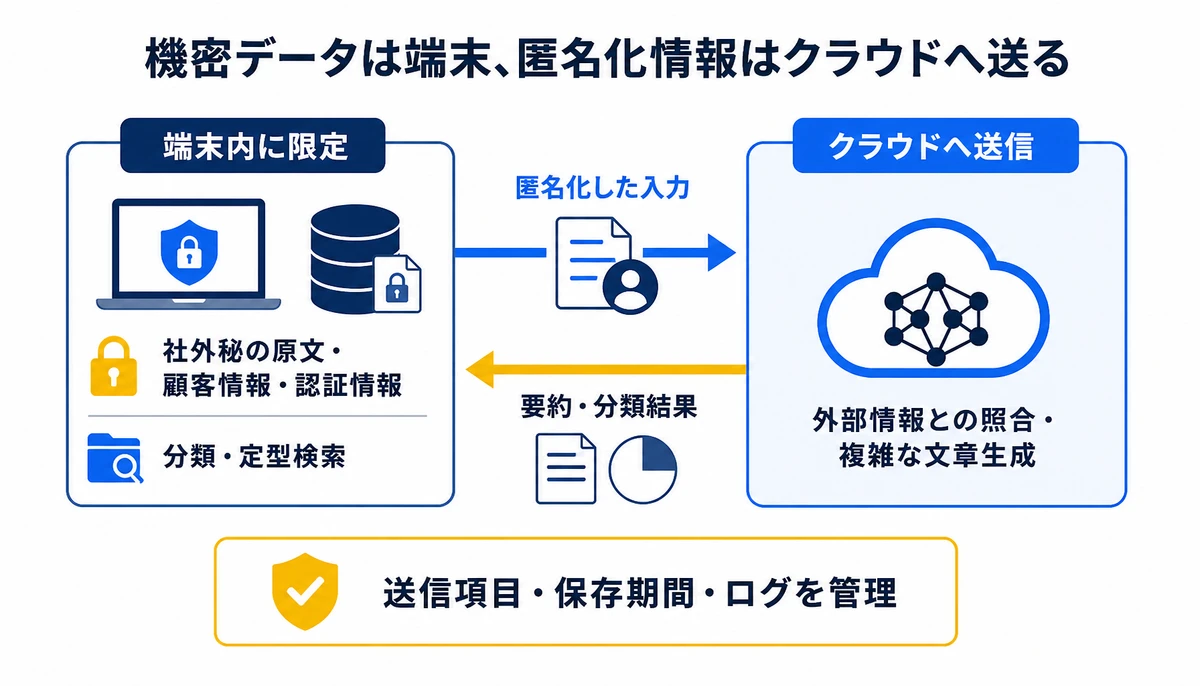
海外では、生成AIエージェントを端末へ移す動きが議論されています。BinxAIが現場で見る限り、すべての処理をローカル化するより、情報の機密性と処理負荷で役割を分ける方が検証を始めやすいかもしれません。社内文書の分類や定型的な検索は、ローカルモデルで処理する候補になるでしょう。
外部情報との照合や複雑な文章生成は、匿名化した入力だけをクラウドモデルへ渡す設計に分けられます。
- 社外秘の原文、顧客情報、認証情報は端末内に限定する
- 要約や分類の結果だけを次の処理へ渡す
- クラウド利用時は送信項目、保存期間、ログの扱いを決める
- 回答品質が不足した場合の人による確認手順を置く
この構成では、API費用を抑えられる可能性がある一方、GPU搭載PCの調達や更新管理が発生します。ローカルモデルの品質が業務基準に届かない場合は、処理をクラウドへ戻す判断も必要です。
端末権限と機密データ管理
権限設計で残しやすいリスク
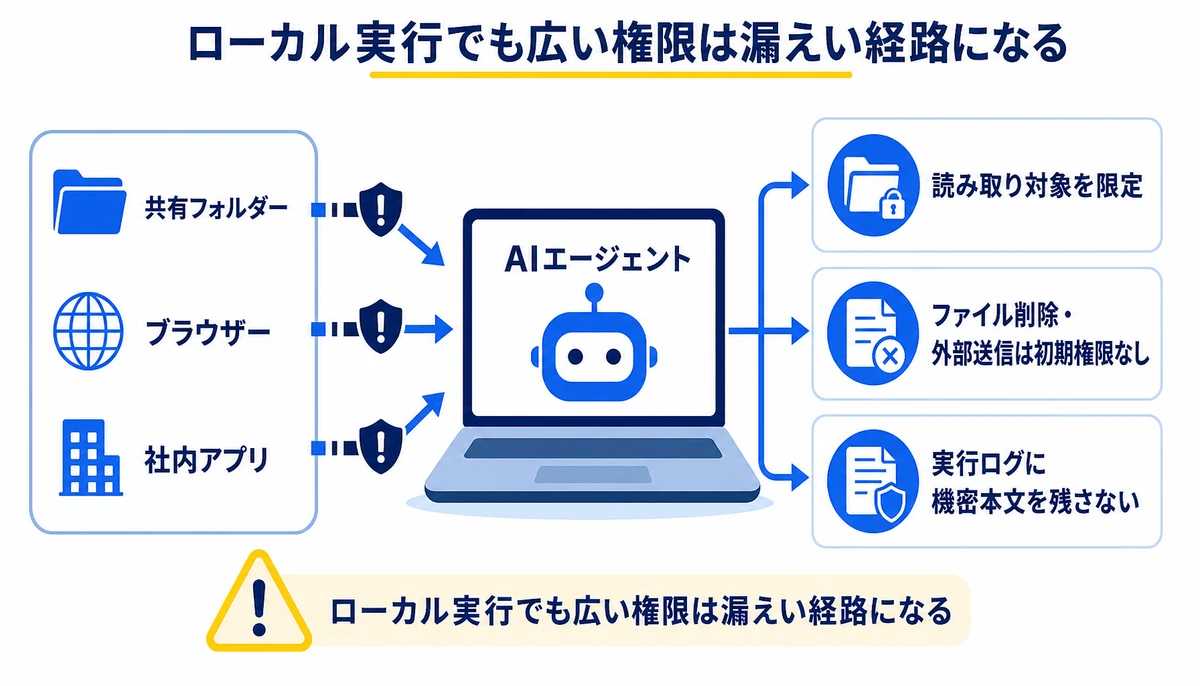
ローカルAIはデータを外へ出しにくくできますが、端末上のAIエージェントが何を読めるかは別の問題です。共有フォルダー、ブラウザー、社内アプリへの権限が広いと、情報漏えいの経路が端末内に残ります。
- エージェントごとに読み取り対象のフォルダーを分ける
- ファイル削除や外部送信などの操作権限を初期状態で与えない
- 実行ログに機密本文を残さない設定を確認する
- モデル更新時に性能、依存ソフト、権限を再点検する
検証では、通常の業務データをいきなり投入しない方法が安全です。匿名化した文書と想定質問を用意し、回答品質、処理時間、端末負荷、ログの内容を同じ条件で確認します。
自社検証で詰まりやすい箇所
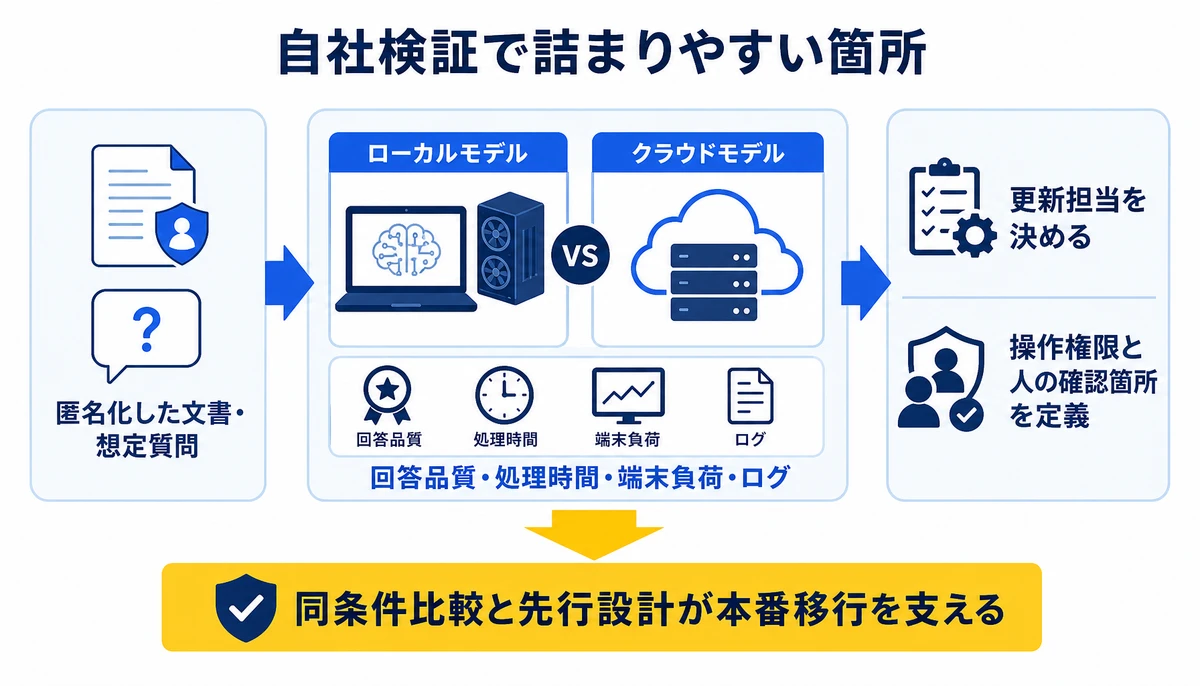
自社だけで始める場合、GPUを用意してもモデルの選定基準が決まらないことがあります。加えて、端末権限の範囲やクラウドへ切り替える条件を後回しにすると、検証結果を本番設計へ移せません。
- 業務ごとに機密度と許容できる送信範囲を整理する
- ローカルモデルとクラウドモデルの回答を同じ評価項目で比べる
- GPU、OS、ドライバー、モデル更新の担当を決める
- エージェントの操作権限と人の確認箇所を先に定義する
外部支援を活用する場合の流れ
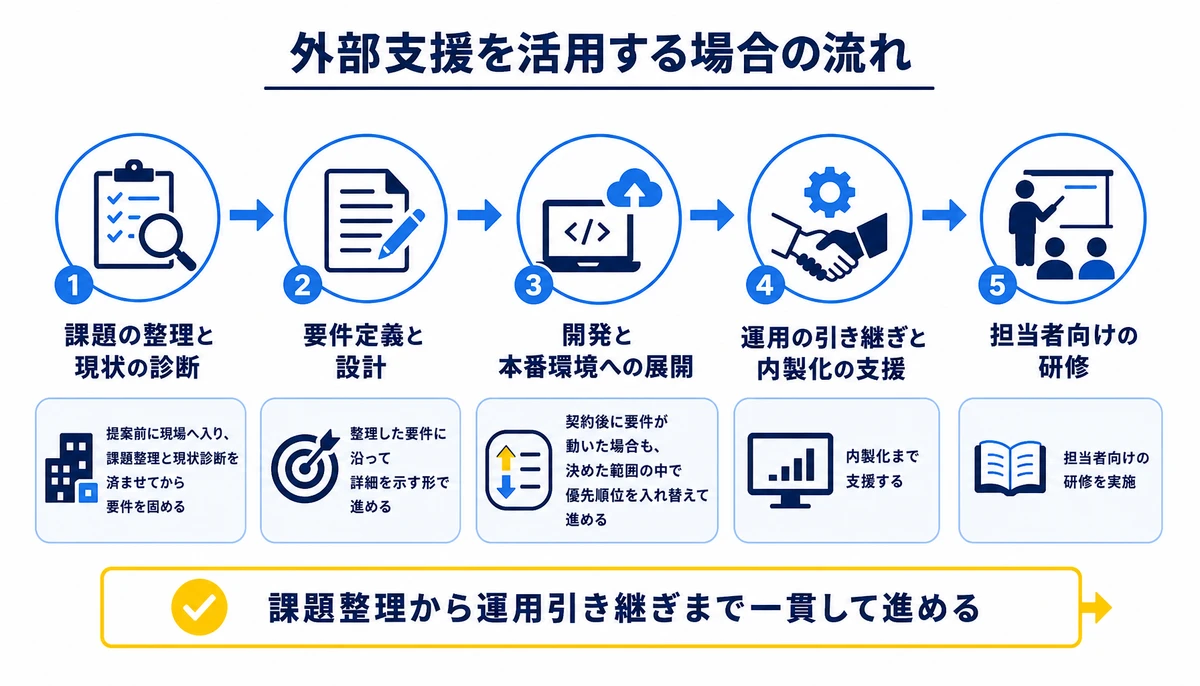
外部の支援を使う場合は、端末の購入だけでなく、課題の整理から要件、設計、運用引き継ぎまでを一つの流れで確認できます。BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。見積は一式でなく、整理した要件に沿って詳細を示す形です。
契約後に要件が動いた場合も、決めた範囲の中で優先順位を入れ替えて進め、担当者向けの研修や内製化まで支援します。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Portable Computerはすべての処理をローカルで実行しますか?
すべてをローカルに限定する構成ではありません。エージェント基盤や一部の処理を端末で動かし、必要に応じてクラウドモデルを使う構成が示されています。
24GB以上のVRAMがあれば十分ですか?
十分とは限りません。VRAM容量は利用条件の一つで、モデルの大きさ、同時実行数、処理速度、冷却性能も業務への適合性を左右するでしょう。
機密データを扱う場合に最初に決めることは何ですか?
データの種類ごとに、端末内だけで扱う情報とクラウドへ送れる情報を分けることが出発点です。認証情報や顧客情報は、送信禁止だけでなく端末内の読み取り権限も絞ります。
AI API費用は必ず下がりますか?
必ず下がるとはいえません。API利用を減らせても、GPU搭載端末の調達、更新、監視、モデル評価に別の運用負担が発生するため、業務単位で総コストを比べる必要があるでしょう。
検証はどの業務から始めるとよいですか?
機密性が高く、処理内容が定型的な業務から始めるのが現実的です。匿名化したデータで回答品質と権限設定を確認し、クラウドへ渡す必要がある処理は後から切り分ける方法が考えられます。
あわせて読みたい
PerplexityのPortable Computerは、AIエージェントを端末へ寄せる運用を検討するきっかけになります。導入時は、GPU性能だけで決めず、ローカルモデルの品質、端末権限、クラウドへ渡す条件を一つの設計として確認してください。
本記事に挙げた他社の料金や制度は、執筆時点で公開されていた情報です。お申し込みの前に、各社の最新の内容をご確認ください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事

AIエージェントの分岐判断を軽量モデルへ移す方法Jevが示す推論コスト分担の設計
TypeSafe AIが発表したJevは、文章生成ではなく分類や操作選択に特化したモデルです。AIエージェントの推論コストを見直すため、公開情報の読み方、人の確認へ戻す基準、複数モデルの分担方法を解説します。
AIエージェントの接続・予算・監視をまとめて管理する設計と評価の進め方
Nutanix Enterprise AI 2.8とAgent Gatewayの更新を起点に、MCPサーバーの接続許可、AIエージェントの権限、トークン予算、稼働ログを一体で管理する設計と、ハイブリッド環境での評価項目を整理します。
GoogleのGemini 3.8 Flashで変わるAIエージェント設計
GoogleがGemini 3.8 FlashとGemini 3.8 Flash Cyberを発表しました。提供先や用途の違いを整理し、短期的なモデル更新に耐えるAIエージェントの設計、評価、権限管理、業務単位の比較方法を解説します。