
AIファインチューニングとは何か 業務に合わせてモデルを最適化する前に確認すること
要約
ファインチューニングとは何かを、RAGやプロンプトとの違い、業務データの整え方、評価方法、導入手順、費用と期間を判断する視点まで整理します。AI導入で迷う企業が、学習を始める前に確認すべき条件も紹介します。
海外では、生成AIを業務に合わせて調整する方法として、ファインチューニングが議論されています。BinxAIが現場で見る限り、導入時に問われるのは学習を実行できるかより、どの出力を合格とするかを決められるかです。
ファインチューニングを、AIに知識を追加する技術だけで捉えると、RAGやプロンプト設計との使い分けを誤るかもしれません。本記事では、特定業務の出力を安定させる最適化手段として、導入前の判断から評価までを整理します。
この記事の対象読者
- 生成AIを社内で進めたい企業や組織
- AI導入をしたいが、どこから始めればよいか分からない方
ファインチューニングとは?
ファインチューニングとは、事前学習済みのモデルに新しいデータセットで追加学習を行い、パラメーターを調整する手法です。Sky株式会社の解説では、既存モデルを特定の用途へ適応させる方法として説明されています。
汎用モデルは幅広い質問に対応できますが、社内独自の文体や判定基準まで安定して再現するとは限りません。業務データを使って調整すると、特定のタスクやドメインに合わせた出力を目指せます。
ただし、ファインチューニングは最新情報を自動的に保持する仕組みではありません。学習させる内容と、運用中に参照する情報は分けて設計する必要があるでしょう。
似た方法との違い
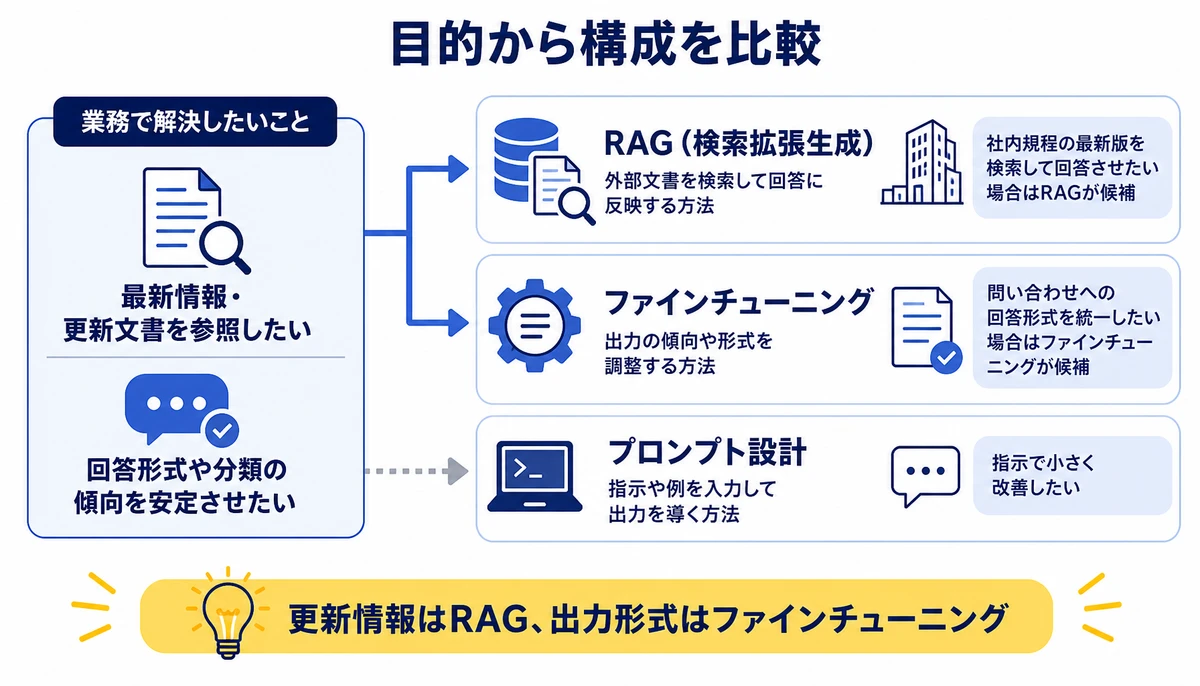
| 方法 | 主な役割 | 向いている場面 | 確認する点 |
|---|---|---|---|
| ファインチューニング | 出力の傾向や形式を調整する | 定型的な分類や回答形式を安定させたい場面 | 教師データと合格基準を用意できるか |
| RAG(検索拡張生成) | 外部文書を検索して回答に反映する | 社内規程や商品情報など、更新される情報を扱う場面 | 検索結果の正確さと参照範囲を管理できるか |
| プロンプト設計 | 指示や例を入力して出力を導く | 小さく試しながら指示を改善したい場面 | 指示だけで出力の揺れを抑えられるか |
| ゼロからの学習 | モデル自体を新たに学習する | 大規模な研究や独自モデルが必要な場面 | データ、計算資源、専門体制を確保できるか |
既存モデルをベースにするため、ファインチューニングはゼロから学習する場合よりトレーニング時間を短縮できる可能性があります。FastLabelの解説でも、その点は利点として挙げられている部分です。
一方で、社内文書を検索すれば済む課題に追加学習を選ぶと、データ更新のたびに設計を見直すことになりかねません。先に業務上の変化が少ない部分と、更新され続ける部分を切り分けます。

導入判断に必要な評価基準
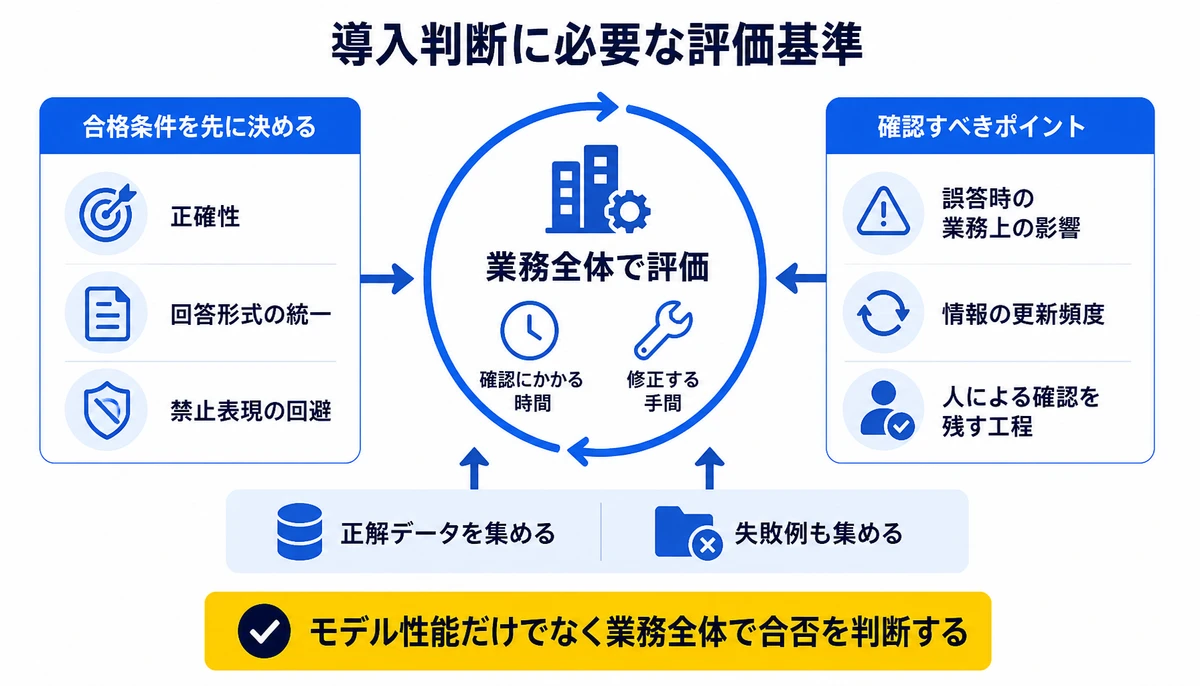
ファインチューニングを検討する企業では、モデルの性能より先に業務の合格条件を決めます。たとえば、分類結果の正しさ、回答形式の統一、禁止表現の回避などです。
- AIが出す結果を誰が利用するか
- 正解とみなす出力の条件は何か
- 誤答が起きたときの業務上の影響は何か
- 情報の更新頻度はどの程度か
- 人による確認をどの工程に残すか
海外でモデルの専門化が議論される一方、私たちが見てきた範囲では、現場の検証では出力の安定性と誤答時の扱いが焦点になりやすい傾向があります。導入前に、正解データだけでなく失敗例も集めてください。
評価対象は、モデル単体の回答ではなく業務の一連の流れです。回答を確認する時間や、誤りを修正する手間まで含めると、導入後の判断が変わることもあるでしょう。
ファインチューニングの進め方
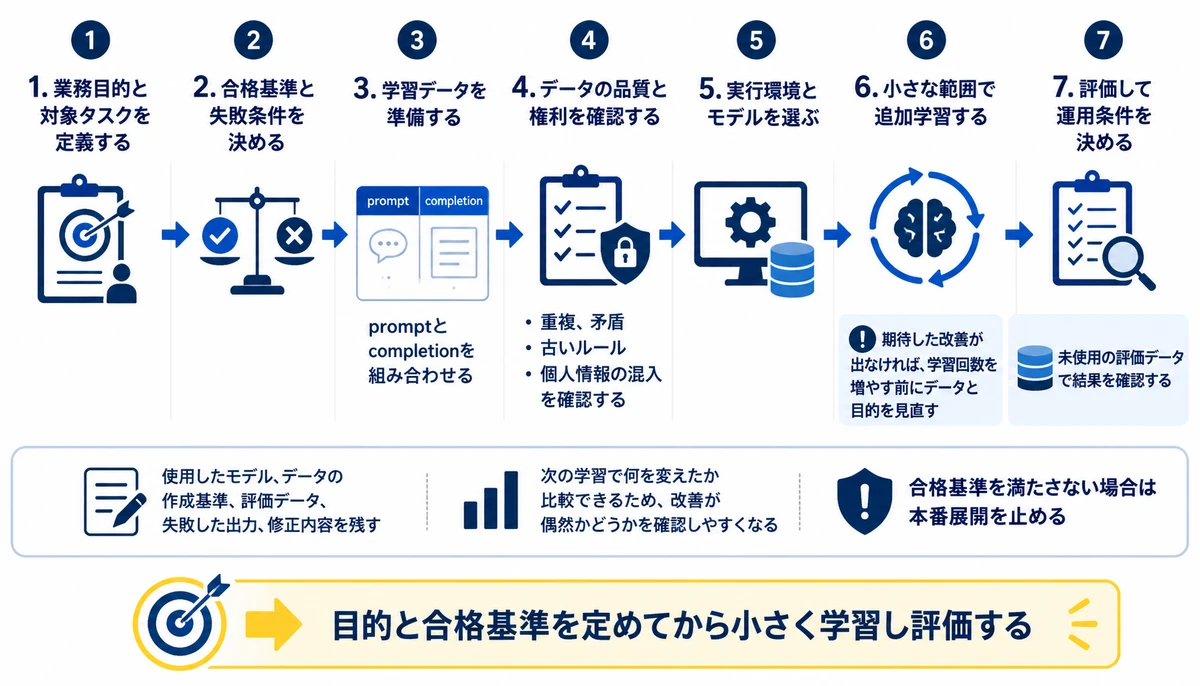
Japan AI株式会社の解説では、目的の定義、学習データの準備、実行環境の構築、追加学習、評価という流れで整理されています。実務では、各段階で次へ進む条件を決めると手戻りを抑えやすい傾向があります。
- 1. 業務目的と対象タスクを定義する 回答生成、分類、要約など、対象を1つに絞ります。業務で困っている場面と、改善後に期待する出力を文章にします。
- 2. 合格基準と失敗条件を決める 正確性だけでなく、形式、禁止事項、確認者の負担も評価項目にします。代表的な成功例と失敗例を並べておくと、比較しやすくなります。
- 3. 学習データを準備する 入力にあたるpromptと、期待する出力にあたるcompletionを組み合わせます。Qiitaの解説でも、この形式でデータを作成する方法が紹介されています。
- 4. データの品質と権利を確認する 重複、矛盾、古いルール、個人情報の混入を確認します。誰が作成し、誰が承認したデータかも記録します。
- 5. 実行環境とモデルを選ぶ 利用するモデル、学習方法、アクセス権限、ログの扱いを決めます。RAGやプロンプト設計で解決できる範囲も、同じ条件で比較します。
- 6. 小さな範囲で追加学習する 代表的な業務データを使い、出力の変化を確認します。期待した改善が出なければ、学習回数を増やす前にデータと目的を見直します。
- 7. 評価して運用条件を決める 未使用の評価データで結果を確認し、人による確認、再学習の条件、更新時の責任者を決めます。合格基準を満たさない場合は本番展開を止めます。
学習データは多ければよいとは限りません。入力と期待出力の対応が曖昧なまま件数だけ増やすと、業務で避けたい回答まで学習するリスクがあります。
ファインチューニングの費用は、利用するモデル、データ量、学習回数、評価や運用の範囲で変わります。一律の金額だけで比較すると、データ整理や本番運用の作業が見積もりから漏れがちです。
費用と期間の見積もり方
| 工程 | 費用を左右する要素 | 期間を見る観点 | 成果物 |
|---|---|---|---|
| 目的整理 | 対象業務の範囲と関係者の数 | 合格基準を決められるか | 対象タスクと評価項目 |
| データ準備 | データ量、形式、匿名化、確認作業 | 入力と期待出力を揃えられるか | 学習用データと評価用データ |
| 環境構築 | モデル、計算資源、権限、ログ管理 | 利用環境の準備に必要な確認数 | 実行環境とアクセス設計 |
| 追加学習 | 学習回数、条件変更、再実行の回数 | 結果を比較できる単位で進めるか | 調整済みモデル |
| 評価と運用 | 評価者、監視、更新、引き継ぎの範囲 | 本番条件を確認できるか | 評価記録と運用手順 |
期間を考えるときは、学習処理の時間だけでなく、データの確認と評価の時間を分けて見ます。既存モデルを使う場合でも、業務データの整理が長引けば、全体の開始から運用までの期間は伸びるでしょう。
見積もりでは、追加学習を何回行うかだけでなく、失敗時にどこまで戻るかを確認します。データ修正、評価基準の変更、RAGとの比較を含めるかで、必要な作業範囲が変わるでしょう。

自社で進める際の判断材料
自社で進める場合、まず業務データの持ち主を決めます。入力と期待出力の品質を確認する人がいないと、学習処理は進んでも評価が止まりやすくなるでしょう。
- 業務ごとの正解例と失敗例を集める担当が決まっていない
- RAG、プロンプト設計、追加学習の比較条件が揃っていない
- 本番利用後の評価、更新、誤答対応の責任者が決まっていない
外部の支援を使うと、目的整理から評価までを別々に進めず、要件と検証結果をつなげて確認しやすくなります。作業を任せる範囲と、社内に残す判断を分けておくと、運用開始後の引き継ぎも設計しやすいでしょう。
BinxAIのみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。ファインチューニングを前提にせず、業務の目的に合わせて必要な構成を整理します。
見積もりは一式いくらではなく、要件を整理したうえで詳細を示します。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められる形です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
ファインチューニングとは簡単に何ですか?
学習済みのAIモデルに業務用のデータを追加し、特定のタスクで望ましい出力が安定するよう調整する方法です。知識を保管するだけでなく、出力の形式や傾向を整える点に特徴があります。
RAGとファインチューニングはどちらを選びますか?
最新の社内文書を検索して回答させるなら、RAGを候補にします。回答の形式や分類の傾向を整えたいなら、ファインチューニングを候補に置き、同じ評価基準で比較してください。
どのようなデータを準備しますか?
入力と期待する出力が対応したデータを準備します。入力にあたるpromptと、期待する出力にあたるcompletionの組み合わせが基本形です。個人情報や古いルールの混入も確認が必要です。
学習前に何を評価すればよいですか?
正確性だけでなく、出力形式、禁止表現、確認にかかる時間を決めます。成功例と失敗例を用意し、学習前後で同じ条件から比べると改善を確認しやすくなるでしょう。
費用と期間はどのように見積もりますか?
モデルやデータ量だけでなく、データ整理、学習の再実行、評価、運用設計まで工程別に見積もります。案件ごとに範囲が変わるため、単一の相場だけで判断しない方法が現実的です。
参考・出典
ファインチューニングは、社内データを投入すれば終わる施策ではありません。業務の目的と合格基準を決め、RAGなどと比較し、データを整えてから小さく検証します。出力の変化を業務の手間と合わせて評価できれば、自社に合う導入範囲を判断しやすくなるでしょう。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
ベクトル検索をゼロから理解する 定義・導入手順・費用の分解まで
ベクトル検索とは何かを、キーワード検索やRAGとの違いから整理します。社内文書や商品情報への導入手順、評価方法、費用を左右する項目、外部支援に任せる範囲まで具体的に解説します。
社内規約をゼロから理解する 定義と作る順番と工程ごとの費用の見方
社内規約とは何か、規程や規定、就業規則とどう違うのかを整理します。AI導入にも使える整備の手順、優先順位の付け方、費用を見積もる際の考え方まで解説します。
AIエージェントとは 業務を任せる前に決めたい人の確認点
AIエージェントとは何かを生成AIやRPAとの違いから整理し、企業で導入する前に決めたい業務範囲、権限、人の確認点、失敗時の戻し方、費用の見方まで具体的に解説します。















