
ベクトル検索をゼロから理解する 定義・導入手順・費用の分解まで
要約
ベクトル検索とは何かを、キーワード検索やRAGとの違いから整理します。社内文書や商品情報への導入手順、評価方法、費用を左右する項目、外部支援に任せる範囲まで具体的に解説します。
「社内文書を生成AIに読ませたいのに、必要な資料をうまく見つけられない」という場面で、ベクトル検索が候補になります。検索語と文書の表記が一致しなくても、意味の近さを手がかりに情報を探せるためです。
海外の主要なクラウドや検索基盤では、ベクトル検索がRAG(検索拡張生成)、レコメンデーション、セマンティック検索、AIエージェントの土台として議論されています。BinxAIが現場で見る限り、導入の成否は検索エンジンの選択だけでなく、データの分け方と評価の決め方に左右されることが多いです。
この記事では、ベクトル検索の定義から、似た技術との違い、導入手順、費用の分解までをつなげて整理します。これから調べ始める方は、読み終えた時点で小さな検証に必要な材料を並べられる状態を目指してください。
この記事の対象読者
- 生成AIを社内で進めたい企業や組織
- AI導入をしたいが、どこから始めればよいか分からない方
- ベクトル検索を自社サービスや社内システムに組み込みたい企業
- ベクトル検索の導入を外部に依頼したいが、何を任せればよいか分からない企業
- ベクトル検索の小規模検証は終わったが、本番運用への移行で行き詰まっている企業
ベクトル検索の定義と仕組み
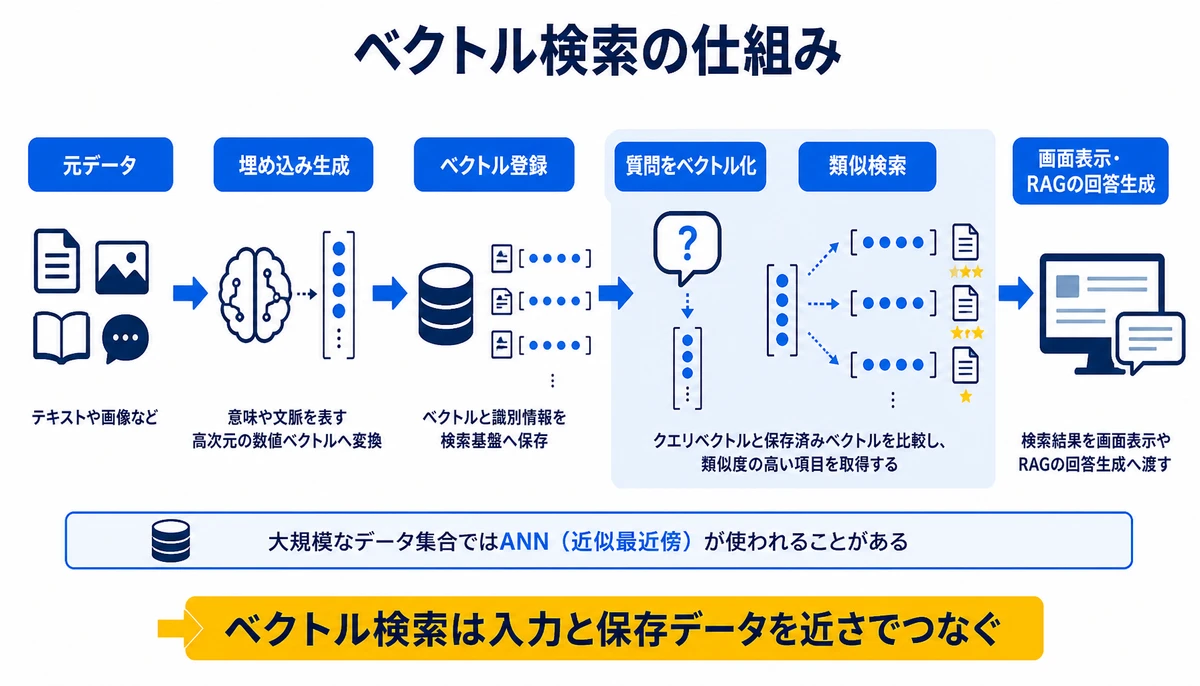
Elasticの説明では、ベクトル検索はテキストや画像などを、意味や文脈を表す高次元の数値ベクトル、つまり埋め込みに変換して検索する手法です。文章をそのまま比較するのではなく、内容の特徴を数値の並びとして扱います。
検索時は、利用者の質問や入力もベクトルに変換します。AWSの説明にあるように、そのクエリベクトルと保存済みのベクトルを比較し、類似度の高い項目を取得する流れです。
- 元データ、社内規程、商品説明、問い合わせ履歴などを用意する
- 埋め込み生成、文章や画像を数値ベクトルへ変換する
- ベクトル登録、ベクトルと元データの識別情報を検索基盤へ保存する
- 類似検索、質問をベクトル化し、近いデータを取得する
- 後続処理、検索結果を画面表示やRAGの回答生成へ渡す
大規模なデータ集合では、すべてのベクトルを一つずつ厳密に比較する代わりに、ANN(近似最近傍)アルゴリズムが使われることがあります。Elasticによれば、ANNによって大規模な集合から類似データを高速に探せるとのことです。なお、この仕組みはキーワード検索とは根本的に異なるものでしょう。

キーワード検索やRAGとの違い
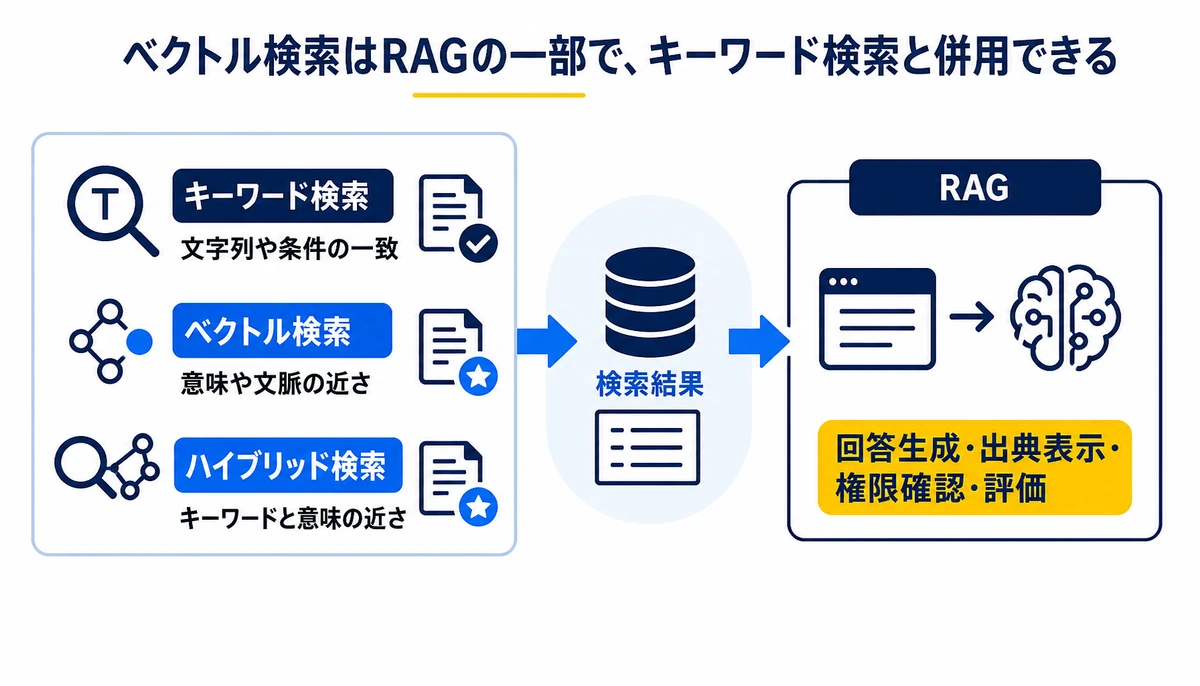
従来のキーワード検索は、入力された文字列との一致を中心に候補を探す仕組みです。一方、ベクトル検索は意味的な近さを使うため、質問と文書で言葉が異なっていても候補になる可能性があります。
| 用語 | 主な検索単位 | 向いている場面 | 注意点 |
|---|---|---|---|
| キーワード検索 | 文字列や条件の一致 | 型番、固有名詞、規程番号を探す場面 | 表記ゆれや言い換えを拾いにくい場合がある |
| ベクトル検索 | 意味や文脈の近さ | 質問に近い文書や商品候補を探す場面 | 埋め込みモデルやデータ分割の影響を受ける |
| ハイブリッド検索 | キーワードと意味の近さ | 型番と自然文の両方を扱う検索 | 両方の結果をどう統合するか設計が必要 |
| RAG | 検索結果を生成AIへ提供 | 社内資料を根拠に回答を作る場面 | 検索、プロンプト、回答評価を分けて確認する |
ベクトル検索は、キーワード検索を常に置き換えるものではありません。SEIの解説でも、キーワード検索と組み合わせるハイブリッド検索が選択肢として示されています。型番や製品コードを正確に探しながら、自然な質問にも対応したい場合に検討しやすい構成です。
RAGは検索手法そのものではなく、検索した情報を生成AIの回答材料に使う構成です。ベクトル検索はRAGの一部になり得ますが、RAG全体には回答生成、出典表示、権限確認、評価も含まれます。
ベクトル検索が使われる領域
Googleの資料では、ベクトル検索はセマンティック検索、レコメンデーション、RAG、AIエージェントなどの基盤として扱われています。検索結果を人へ見せるだけでなく、次の処理へ情報を渡す部品として位置づけられている点が特徴です。
- 社内ナレッジ検索、質問文に近い規程、手順書、議事録を探す
- 問い合わせ対応、過去の対応履歴やFAQから類似案件を探す
- 商品・コンテンツ推薦、閲覧内容や説明文に近い候補を出す
- RAG、検索した社内資料を生成AIの回答材料にする
- AIエージェント、業務の途中で必要な資料や履歴を取得する
たとえば「退職時の端末返却」を検索した利用者に、文書内の表現が「離職者のIT資産回収」でも候補として提示できる可能性があります。ただし、候補に出たことと、業務上正しいことは別です。権限や文書の最新版も確認してください。
Google Cloudのベクトル検索では、ScaNNアルゴリズムを活用して検索、レコメンデーション、生成AIアプリケーションを構築できると説明されています。海外での位置づけを踏まえると、単独の検索画面ではなく、既存の業務システムへ組み込む前提で考えると整理しやすいでしょう。
導入を進める7つの手順
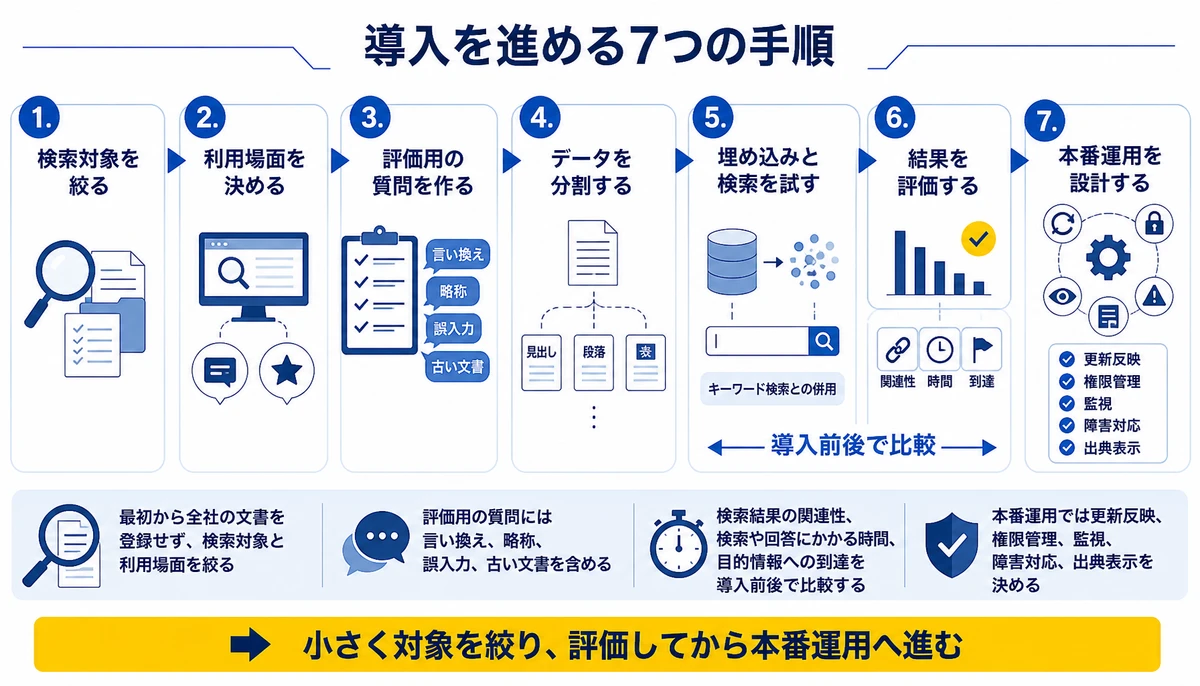
最初から全社の文書を登録するより、検索したい対象と利用場面を絞る方が検証しやすくなります。BinxAIでは、検索結果の良し悪しを確認できる質問を先に用意し、技術選定を後ろに置く進め方を現実的だと考えています。
- 1. 検索対象を絞る、規程、商品情報、問い合わせ履歴などから対象を1領域に決めます。機密情報や更新頻度も確認します。
- 2. 利用場面を決める、検索画面で人が読むのか、RAGの回答材料にするのか、推薦に使うのかを整理します。
- 3. 評価用の質問を作る、実際の質問や検索語を集め、期待する文書と避けたい文書を記録します。
- 4. データを分割する、見出し、段落、表などの構造を確認し、検索結果として意味が通る単位に分けます。
- 5. 埋め込みと検索を試す、埋め込みモデルを選び、少量のデータでベクトル検索を実行します。キーワード検索との併用も比較します。
- 6. 結果を評価する、期待した文書が上位に出るか、古い文書や権限外の文書が混ざらないかを確認します。
- 7. 本番運用を設計する、更新反映、権限管理、監視、障害時の対応、検索結果の出典表示を決めてから組み込みます。
評価では「検索できたか」だけで終わらせないでください。検索結果の関連性、検索や回答にかかる時間、利用者が目的の情報へ到達できたかを、導入前後で同じ質問を使って比べると判断材料になります。
データ分割は、検索精度に影響しやすい工程です。1つの文書を大きくまとめすぎると必要な箇所が埋もれます。細かく分けすぎると前後関係が欠けるため、見出しや手順のまとまりを確認しながら調整します。
社内文書をRAGへ利用する場合は、検索結果の出典表示とアクセス権限を後回しにしないでください。検索結果が正しくても、閲覧権限のない情報を回答へ渡せば運用上の問題になります。

費用を左右する工程と見積もり
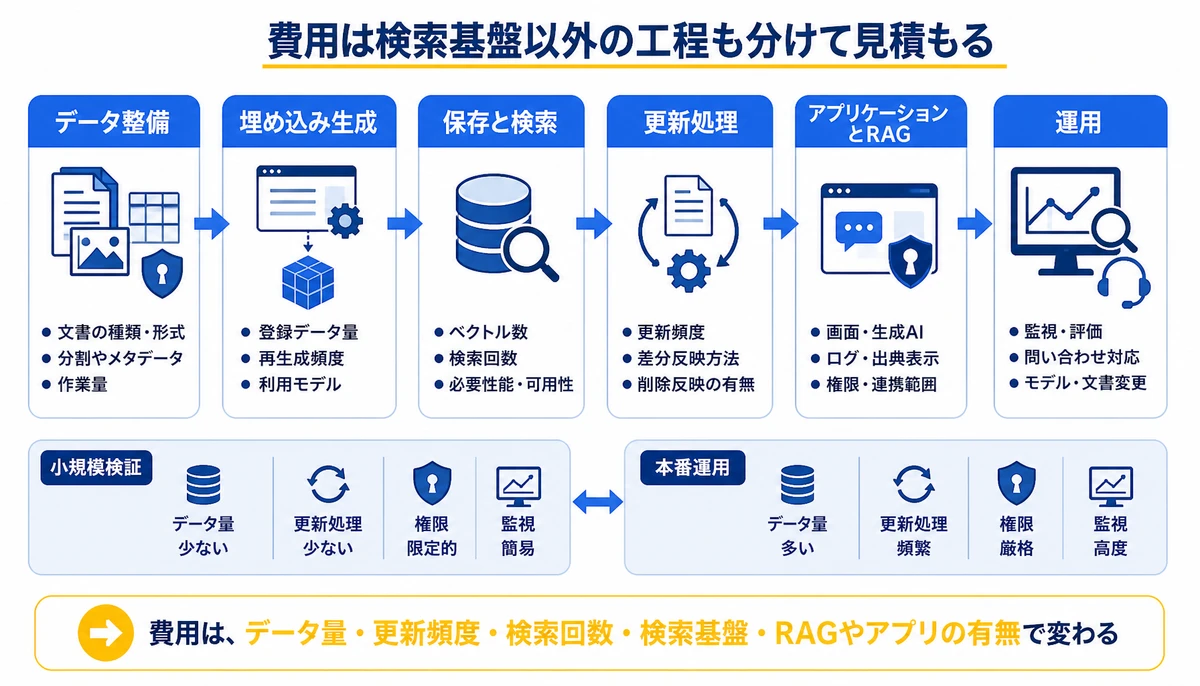
ベクトル検索の費用に、一律の金額を置くことはできません。公開料金のない構成もあるため、対象データ量、更新頻度、検索回数、利用する検索基盤、RAGやアプリケーションの有無に分けて見積もります。
| 工程 | 費用が動く要因 | 見積もりで確認する項目 | 省けない確認 |
|---|---|---|---|
| データ整備 | 文書の種類、形式、分割やメタデータの作業量 | 対象ファイル数、表や画像の扱い、権限情報 | 最新版と重複データの扱い |
| 埋め込み生成 | 登録するデータ量、再生成の頻度、利用モデル | 初回登録量、更新時の再処理範囲 | 検索対象とモデルの相性 |
| 保存と検索 | ベクトル数、検索回数、必要な性能、可用性 | 保管容量、同時利用、検索基盤の構成 | 応答時間と検索結果の関連性 |
| 更新処理 | 文書の更新頻度、差分反映の方法 | 日次更新か随時更新か、削除反映の有無 | 古い情報が残らない仕組み |
| アプリケーションとRAG | 画面、認証、生成AI、ログ、出典表示の有無 | 既存システムとの連携範囲 | 権限と回答評価の責任分担 |
| 運用 | 監視、評価、問い合わせ、モデルや文書の変更 | 誰が結果を確認し、いつ改善するか | 精度低下や障害時の対応 |
見積もりを依頼するときは、「ベクトル検索一式」ではなく、工程ごとの作業範囲を分けてもらうと比較しやすくなります。小規模検証と本番運用で、データ量、更新処理、権限、監視がどう変わるかも並べてください。
期間も、データ整備の状態や既存システムとの接続範囲で変わります。まず少量のデータで検索結果を評価し、その後に対象領域、更新処理、認証、運用を追加する段階設計なら、未確定の要件を分けて判断できます。
- 初回の試算、対象データ量、質問数、検索回数、更新頻度を整理します。
- 構成別の試算、ベクトル検索だけ、既存検索との併用、RAG組み込みで分けます。
- 運用費の試算、保管や検索だけでなく、再埋め込み、監視、評価、保守を含めます。
- 変更時の確認、文書量や利用者数が増えた場合に、どの費用項目が動くかを確認します
自社対応と外部支援の分かれ目
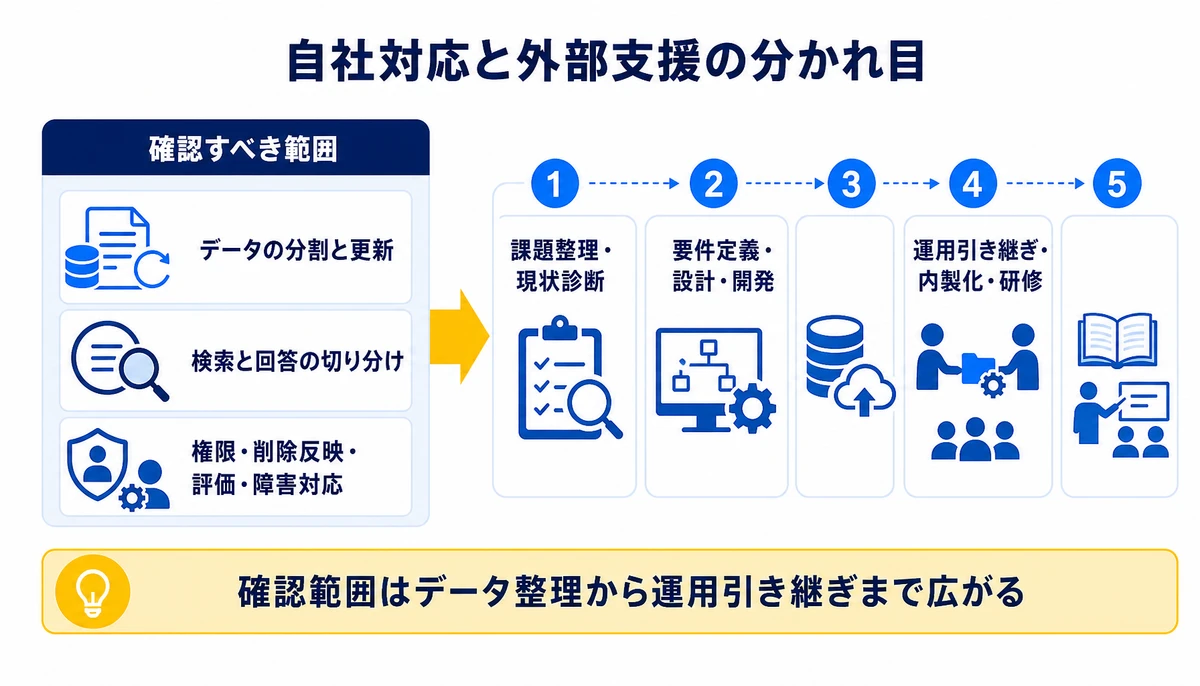
自社で進める場合、最初に詰まりやすいのは検索基盤の構築そのものとは限りません。どの文書を正解とするか、どの単位で分割するか、検索結果を誰が評価するかが曖昧なままだと、技術を変えても判断できません。
- データの分割と更新、文書ごとに構造や更新頻度が異なり、登録単位を揃えにくい
- 検索と回答の切り分け、検索結果が悪いのか、生成AIの回答が悪いのか判定しにくい
- 本番運用の責任分担、権限、削除反映、評価、障害対応の担当が決まりにくい
外部の支援を使うと、検索基盤だけを納品して終えるのではなく、対象データの整理と評価設計から進めやすくなります。費用も一式で比較するより、要件定義・開発・運用引き継ぎなどの範囲に分けて確認するのがおすすめでしょう。
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式いくらの見積もりではなく詳細な見積もりを出し、契約後に要件が動いても決めた範囲で優先順位を入れ替えて進む体制です。企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。
本番環境への展開後は、運用の引き継ぎ、内製化の支援、担当者向けの研修まで対応範囲に含めています。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
ベクトル検索とは?
文章や画像などを、意味や文脈を表す数値ベクトルへ変換し、ベクトル同士の類似度を使って近いデータを探す検索手法です。入力と文書の表記が違っても、意味が近ければ候補になる可能性があります。
キーワード検索は不要になりますか?
不要になるとは限りません。型番、製品コード、規程番号のように文字列の一致が重要な情報もあります。意味検索とキーワード検索を組み合わせるハイブリッド検索を検討してください。
ベクトル検索だけでRAGを作れますか?
ベクトル検索だけではRAG全体は完成しません。検索結果を生成AIへ渡す処理、回答の出典表示、アクセス権限、回答評価、文書更新への対応が必要です。
費用は何を基準に見積もればよいですか?
対象データ量、埋め込み生成の回数、ベクトルの保管量、検索回数、更新頻度を基準にします。RAGや既存システムとの連携、監視、評価、運用引き継ぎも別項目に分けて確認してください。
最初に何を用意すればよいですか?
検索対象を1領域に絞り、実際の質問と期待する検索結果を用意してください。規程やFAQなら、言い換えを含む質問を並べ、検索結果のどこが正しいかを記録すると検証を始めやすくなります。
外部に依頼するときは何を確認すべきですか?
検索基盤の構築範囲だけでなく、データ分割、評価用質問、権限管理、更新処理、運用引き継ぎの担当を確認してください。見積もりが工程別になっているかも、依頼先を比べる材料になります。
参考・出典
ベクトル検索は、生成AI専用の特別な技術としてではなく、意味の近さで情報を探す検索基盤として捉えると導入範囲を決めやすくなります。まずは検索対象、利用場面、評価用の質問を小さく揃え、データ分割と検索結果を確認してください。
そのうえで、キーワード検索との併用、RAGへの組み込み、更新と権限の運用を追加します。費用は検索サービスの料金だけでなく、埋め込み生成、保管、更新、アプリケーション、運用の単位で見積もると、次の判断へ進みやすくなります。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
社内規約をゼロから理解する 定義と作る順番と工程ごとの費用の見方
社内規約とは何か、規程や規定、就業規則とどう違うのかを整理します。AI導入にも使える整備の手順、優先順位の付け方、費用を見積もる際の考え方まで解説します。
AIファインチューニングとは何か 業務に合わせてモデルを最適化する前に確認すること
ファインチューニングとは何かを、RAGやプロンプトとの違い、業務データの整え方、評価方法、導入手順、費用と期間を判断する視点まで整理します。AI導入で迷う企業が、学習を始める前に確認すべき条件も紹介します。
AIエージェントとは 業務を任せる前に決めたい人の確認点
AIエージェントとは何かを生成AIやRPAとの違いから整理し、企業で導入する前に決めたい業務範囲、権限、人の確認点、失敗時の戻し方、費用の見方まで具体的に解説します。















