
AWS aws-benchが変えるAIエージェント導入の安全基準
要約
AWSが公開したaws-benchは、AIエージェントの回答力ではなく、クラウド上の実タスクを安全に完了する力を測ります。評価項目の読み解き方から、権限を段階的に広げる導入手順、失敗時の復旧と監査ログの設計まで、企業が導入前に確認すべき基準を整理します。
クラウド運用をAIで自動化するとき、質問への回答が正しければ十分とは限りません。実際の環境で適切なツールを選び、必要な範囲だけを変更し、失敗後に戻せるかが問われます。
この記事の対象読者
- クラウド運用をAIで自動化したい企業
- AWSの障害対応を効率化したい組織
- AIへ本番権限を渡す条件を検討する企業
- インフラ人材不足に悩む企業
- AIエージェントの安全性を評価したい企業
回答の正しさと、環境を壊さずに作業を完了する力は別々に測る必要があります。
AWSが公開した実タスク評価
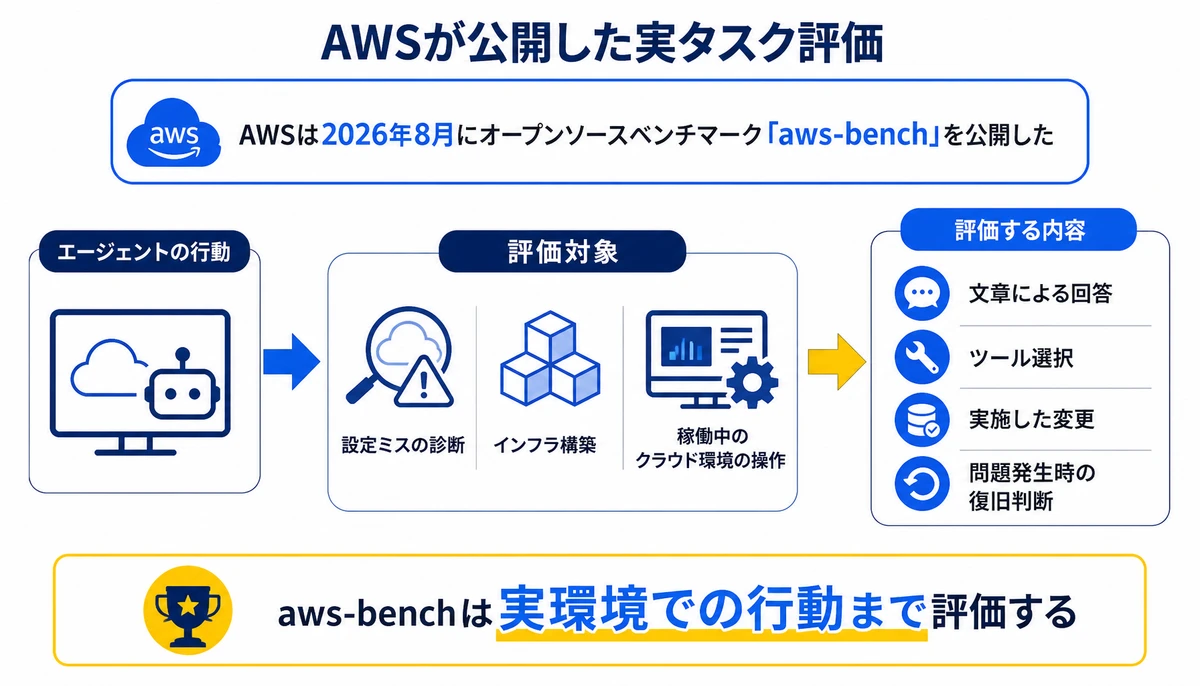
InfoQの報道によると、AWSは2026年8月にオープンソースベンチマーク「aws-bench」を公開しました。AIエージェントがクラウド環境で実際のタスクをどこまで正確に完了できるかを測る仕組みです。
評価対象には、クラウド設定ミスの診断、インフラ構築、稼働中のクラウド環境の操作が含まれます。単なる知識問題ではなく、操作を伴う課題として設計されている点が特徴です。
- 診断、設定ミスの原因を特定し、不要な変更を避ける
- 構築、指定された条件に合わせてインフラを用意する
- 操作、稼働中の環境へ適切な手順で変更を加える
- 復旧、問題が起きたときに戻す方法を選ぶ

回答精度から操作精度へ
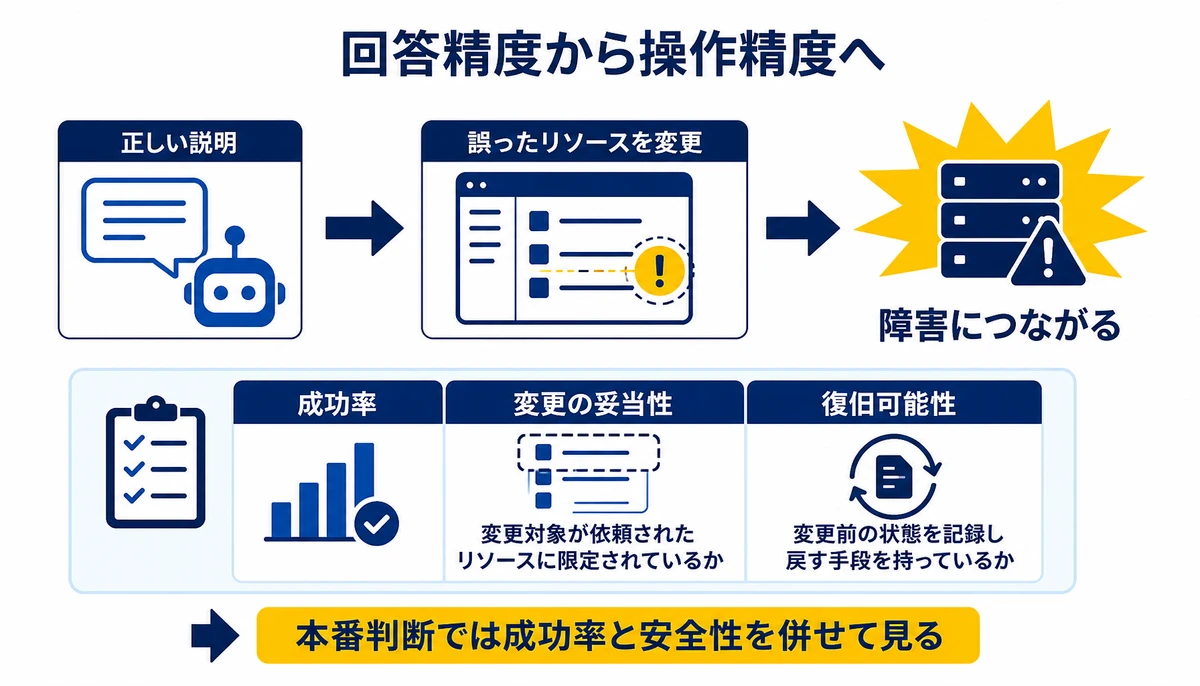
従来のAI評価では、質問に対する正答率や説明の妥当性が確認されがちでした。しかしクラウド運用では、正しい説明を出しても、誤ったリソースを変更すれば障害につながります。
BinxAIが現場で見てきた範囲では、導入判断で詰まりやすいのは、エージェントが何を答えたかより、何を実行したかの確認です。成功率だけでなく、変更の妥当性と復旧可能性を同じ評価表に置く必要があります。
- 依頼に対して、適切なAWSツールを選んだか
- 変更対象が依頼されたリソースに限定されているか
- 変更前の状態を記録し、戻す手段を持っているか
- 権限不足のときに無理な回避策を取らないか
- 作業履歴を後から確認できるか
この見方を採ると、AIベンチマークの点数をそのまま本番投入の可否に使わずに済みます。自社の障害対応や設定変更を再現した評価環境で、操作単位の記録を残す設計が必要です。
権限を広げる導入手順
読み取り専用から始める理由
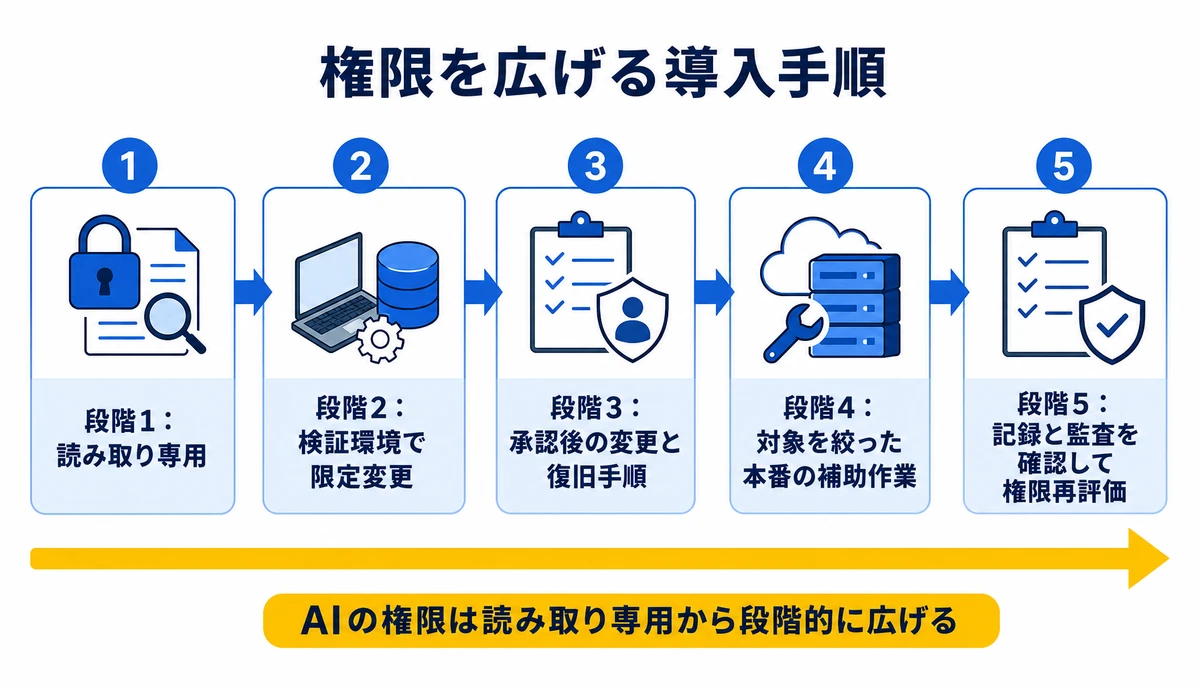
本番権限を最初から与えると、評価と事故対応が同時に発生します。まずは読み取り専用の環境で、診断結果と提案内容を人が確認する形から始めるのが基本です。
- 段階1、読み取り専用で設定確認と障害原因の候補出しを行う
- 段階2、検証環境で限定的な変更を実行し、差分を確認する
- 段階3、承認後だけ変更できる環境で復旧手順を試す
- 段階4、対象サービスと操作を絞って本番の補助作業に使う
- 段階5、記録と監査を確認したうえで権限範囲を再評価する
段階ごとの確認項目
各段階で見る項目を変えると、判断がしやすくなるでしょう。初期は診断の正確さ、中盤は変更範囲と復旧、本番前は権限境界と監査ログが確認の中心になります。
| 確認段階 | 主な評価項目 | 人が確認する内容 |
|---|---|---|
| 読み取り専用 | 診断結果と根拠 | 事実と推測が分かれているか |
| 検証環境 | 変更内容と影響範囲 | 不要なリソースを触っていないか |
| 承認付き実行 | 復旧手順と停止条件 | 異常時に処理を止められるか |
| 本番の補助作業 | 権限境界と監査ログ | 誰が何を許可したか追跡できるか |
クラウド運用への実務的な影響
評価シナリオの作り方
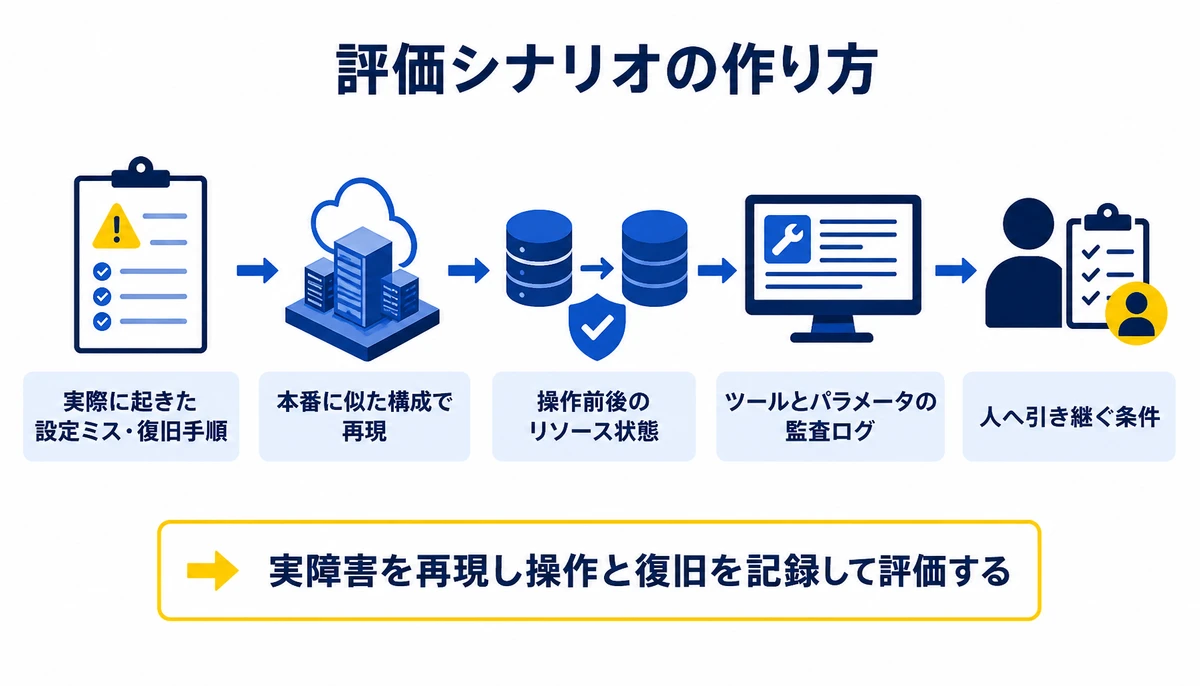
aws-benchが示す流れを導入判断に引き寄せると、AIエージェントをチャットボットとしてではなく、操作主体として評価することになります。障害対応では、原因説明の品質と同時に、実行したコマンドや変更差分を確認する運用が必要です。
評価シナリオは、実際に起きた設定ミスや手作業の復旧手順から作るのが近道です。タスクごとに許可されたツール、変更範囲、停止条件、復旧方法を記録すると、モデルや設定を変えた後も比較できます。
- 本番に似た構成で、設定ミスと復旧作業を再現する
- 操作前後のリソース状態を保存する
- 実行したツールとパラメータを監査ログに残す
- 失敗時に人へ引き継ぐ条件を決める
この基準なら、インフラ自動化を一気に進めるのではなく、確認できる作業から広げられます。評価結果は導入時だけでなく、モデル更新や権限変更のたびに見直すとよいでしょう。

自社検証と外部支援の分かれ目
自社で検証を始めると、まず実タスクの選定で迷いがちです。設定ミスの再現、変更前後の状態保存、失敗時の復旧手順を別々に用意すると、評価環境の整備だけで止まりやすくなります。
- 実際の障害対応を安全な評価シナリオへ置き換えられない
- エージェントに許可するツールと権限の境界を決められない
- 監査ログと復旧確認を、成功率とは別に採点できない
外部の支援を使う場合、ツールの導入だけでなく、課題の整理から評価条件の設計までを一続きで確認できるでしょう。BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。
一式いくらという見積ではなく、要件を整理したうえで詳細な見積を提示するスタイル。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められます。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。運用の引き継ぎや内製化、担当者向けの研修まで含めて、自社で扱える状態を整えるのが目標です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
aws-benchは何を評価しますか?
クラウド設定ミスの診断、インフラ構築、稼働中の環境の操作を評価します。回答文だけでなく、選んだツール、実施した変更、問題発生時の復旧判断も対象です。
回答精度と操作精度はどう違いますか?
回答精度は、質問に対する説明や診断が妥当かを見る指標です。操作精度は、正しい対象へ必要な変更だけを加え、失敗時に復旧できるかを見るもの。両者は別々に測る必要があります。
AIエージェントへ本番権限を渡す条件は何ですか?
成功率だけで決めず、許可されたツール、変更範囲、停止条件、復旧手順、監査ログを確認します。読み取り専用から始め、検証環境と承認付き実行を経て段階的に広げていくのが基本です。
失敗時に最低限残すログは何ですか?
依頼内容、判断の根拠、選択したツール、実行内容、変更前後の状態、エラー、復旧操作が最低限の記録です。人へ引き継いだ時刻と担当も加えると、原因を追いやすくなるでしょう。
自社で評価環境を作るときの最初の作業は何ですか?
過去の設定ミスや障害対応から、再現できる実タスクを1つ選ぶところが出発点です。許可する操作、成功条件、失敗時の停止条件、復旧方法を先に文章化してください。
AWS aws-benchが示したのは、AIエージェントを答えの巧拙だけでなく、クラウド環境での行動として測る視点です。まずは読み取り専用の実タスクから始め、変更範囲、復旧判断、監査ログを確認しながら権限を広げてください。
本記事の情報は2026年8月23日時点の公開情報に基づきます。AWSおよび各サービスの仕様は変更される場合があるため、導入や契約の前に各社へ確認してください。本記事は特定の成果や安全性を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
Google A2AがAAIF参加AIエージェント標準化は次の段階へ
GoogleのAIエージェント間通信プロトコルA2AがAgentic AI Foundationに加わった背景を整理します。MCPとの違い、認証と責任分界、ベンダーロックインを避ける設計を企業の導入判断に引き寄せて解説します。
AIエージェントの学習と運用を分断しないMicrosoft Agent Lightningの実力
Microsoft Agent Lightning v1.0が公開されました。既存コードやツールを活かしてAIエージェントを強化する仕組みと、SWE-benchの性能報告を整理し、企業が評価・安全設計・小規模検証を進める手順を解説します。
常時稼働AIエージェント向け30BモデルをNVIDIAが公開、動的ルーティングも
NVIDIAが2026年8月11日、オープンウェイトの30Bモデル「Nemotron 3.5 Lightning」を公開した。常時稼働型AIエージェントを明示的な用途として設計し、同時リリースのNeMo Switchyardによるマルチモデル動的ルーティングと組み合わせることで、クラウドAPIコストに悩む企業のオンプレ運用戦略に新たな選択肢をもたらす。















