
常時稼働AIエージェント向け30BモデルをNVIDIAが公開、動的ルーティングも
要約
NVIDIAが2026年8月11日、オープンウェイトの30Bモデル「Nemotron 3.5 Lightning」を公開した。常時稼働型AIエージェントを明示的な用途として設計し、同時リリースのNeMo Switchyardによるマルチモデル動的ルーティングと組み合わせることで、クラウドAPIコストに悩む企業のオンプレ運用戦略に新たな選択肢をもたらす。
AIエージェントの常時稼働運用を検討する上で、クラウドAPIのコスト問題はずっと現実的な壁でした。
推論呼び出しが頻繁になるほど費用がかさみ、「PoC止まり」になるケースを私たちも多く見てきました。
NVIDIAが今回「常時稼働型AIエージェント」という用途区分をモデル設計の中心に据えてきました。その壁に正面から応えようとする動きです。
この記事の対象読者
- AIエージェントの本番運用を検討しているエンジニア・アーキテクト
- クラウドAPI依存のコスト・データ管理リスクを気にしている情報システム担当者
- マルチモデル戦略やオンプレ推論基盤の設計を始めたばかりのチーム
NVIDIAが公開したNemotron 3.5 Lightningの概要
30Bオープンウェイトモデルの位置づけ
NVIDIAは2026年8月11日、30Bパラメータのモデル「Nemotron 3.5 Lightning」を公開しました。オープンウェイトでの提供です。
公式日本語ブログでは「小規模モデル並みのコストで大規模モデル並みの処理能力」と説明されています。
常時稼働型エージェントという想定用途
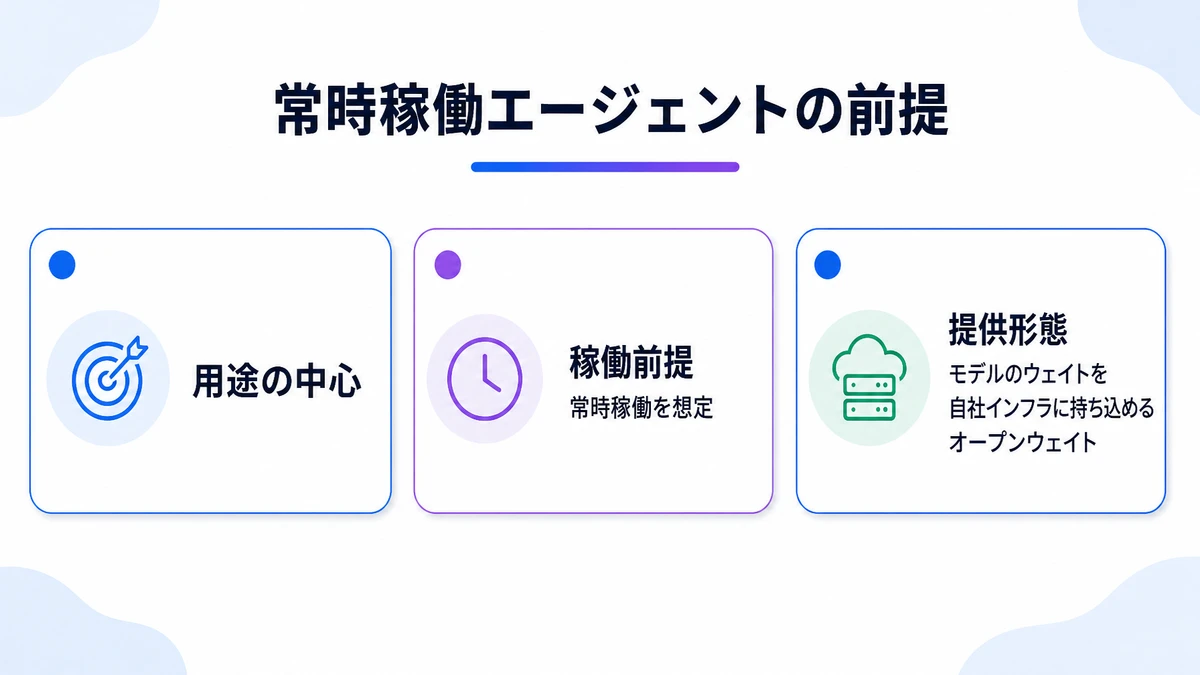
用途として明示されているのが「常時稼働型AIエージェント」です。具体的には「OpenClaw」「Hermes Agent」といったユースケースが想定されています。
単発の生成タスクではなく、24時間継続して稼働するエージェントへの組み込みを前提に設計されています。
オープンウェイトである点も見逃せません。モデルのウェイトを自社インフラに持ち込める形での提供です。
- 用途の中心:常時稼働型AIエージェント(OpenClaw、Hermes Agentなど)
- 稼働前提:単発生成ではなく24時間の継続稼働を想定
- 提供形態:モデルのウェイトを自社インフラに持ち込めるオープンウェイト
クラウドAPIに推論を委ねる構成とは根本的に異なる運用を可能にします。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年8月11日 |
| パラメータ数 | 30B |
| モデル種別 | オープンウェイト |
| 主な想定用途 | 常時稼働型AIエージェント(OpenClaw、Hermes Agentなど) |
| 訴求ポイント | 小規模モデル並みのコストで大規模モデル並みの処理能力 |

同時リリースされたNeMo Switchyardが変えるエージェント設計
スマートルーティングライブラリの役割
今回の発表でもう一つ注目されるのが、オープンソースのスマートルーティングライブラリ「NeMo Switchyard」です。
エージェントのツール処理の内部で複数モデルを動的に切り替え、コストと精度のバランスを自動的に最適化できる仕組みです。
マルチモデル戦略へのシフト
これは、AIエージェントの設計が「単一の最高性能モデル一択」から変わることを意味します。「タスクの複雑さに応じてモデルを使い分けるマルチモデル戦略」へのシフトです。
たとえば、日常的な定型処理は軽量モデルで済ませる構成が考えられます。
複雑な推論が必要なステップだけ30Bや70Bクラスを呼び出す。こうした使い分けが、ルーティングライブラリ一本で実現できる可能性があります。
- 動的切り替え:ツール処理の内容に応じてモデルを自動選択
- コスト最適化:軽量モデルで処理できるタスクは大規模モデルを呼ばない
- 精度の担保:高い推論精度が必要なステップは適切なモデルを選択
- オープンソース:特定ベンダーにロックインされない構成が可能
クラウドAPIコストに悩む企業の実務への影響
PoC止まりになりがちな理由
私たちが見てきた範囲では、AIエージェントの本番導入を検討しながらも立ち止まっているケースが少なくありません。
「推論コストが読めない」「データをクラウドに送ることへの懸念が社内で解消できない」という理由です。
オンプレ運用で増える選択肢
Nemotron 3.5 Lightningはオープンウェイトモデルです。そのため、自社のオンプレサーバーやプライベートクラウドに配置して運用できます。
クラウドAPIへのデータ送信を避けたい組織にとって、データガバナンス上の選択肢が一つ増えた形です。
ただし、いくつか前提条件の確認が必要です。
- 日本語対応の詳細は現時点で未確認。日本語タスクへの適用前には実際のベンチマーク検証を行うこと
- 推論インフラの調達:30Bモデルを常時稼働させるには相応のGPUリソースが必要
- NeMo Switchyardのルーティング設計:どのタスクをどのモデルに割り当てるかの設計が品質を左右する
- ライセンスの確認:オープンウェイトであっても商用利用条件は個別に確認が必要
マルチモデル戦略への移行は、運用設計の複雑さが増す側面もあります。
まずNeMo Switchyardの小規模なPoC環境で動作を確認してから、本番設計に進むアプローチが現実的です。
よくある質問
Nemotron 3.5 Lightningはどこでダウンロードまたはアクセスできますか?
NVIDIA公式の発表ではオープンウェイトモデルとして公開されています。
ただし具体的な配布場所(Hugging Faceなど)の詳細は、NVIDIA公式ブログおよびリポジトリを直接ご確認ください。
NeMo SwitchyardはNemotron以外のモデルとも組み合わせられますか?
NVIDIAの発表によれば、NeMo Switchyardは複数モデルを動的に切り替えるライブラリです。Nemotron専用という制限は明示されていません。
他モデルとの組み合わせを想定した汎用ライブラリとみられます。対応モデルの詳細は公式ドキュメントで確認するとよいでしょう。
30Bモデルを自社インフラで動かすにはどのくらいのGPUが必要ですか?
量子化の方式や推論フレームワークによって大きく異なります。一般的に30Bクラスのモデルをfloat16で動かすには、40GB以上のVRAMが目安になる場合が多いでしょう。
int4/int8量子化を使えば要件を下げられます。NVIDIAはRTXおよびDGX環境での動作を想定している旨を公式ブログで言及しています。
日本語での利用は問題なく使えますか?
現時点ではNVIDIAの公式発表に日本語対応の詳細な記載は確認できていません。日本語タスクに適用する場合は、実際の用途に近い日本語データでベンチマークを取ることが先決です。
英語中心に設計されたモデルを日本語業務に使う際は、別途ファインチューニングが必要になるケースもあるでしょう。
常時稼働型AIエージェントと通常のチャットボットは何が違うのですか?
チャットボットは人間からの入力を待って応答します。一方、常時稼働型AIエージェントはスケジュールやイベントをトリガーに自律的にタスクを実行し続けるもの。
推論呼び出しの頻度が桁違いに多くなるため、呼び出しあたりのコストと遅延が設計の核心になります。Nemotron 3.5 Lightningがこの用途を明示している背景には、そのコスト構造への意識があります。
NVIDIAが「常時稼働型AIエージェント」を正面に掲げてモデルを投入しました。エージェント運用の設計論が変わりつつあります。
オープンウェイトでの提供と、NeMo Switchyardによるマルチモデルルーティング。この二つの要素を組み合わせると、クラウド依存を減らしながらコストをコントロールする構成が現実的な選択肢になってきました。
日本語対応の検証など確認すべき前提条件はあります。それでも自社インフラでのエージェント基盤を検討しているチームには、評価を始める価値のある動きでしょう。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
MetaがMuse Codeを発表。大規模コードベースを自律実行する永続エージェント
MetaがベータリリースしたMuse Codeは、ターミナルベースの永続サブエージェントとして計画・実装・検証を一貫して担う。単発の回答支援から継続的な業務実行へ、AIコーディングエージェントの役割転換が何を意味するのか、開発組織の実務視点から整理します。
データベース運用をAIに任せるGoogle Cloudの新エージェント
Google Cloudが紹介した2種類のデータベースエージェントをもとに、初期構築から監視・障害対応までの適用範囲を整理します。変更権限と承認を分け、小さく始める導入手順も紹介します。
AWS aws-benchが変えるAIエージェント導入の安全基準
AWSが公開したaws-benchは、AIエージェントの回答力ではなく、クラウド上の実タスクを安全に完了する力を測ります。評価項目の読み解き方から、権限を段階的に広げる導入手順、失敗時の復旧と監査ログの設計まで、企業が導入前に確認すべき基準を整理します。















