
MetaがMuse Codeを発表。大規模コードベースを自律実行する永続エージェント
要約
MetaがベータリリースしたMuse Codeは、ターミナルベースの永続サブエージェントとして計画・実装・検証を一貫して担う。単発の回答支援から継続的な業務実行へ、AIコーディングエージェントの役割転換が何を意味するのか、開発組織の実務視点から整理します。
2026年、AIコーディングツールの話題は「どのモデルが精度が高いか」から変わってきました。「どれが開発フローに自然に溶け込むか」へと明らかに移ってきています。
その流れに明確な形を与えるリリースがMetaから届きました。Muse Codeです。
この記事の対象読者
- 内製開発組織を持つ企業でAIコーディングツールの導入を評価中の開発責任者・エンジニアリングマネージャー
- 大規模なコードベースを抱えており、リファクタリングや機能追加の速度向上を課題と感じているエンジニア
- AIエージェントの「継続実行」というトレンドが自社の開発体制に何をもたらすか把握したいプロダクトオーナー
MetaがMuse CodeとMuse Spark 1.2を同時発表、ベータ公開
発表された2つのプロダクト
MetaはMuse CodeおよびMuse Spark 1.2を発表しました。このうちMuse Codeをベータ版として公開しています。
Muse Codeはターミナルベースのコーディングエージェントです。大規模リポジトリを対象に複雑な変更の計画・実装・検証を一貫して担う永続サブエージェントとして設計されています。
基盤となるモデルはMuse Spark 1.2です。エンタープライズ規模のソフトウェア開発ワークフローへの組み込みを想定した設計といえるでしょう。

「単発の回答」から「継続的な業務実行」へ、何が変わったのか
従来ツールとの役割定義の違い
従来のAIコーディングツールは、エディタ上での補完やチャット形式での質問応答が主な使い方でした。一つの関数を書いてもらう、エラーの原因を説明してもらう、という単発の対話です。
Muse Codeが示す設計は、その延長線上にありません。変更の計画から実装、検証まで一貫して担うという役割定義があります。
これは人間の開発者が「確認してOKを出す立場」に回ることを前提にした設計。ターミナルベースという実装の選択も、この方向性と整合しています。
IDEのプラグインや専用UIではなく、既存のCLIツールやCI/CDパイプラインとそのまま組み合わせられる形です。
3フェーズをエージェントが担う構造
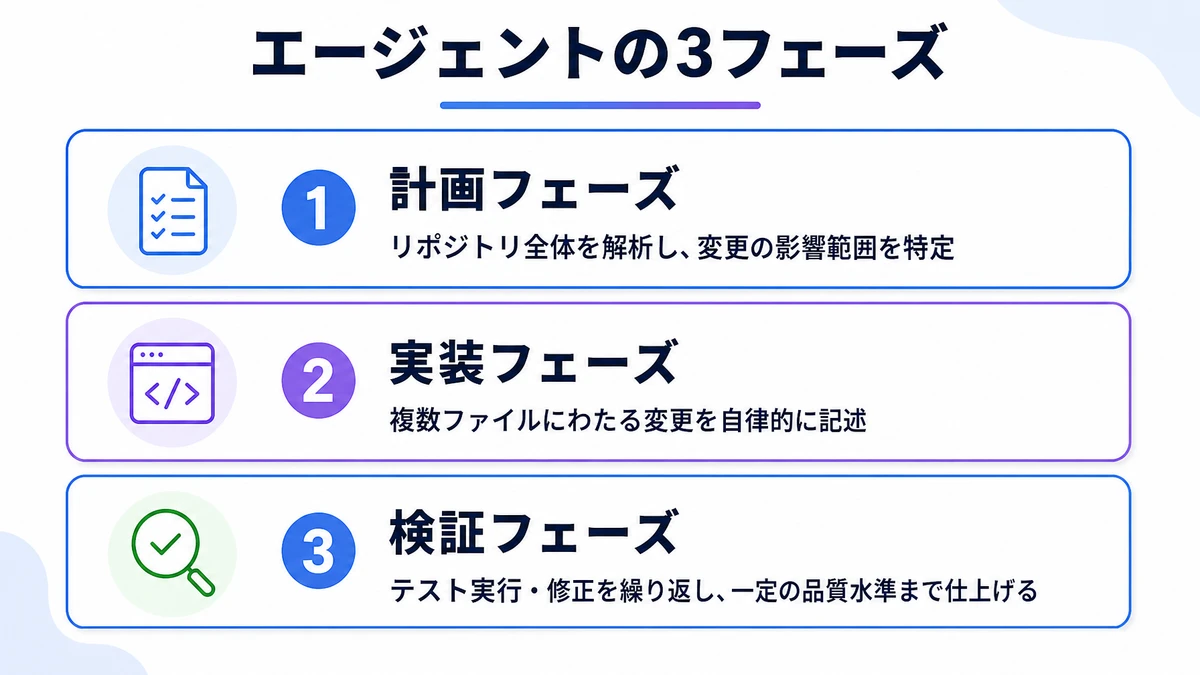
- 計画フェーズ: リポジトリ全体を解析し、変更の影響範囲を特定
- 実装フェーズ: 複数ファイルにわたる変更を自律的に記述
- 検証フェーズ: テスト実行・修正を繰り返し、一定の品質水準まで仕上げる
この3フェーズをエージェントが担うことで、人間は要件の定義とレビューに集中できる構造が生まれます。
競合の動きと、競争軸の変化
AWSも継続実行エージェントを発表
Muse Codeの発表と同じ時期、AWSも長時間の継続エージェント機能を発表しました。最長14日間にわたってタスクを継続実行できる機能とされています。単一企業の動きでなく、複数の主要プレイヤーが同じ方向に動いている点は注目に値するでしょう。
AIコーディングツールの差別化軸が変わりつつあります。モデルの単体精度からワークフローへの統合しやすさへとシフトしているとすれば、評価基準も変わってきます。
| 評価軸 | 従来のコーディングアシスタント | Muse Codeのような永続エージェント |
|---|---|---|
| 主な操作単位 | 1プロンプト = 1回答 | タスク全体を継続処理 |
| 対象スコープ | 関数・ファイル単位 | リポジトリ全体 |
| 人間の介在タイミング | 毎ステップで指示 | 要件定義とレビュー |
| 既存フローとの統合 | IDE/エディタ前提が多い | ターミナル/CLIで組み込み可 |
| ベータ段階でのリスク | 低(局所的な変更) | 高(広範囲の変更が自動化される) |
開発組織が今、評価で確認すべきこと
ベータ版としての向き合い方
Muse Codeは現在ベータ版です。本番のプロダクトコードに対して最初から使うのは避けたいところ。まず検証用のリポジトリや非クリティカルなタスクで動作を確認するのが現実的です。
永続エージェントが広範囲のファイルを変更するということは、レビューの設計も変わるでしょう。差分が大きくなるため、変更ログの追跡やレビュープロセスの整備がセットで必要になります。
内製開発の生産性向上施策を検討している組織では、Muse Codeのような永続エージェントが具体的な候補になりえます。
評価時のチェックポイント
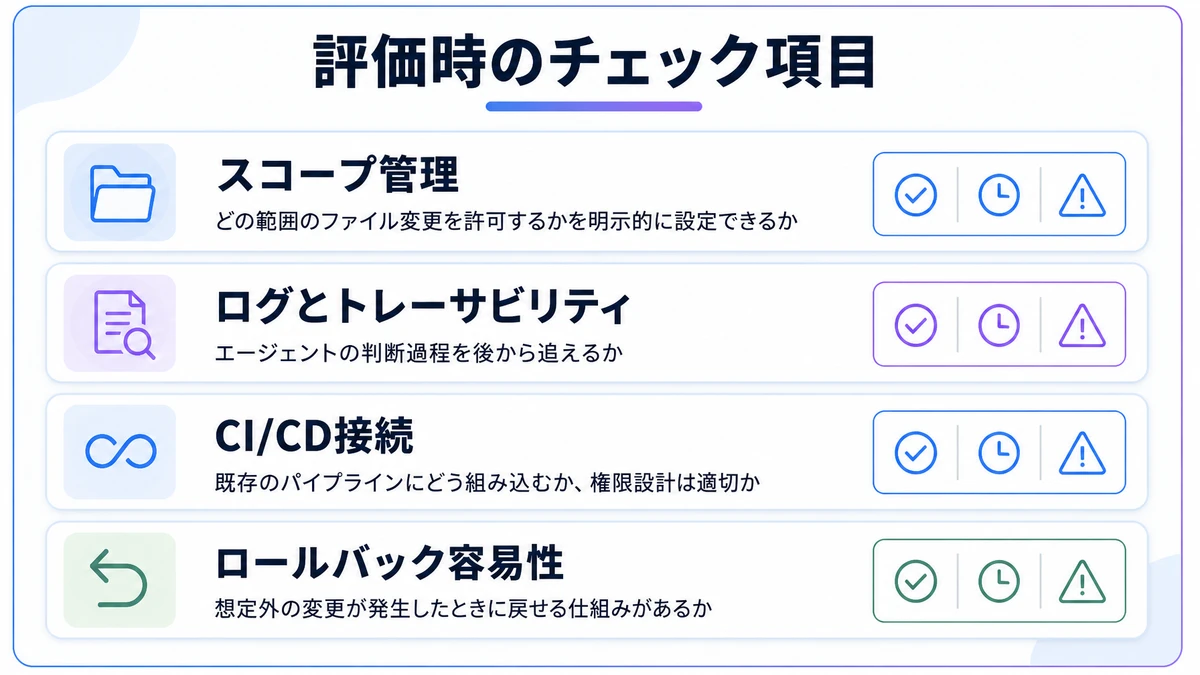
- スコープ管理: どの範囲のファイル変更を許可するかを明示的に設定できるか
- ログとトレーサビリティ: エージェントの判断過程を後から追えるか
- CI/CDとの接続: 既存のパイプラインにどう組み込むか、権限設計は適切か
- ロールバックの容易さ: 想定外の変更が発生したときに戻せる仕組みがあるか
評価対象として検討する価値があるでしょう。自社の開発フローへの組み込み方を設計したい場合は、BinxAIにご相談ください。

よくある質問
Muse Codeは今すぐ使えますか?
ベータ版として公開されています。本番環境への適用は段階的な検証を経てから判断するのが適切です。
Muse Codeと既存のGitHub CopilotやCursorの違いは何ですか?
GitHub CopilotやCursorは主にIDE上での補完・チャット支援が中心です。Muse Codeはターミナルベースで動作します。
大規模リポジトリ全体を対象に、計画・実装・検証を一貫して継続実行する永続サブエージェントという位置づけ。役割の粒度がそもそも異なります。
どんなコードベースで使うことを想定していますか?
Metaの発表では「大規模リポジトリを対象に複雑な変更の計画・実装・検証を担う」とされています。規模の大きいモノリシックなコードベースでの活用が想定されているとみられます。多数のサービスが絡み合うマイクロサービス構成も対象になるでしょう。
Muse Spark 1.2との関係は何ですか?
Muse Spark 1.2はMuse Codeの基盤となるモデルです。Metaは今回、モデル単体(Muse Spark 1.2)を発表しました。それを活用するエージェントアプリケーション(Muse Code)も同時に公開しています。
日本語のコードベースやコメントに対応していますか?
現時点での公式発表には日本語対応に関する明示的な記載はありません。ベータ版評価の段階で、日本語コメントが混在する自社のコードベースでの動作確認を行うことをお勧めします。
AIエージェントが「単発の回答」を超えて業務を継続実行し始める段階に、開発ツール市場は確実に入ってきました。Muse Codeの登場はその流れを象徴する一歩でしょう。
今日の第一歩として、まず本番に触れない検証用リポジトリを1つ用意してください。そこで非クリティカルなタスクでMuse Codeの動作を確認するところから始めましょう。人間のレビュー手順をセットで組み込んでおくと、安心して評価を進められます。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
デジタル庁がMCP公開7万5000件の行政手続きをAIで検索
デジタル庁が約7万5000件の行政手続データを扱うMCPサーバを公開しました。AIエージェントでの検索・集計を可能にした取り組みを紹介し、企業が社内データ連携で確認すべき公開範囲や権限管理、ログ設計まで整理します。
AIエージェントの学習と運用を分断しないMicrosoft Agent Lightningの実力
Microsoft Agent Lightning v1.0が公開されました。既存コードやツールを活かしてAIエージェントを強化する仕組みと、SWE-benchの性能報告を整理し、企業が評価・安全設計・小規模検証を進める手順を解説します。
AWS aws-benchが変えるAIエージェント導入の安全基準
AWSが公開したaws-benchは、AIエージェントの回答力ではなく、クラウド上の実タスクを安全に完了する力を測ります。評価項目の読み解き方から、権限を段階的に広げる導入手順、失敗時の復旧と監査ログの設計まで、企業が導入前に確認すべき基準を整理します。















