
本番前にAIエージェントをどう評価するかUAEFで合格基準を設計する
要約
AWSが公開したUAEFは、回答品質だけでなくツール操作や安全性、性能、推論までAIエージェントを横断評価します。LangGraphやAmazon Bedrockに対応する評価基盤を、本番移行の合格基準へどう生かすかを整理します。
AIエージェントの導入では、回答が正しいかだけでは本番投入を判断できません。外部ツールへの指示、失敗時の振る舞い、業務上の安全性まで確認する必要があります。
海外では、AIエージェントを複数の観点から横断評価する基盤づくりが進んでいます。AWSが公開したUAEFは、この流れを具体的な評価処理として示したものです。
この記事の対象読者
- AIエージェントの本番移行基準がない企業や組織
- 複数のAIフレームワークを比較する企業や組織
- AIの安全性と業務品質を同時に測りたい企業や組織
- PoCの評価結果を経営判断につなげたい企業や組織
- AIエージェントの導入後も継続評価したい企業や組織
AWSが公開したUAEF
UAEFの概要と対応基盤
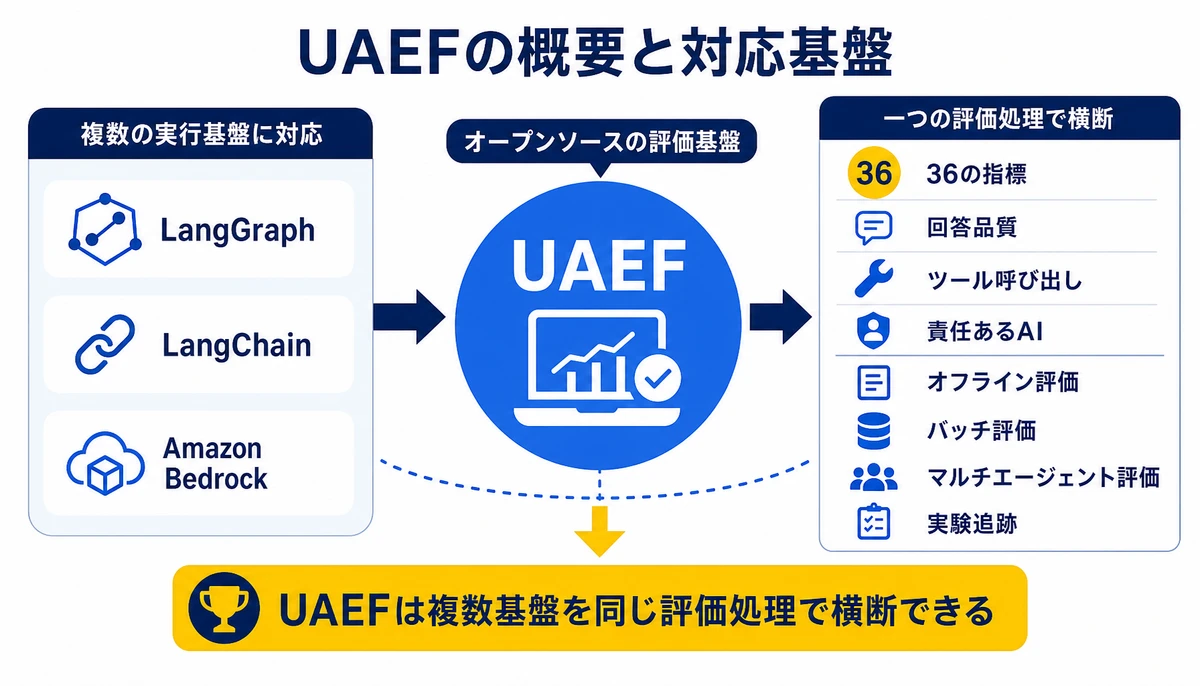
AWSは2026年10月7日、AIエージェントを横断的に評価するオープンソースのUAEFを公開しました。UAEFは、複数の実行基盤やクラウドをまたいだ評価を一つのプロセスにまとめる考え方です。
AWSの公開情報では、UAEFはLangGraph、LangChain、Amazon Bedrockなど複数のエージェント実行基盤に対応しています。特定のフレームワークだけで評価を完結させない設計です。
- 36の指標を一つの評価処理で扱う
- ツール呼び出しと回答品質を評価する
- 責任あるAI、性能、推論も評価対象に含める
- オフライン評価、バッチ評価、マルチエージェント評価に対応する
- 実験追跡で評価結果を残す
UAEFが示したのは、AIエージェントの評価を回答精度だけに閉じない進め方です。

36指標を本番基準へつなぐ視点
業務ごとの失敗条件を先に定める
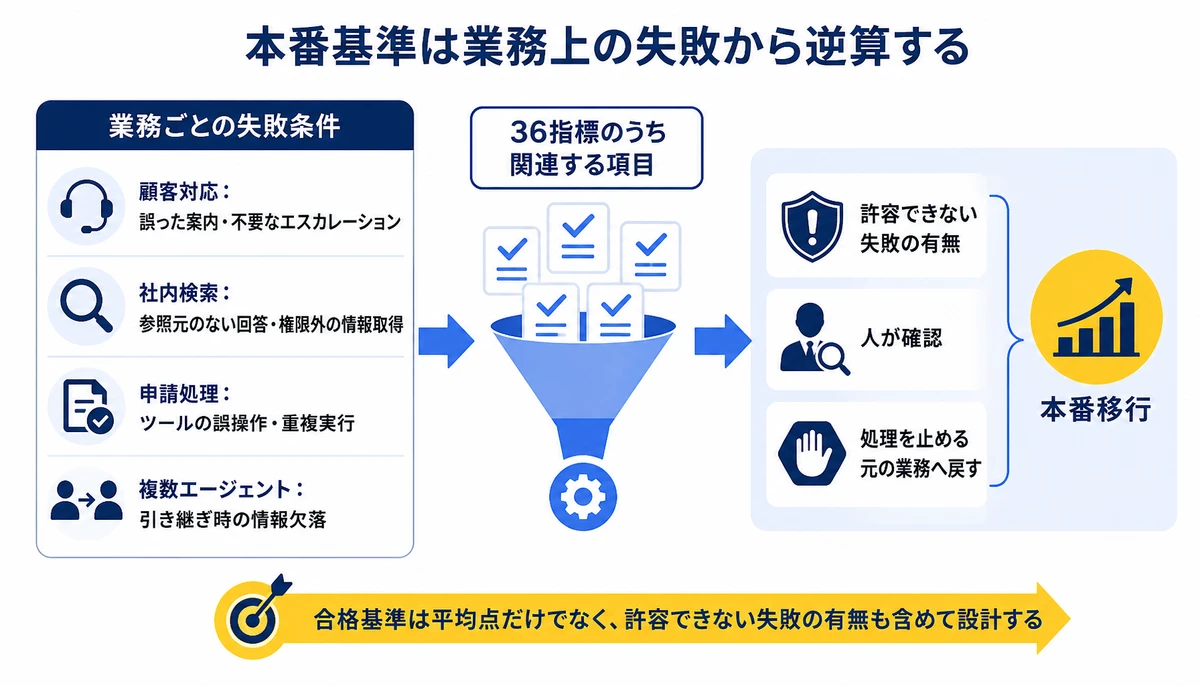
UAEFの36指標をそのまま採用すれば、本番移行が自動的に決まるわけではありません。業務ごとに許容できない失敗を先に定め、評価項目との対応を決める必要があります。
- 顧客対応なら、誤った案内や不要なエスカレーションを確認する
- 社内検索なら、参照元のない回答や権限外の情報取得を確認する
- 申請処理なら、ツールの誤操作や重複実行を確認する
- 複数エージェント構成なら、引き継ぎ時の情報欠落を確認する
この整理を行うと、36指標のうち何を合格判定に使うかが見えてきます。全項目を均等に見るのではなく、業務影響の大きいツール操作や安全性から確認する進め方です。
本番移行の合格基準は、モデルの点数ではなく業務上の失敗と結び付けて設計するものでしょう。
PoC後の比較と継続評価
共通指標で比較条件をそろえる
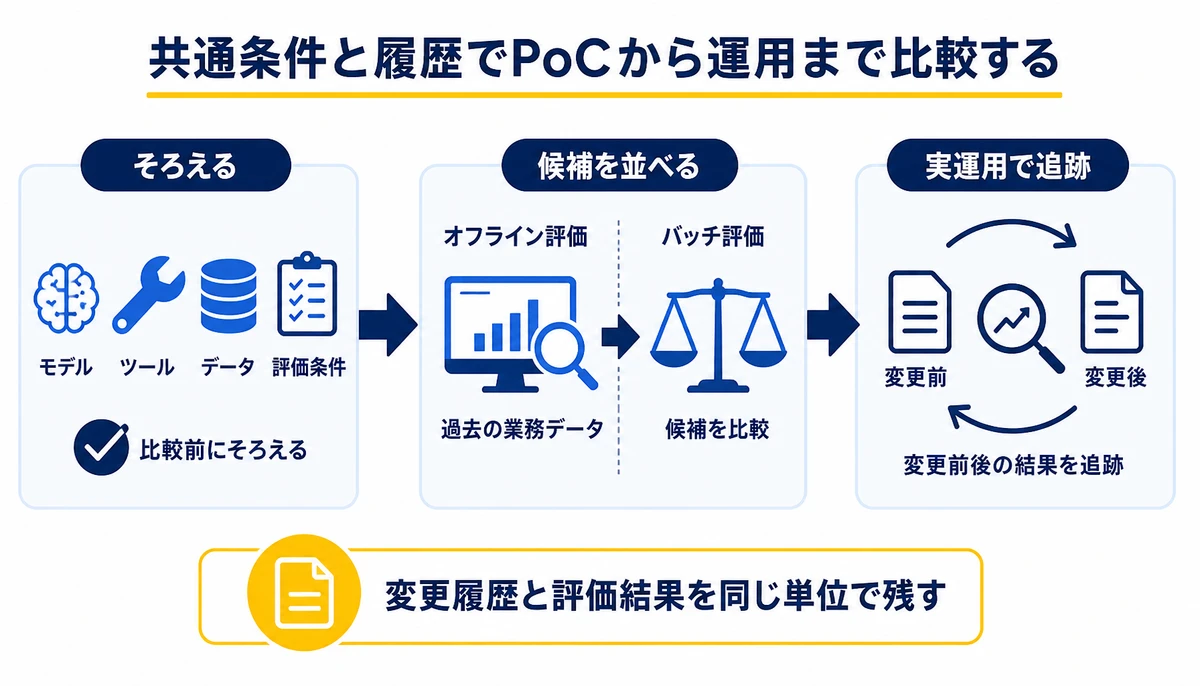
複数のAIフレームワークやクラウドを比較する場合、評価条件が異なると結果を並べにくくなります。UAEFのように共通の指標と実験履歴を持つ考え方は、比較の土台として参考になるものです。
オフライン評価で過去の業務データを確認し、バッチ評価で候補を並べるのが基本の流れ。本番後は変更前後の結果を追跡し、プロンプトやツール定義の更新による変化を確認します。
- 比較前に、モデル、ツール、データ、評価条件をそろえる
- 回答品質とツール操作を別々の結果として記録する
- 安全性に関する失敗は平均値で相殺しない
- 変更履歴と評価結果を同じ単位で残す
自社で進める際の障壁
評価を詰まらせる3つの壁
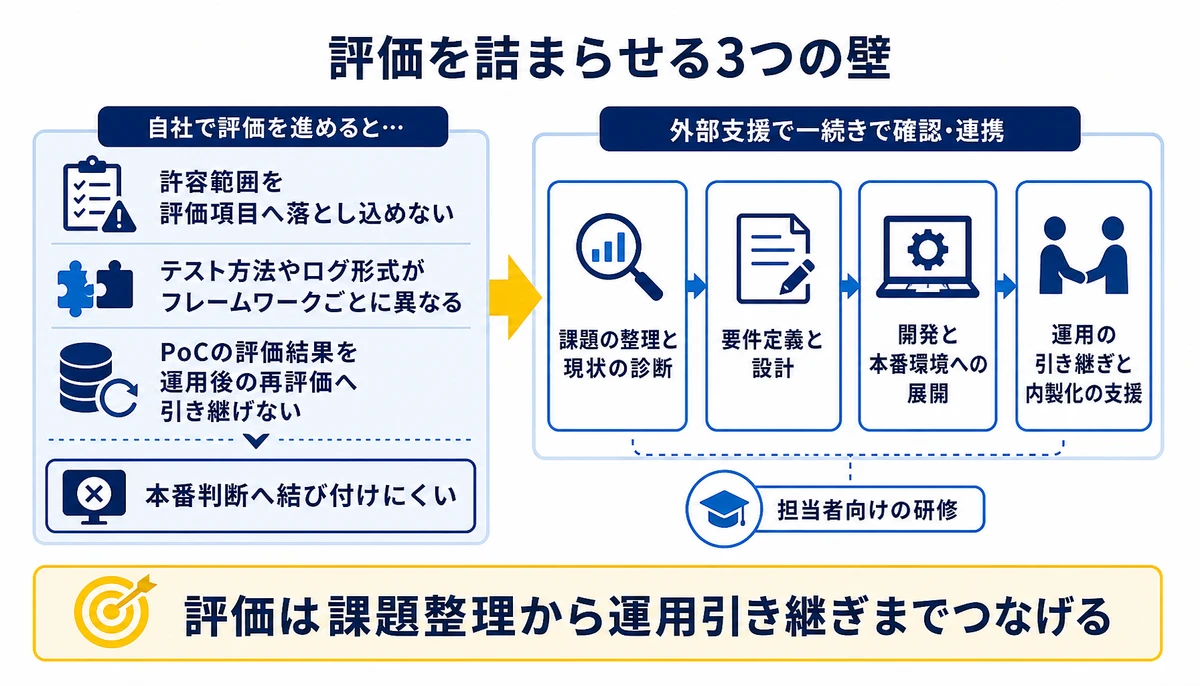
自社で評価を始めると、まず業務ごとの失敗条件を言語化する段階で詰まりやすくなります。ツール操作の記録と回答品質の判定を別々に行うと、結果を本番判断へ結び付けにくい点も課題でしょう。
- 業務上の許容範囲を評価項目へ落とし込めない
- フレームワークごとにテスト方法やログの形式が異なる
- PoCの評価結果を運用後の再評価へ引き継げない
外部の支援を使う場合は、評価ツールの導入だけでなく、課題の整理から評価条件、合格基準、運用方法までを一続きで確認できます。
BinxAI株式会社のみっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固める進め方をとっています。見積は一式ではなく、整理した要件に沿って詳細に示す形です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
UAEFとは?
UAEFは、AWSが2026年10月7日に公開した、AIエージェントを横断的に評価するオープンソースの基盤です。複数の実行基盤に対応し、評価結果を比較するための処理をまとめます。
UAEFは回答精度だけを測る仕組みですか?
回答精度だけではありません。AWSの公開情報では、ツール呼び出し、責任あるAI、性能、推論など36の指標を評価対象に含めています。
LangGraphやAmazon Bedrockで使えますか?
UAEFはLangGraph、LangChain、Amazon Bedrockなど複数のエージェント実行基盤に対応しています。実際の適用条件は、利用する構成と公開されている仕様を確認してください。
36指標をすべて合格基準にすべきですか?
すべてを同じ重みで判定する必要はありません。対象業務で起きた場合の影響が大きい失敗を先に定め、ツール操作や安全性など関連する指標から基準化するとよいでしょう。
本番後も評価を続けられますか?
UAEFはオフライン評価、バッチ評価、マルチエージェント評価、実験追跡に対応しています。導入後の変更を評価対象に含める場合は、変更前後の条件と結果を継続して記録するのが基本です。
AWSのUAEFは、AIエージェントを本番へ移す前に、回答品質、ツール操作、安全性、性能、推論を同じ評価の流れで確認する方向を示しています。まず対象業務の失敗条件を決め、共通の評価項目と合格基準へ落とし込むところから始めてみてください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
LangChainがLangSmithを強化 本番エージェントに必要な機能とは
LangChainが発表したLangSmithの更新を手がかりに、Engine v2の問題検知と修正検証、レッドチーム評価、ユーザー単位のメモリと認証を整理します。LangGraphの試作を本番へ移す際の確認項目も紹介します。
AIエージェントを本番業務へ移すMicrosoft Agent Framework運用設計の要点
Microsoft Agent Frameworkを手がかりに、AIエージェントを本番業務へ移す際のタイムアウト、状態管理、OpenTelemetry監視、失敗復旧、責任分界を設計者の視点で整理します。
既存Java資産にAIを組み込むJetBrains Koog 1.0入門
JetBrains Koog 1.0をPythonの代替ではなく、既存のKotlin・Java業務システムへAIエージェント処理を組み込む選択肢として整理します。構成、実装手順、認証やトランザクションの境界、本番前の評価項目を具体的に紹介します。















