
LangChainがLangSmithを強化 本番エージェントに必要な機能とは
要約
LangChainが発表したLangSmithの更新を手がかりに、Engine v2の問題検知と修正検証、レッドチーム評価、ユーザー単位のメモリと認証を整理します。LangGraphの試作を本番へ移す際の確認項目も紹介します。
AIエージェントの開発では、デモが動いた後に問題が表面化します。誤回答の発見、修正の確認、利用者ごとの権限管理が別々に残るためです。
海外では、エージェントを作って動かす段階から、本番で評価し続ける段階へ移す議論が進んでいます。今回のLangChainの発表も、その流れに位置づけられるでしょう。
この記事の対象読者
次の課題を抱えている企業や組織を対象とします。
- LangGraphでAIエージェントを試す企業
- エージェントの本番障害に困る企業
- AIの認証とメモリを設計したい企業
- レッドチーム評価を導入したい企業
- PoCを本番運用へ移したい企業
LangChainが発表した3つの更新
LangChainは2026年9月25日、AIエージェントの本番運用を支援する更新を発表しました。対象には、LangSmith Engine v2とManaged Deep Agents v0.8などが含まれます。
LangSmithは、エージェントの実行状況を確認し、評価や改善につなげるためのサービスです。今回の発表では、開発時の観測だけでなく、本番後の検証まで意識した機能が示されました。
- Engine v2で、エージェントの問題を先回りして検知する機能
- レッドチーム評価を運用へ接続する機能
- 修正後のエージェントを自動検証する機能
- Managed Deep Agentsで、ユーザー単位のメモリと認証を扱う選択肢

問題検知から修正検証まで
Engine v2が対象とする障害の追跡
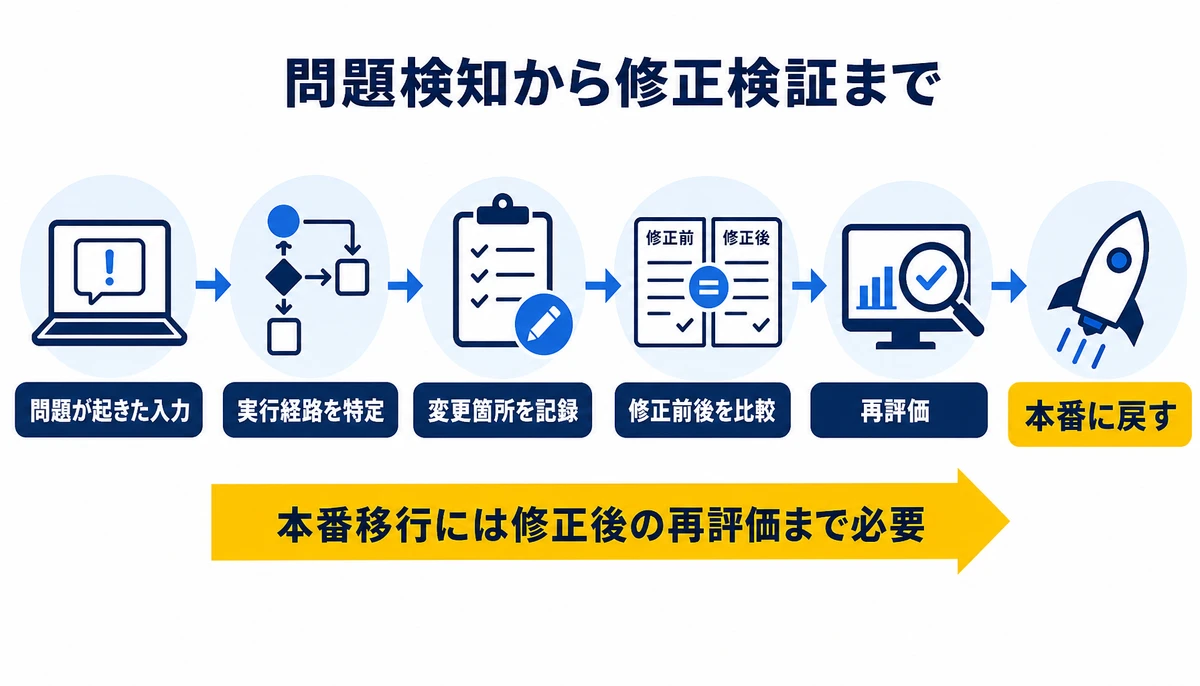
Engine v2では、エージェントの問題を先回りして検知し、修正結果を自動検証する機能が示されています。回答を一度確認して終えるのではなく、異常の発見から再評価までをつなぐ考え方です。
現場で見ると、障害対応の難しさは誤回答そのものだけにありません。どの入力で問題が起きたか、変更後に別の処理が壊れていないかを追跡できない点にも難しさがあります。
- 問題が起きた入力と実行経路を特定する
- プロンプトやツールの変更箇所を記録する
- 修正前後の回答と処理結果を比較する
- 本番に戻す前に再評価の結果を確認する
本番移行の判断は、回答精度の確認だけでなく、問題を発見して修正を確かめる経路まで含めて行う必要があります。
メモリと認証を利用者単位で管理
ユーザー単位の設計で変わること
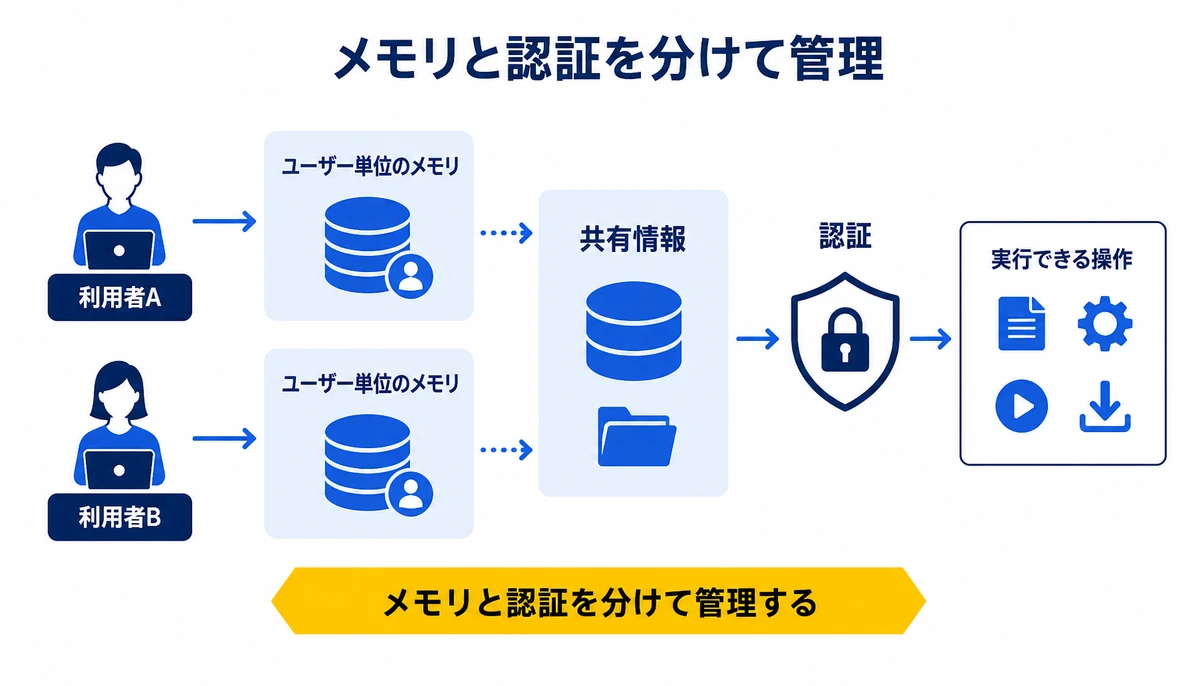
Managed Deep Agentsでは、ユーザー単位のメモリ、IDに紐づく認証、Web検索をエージェントに組み込む選択肢が広がると説明されています。利用者の情報を引き継ぐ処理と、誰が何を実行できるかを分けて設計できる点が特徴です。
たとえば、同じ社内エージェントでも、利用者ごとに参照できる情報や過去の会話は異なります。メモリを共有する範囲と、認証で制限する操作を先に決めないと、便利さが情報管理上のリスクに変わるかもしれません。
- ユーザー単位で保持する情報と共有情報を分ける
- 認証済みの利用者だけが実行できる操作を定義する
- Web検索で取得した情報の扱いを決める
- 退職や権限変更時のメモリとアクセスを確認する
レッドチーム評価は、攻撃的な入力や想定外の利用を試す検証です。これを運用に接続すると、導入前の一度きりの検査ではなく、変更のたびに安全性を確かめる仕組みに近づきます。
LangGraphの本番移行条件
試作と本番の確認項目の違い
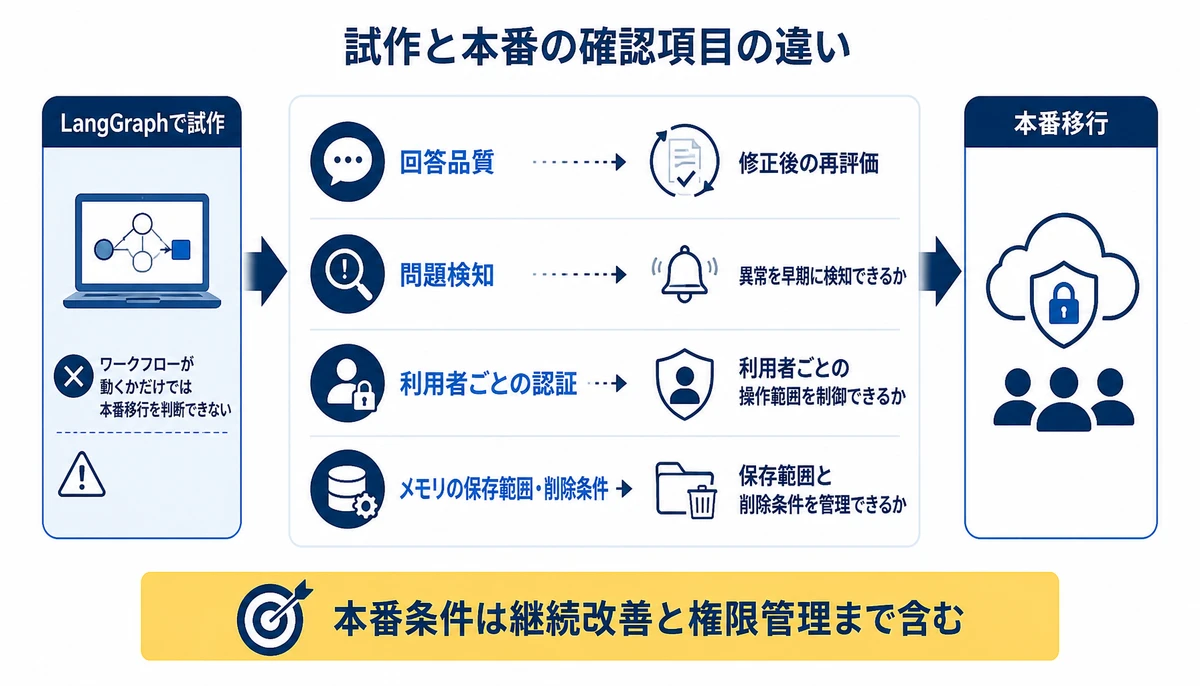
LangGraphで試作したエージェントを本番へ移すときは、ワークフローが動くかだけでは判断できません。問題検知、評価、認証、メモリの責任範囲を運用に置けるかが分かれ目になります。
| 確認領域 | 試作時の確認 | 本番移行前の確認 |
|---|---|---|
| 回答品質 | 代表的な質問で回答を確認 | 変更後も継続的に再評価できるか |
| 問題検知 | 失敗例を手動で確認 | 異常を早期に検知できるか |
| 認証 | 開発者の権限で動作確認 | 利用者ごとの操作範囲を制御できるか |
| メモリ | 会話の引き継ぎを確認 | 保存範囲と削除条件を管理できるか |
海外で本番エージェントの評価と運用が議論される一方、私たちが見てきた範囲では、試作段階では機能の実装が先行しやすい傾向があります。だからこそ、LangSmithの更新は機能追加としてではなく、運用設計を見直す材料として読みたいところです。
LangGraphを本番へ移す条件は、エージェントが動くことではなく、失敗を見つけて直し、利用者の権限を守りながら改善を続けられることです。

自社で進める際に詰まりやすい点
運用に定着しないよくあるつまずき
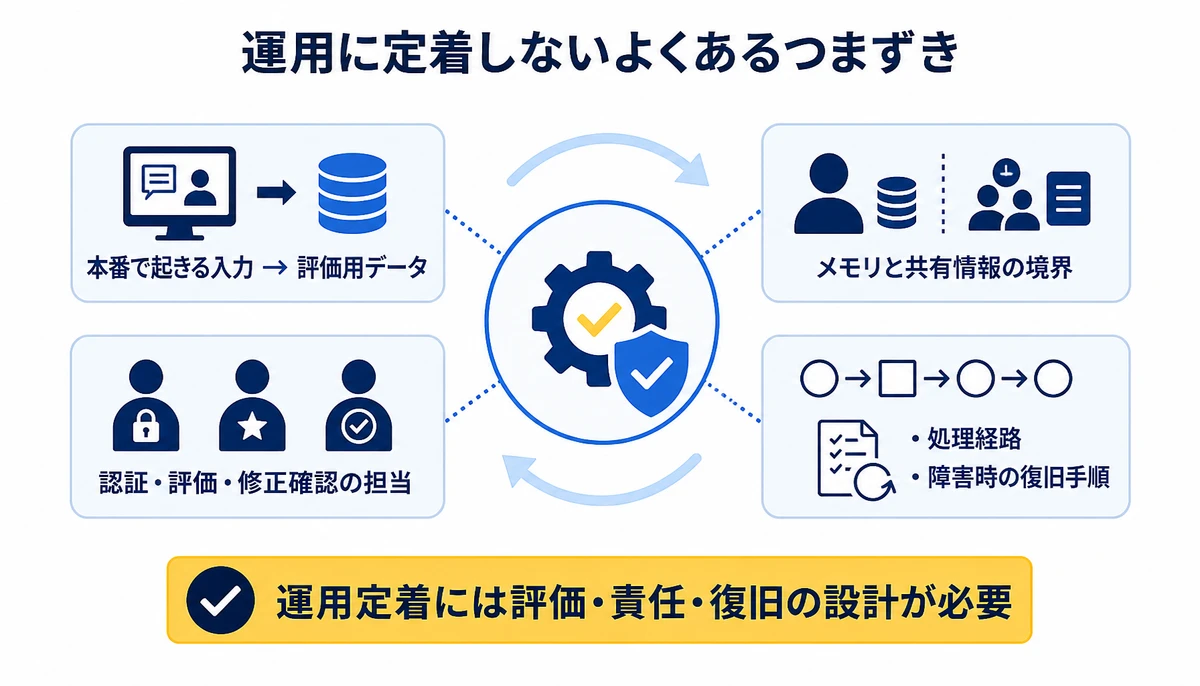
自社で取り組む場合、まず評価データの準備と、認証・メモリの責任範囲の整理で詰まりやすくなります。さらに、修正後の再評価を誰がいつ行うかを決めないと、Engine v2のような機能も運用に定着しません。
- 本番で起きる入力を評価用データとして整理する
- ユーザー単位のメモリと共有情報の境界を決める
- 認証、レッドチーム評価、修正後の確認担当を置く
- LangGraphの処理経路と障害時の復旧手順を文書化する
外部の支援を使う場合は、ツールを導入するだけでなく、現状の診断から要件、開発、本番展開までを一つの計画にまとめられます。BinxAI株式会社のサービス、みっちゃくんでは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。
見積は一式ではなく、要件を整理したうえで詳細に提示する形です。契約後に要件が動いても、決めた範囲の中で優先順位を入れ替えて進められます。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
LangSmith Engine v2は何を検証しますか?
発表では、エージェントの問題を先回りして検知し、修正結果を自動検証する機能が示されています。具体的な適用範囲は、利用する構成や評価方法の確認が必要です。
レッドチーム評価は本番後にも必要ですか?
本番後も、プロンプトやツール、権限の変更があれば評価対象になります。導入前の検査だけでなく、変更後に再実行できる運用を用意すると、問題の見落としを減らせるでしょう。
ユーザー単位のメモリで何を決めるべきですか?
保存する情報、共有する情報、削除する条件を決めます。認証で制御する操作とメモリに残す内容を分けて設計すると、利便性と情報管理を確認しやすくなります。
LangGraphのPoCはいつ本番へ移せますか?
代表的な回答が得られた時点ではなく、失敗の検知、修正後の評価、利用者ごとの認証、メモリ管理を継続できる状態が目安です。復旧手順と運用担当も確認してください。
Managed Deep Agentsとは何ですか?
LangChainの発表で示された、管理されたエージェント運用の選択肢です。ユーザー単位のメモリ、IDに紐づく認証、Web検索を組み込む選択肢が広がると説明されています。
あわせて読みたい
LangChainの更新は、AIエージェント開発の焦点が実装から本番運用へ移っていることを示しています。LangGraphを試す企業は、回答精度だけでなく、問題検知、レッドチーム評価、修正検証、認証、メモリを一体で確認してください。
本記事の情報は2026年9月28日時点の公開情報に基づきます。各サービスの機能や提供条件は変更される可能性があるため、契約前に各社へ確認してください。本記事の内容は特定の成果を保証するものではありません。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
本番前にAIエージェントをどう評価するかUAEFで合格基準を設計する
AWSが公開したUAEFは、回答品質だけでなくツール操作や安全性、性能、推論までAIエージェントを横断評価します。LangGraphやAmazon Bedrockに対応する評価基盤を、本番移行の合格基準へどう生かすかを整理します。
AIエージェントを本番業務へ移すMicrosoft Agent Framework運用設計の要点
Microsoft Agent Frameworkを手がかりに、AIエージェントを本番業務へ移す際のタイムアウト、状態管理、OpenTelemetry監視、失敗復旧、責任分界を設計者の視点で整理します。
Agent Lightning v1.0は企業のAI開発をどう変えるか
Microsoft Researchが公開したAgent Lightning v1.0は、既存のAIエージェントを実際の業務ハーネス上で改善する軽量フレームワークです。約3,500行、Kubernetes対応、SWE-benchでの評価結果から、企業が検討すべき開発と運用の論点を整理します。















