
Claude Code導入の次に何を整えるかJCRファーマの事例から学ぶ
要約
Claude Codeを導入した後、個人の開発効率で止めずに研究データや社内ナレッジを再利用するには何を整えるべきか。JCRファーマの事例をもとに、セマンティック化、全社データ基盤、機密情報の運用設計を段階的に整理します。
Claude Codeを試し、開発者の作業が速くなった企業は多いかもしれません。そこで導入を終えると、利用者の周辺だけに成果が閉じることがあります。
AWSは、JCRファーマが創薬研究と業務にClaude Code on AWSを活用している事例を公開しています。本稿では、その事例をツール導入後の設計図として読み解いていきましょう。
この記事の対象読者
対象は、Claude Codeや生成AIの試行を始めたものの、次に整える対象が決まっていない方です。研究開発、情報システム、経営企画のどの立場でも使えるように整理します。
- Claude Codeの利用を一部の開発者から広げたい責任者
- 研究データや社内ナレッジをAIで再利用したい担当者
- AWS生成AIの活用方針と情報管理を同時に考える情シス担当者
- 創薬AIや業務AIの評価指標を見直したいマネージャー
Claude Codeの成果が個人の速さで止まりやすい理由
情報の意味が揃っていないと回答が担当者依存になる
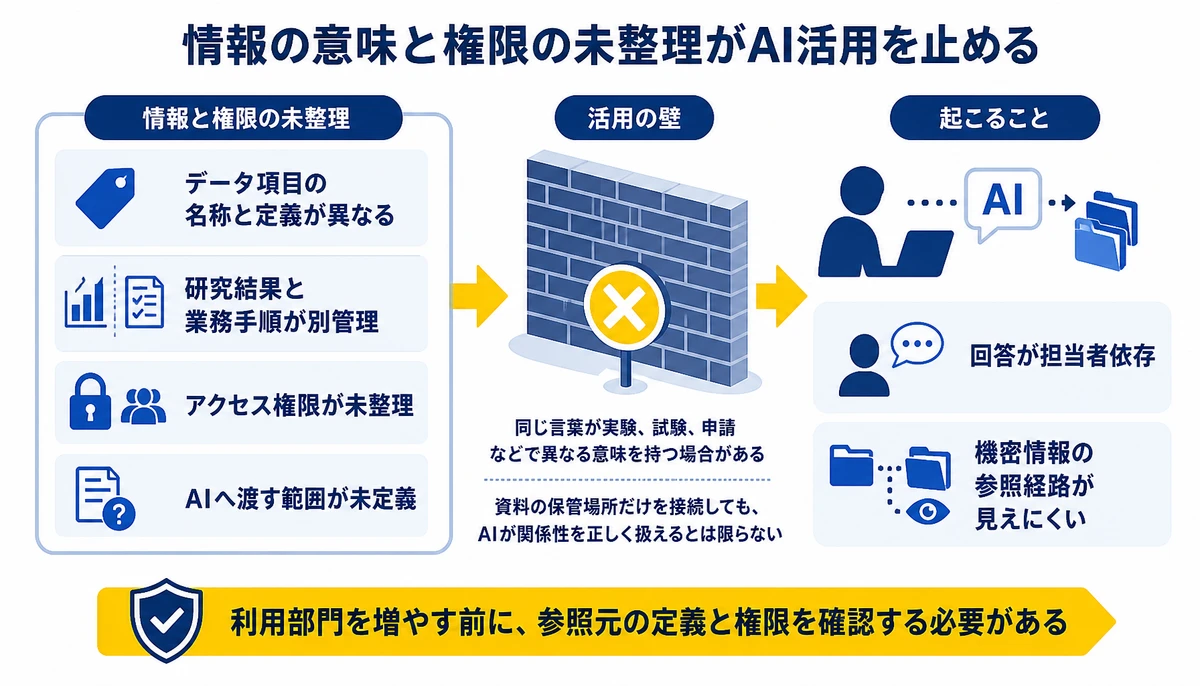
Claude Codeは、コード作成や修正を支援する接点です。しかし、AIが参照できる情報の意味が揃っていなければ、回答は担当者の手元にある資料へ依存します。
研究部門では、同じ言葉が実験、試験、申請などで異なる意味を持つ場合があります。資料の保管場所だけを接続しても、AIが関係性を正しく扱えるとは限りません。
- データ項目の名称と定義が部門ごとに異なる
- 過去の研究結果と業務手順が別々に管理されている
- 機密情報を含む資料へ誰がアクセスできるか整理されていない
- AIへ渡してよい情報の範囲が利用者の判断に委ねられている
BinxAIが見てきた範囲では、導入後に詰まりやすいのはモデル選びより、情報の意味と扱い方の整理です。AIを全社で使う前に、AIが読める社内情報を設計する必要があります。

JCRファーマの事例が示す導入後の広げ方
研究部門と情報システム部門を起点にした活用の進め方
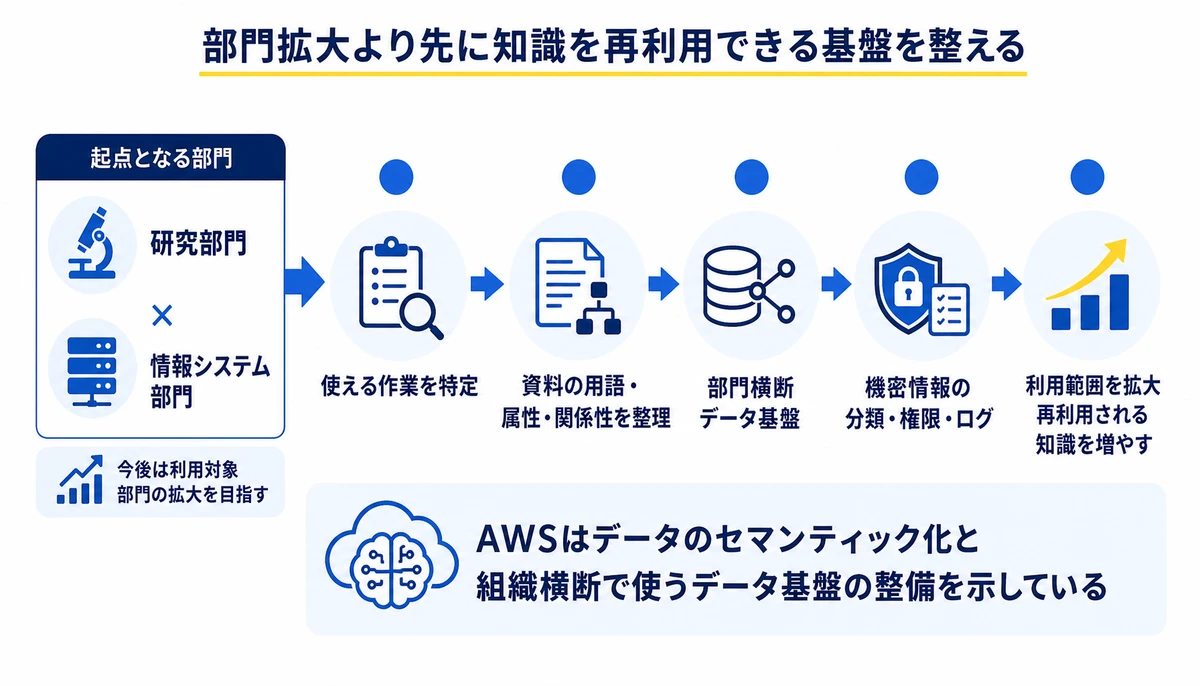
AWSの公開事例では、JCRファーマが研究部門と情報システム部門を中心にClaude Codeの活用を進めています。今後は利用対象部門の拡大を目指していると説明されているとのことです。
この事例を、単なる開発ツールの導入として読む必要はありません。研究と情報システムを接点にして、知識をAIが扱える状態へ移す取り組みとして見ると、次の手順が見えてきます。
- 研究や業務の中で、Claude Codeが使える作業を特定する
- 参照する資料の用語、属性、関係性を整理する
- 部門をまたいで利用するデータ基盤を設計する
- 機密情報の分類、権限、ログ確認の運用を決める
- 利用範囲を広げ、再利用される知識を増やす
AWSは、この事例の焦点をコーディング支援だけに置いていません。社内ノウハウをAIが扱えるように意味付けするデータのセマンティック化と、組織横断で使うデータ基盤の整備を示しています。
利用者数ではなく研究データの再利用性を見る
評価軸を「知識が組織資産として残るか」へ広げる
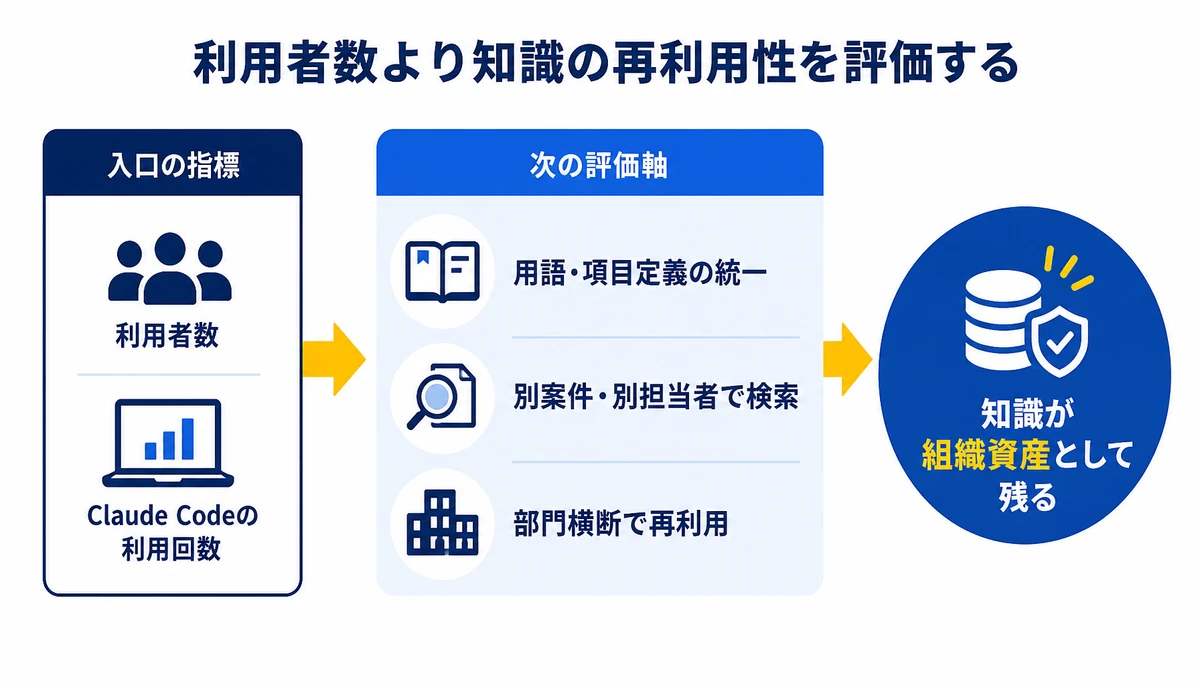
JCRファーマの公開事例から、導入効果を利用者数だけで評価しない視点が得られます。AIが一度作った回答ではなく、次の担当者が同じデータを再利用できる状態を見ましょう。
たとえば、研究データの項目定義が揃えば、検索や要約の前提を共有しやすくなります。情報システム部門が基盤を支えれば、個別の試行を部門横断の仕組みに移しやすくなるでしょう。
- 同じ用語を異なる部門が同じ意味で使えるか
- 過去のデータを別の案件や担当者が探せるか
- AIが参照した情報と参照できなかった情報を確認できるか
- 機密区分に応じて回答や検索範囲を制御できるか
- 作った仕組みを別部門へ展開できるか
評価会議では、Claude Codeの利用回数だけでなく、再利用されたデータの種類や部門を確認します。数値を決める前に、何が再利用された状態なのかを業務ごとに定義します。
ツールの利用率は入口であり、知識が組織の資産として残るかが次の評価軸です。これは創薬AIに限らず、製造、品質、管理部門にも応用できる見方です。
社内ナレッジをAIで使うための実装順序
まず一つの業務で意味と権限を具体化する
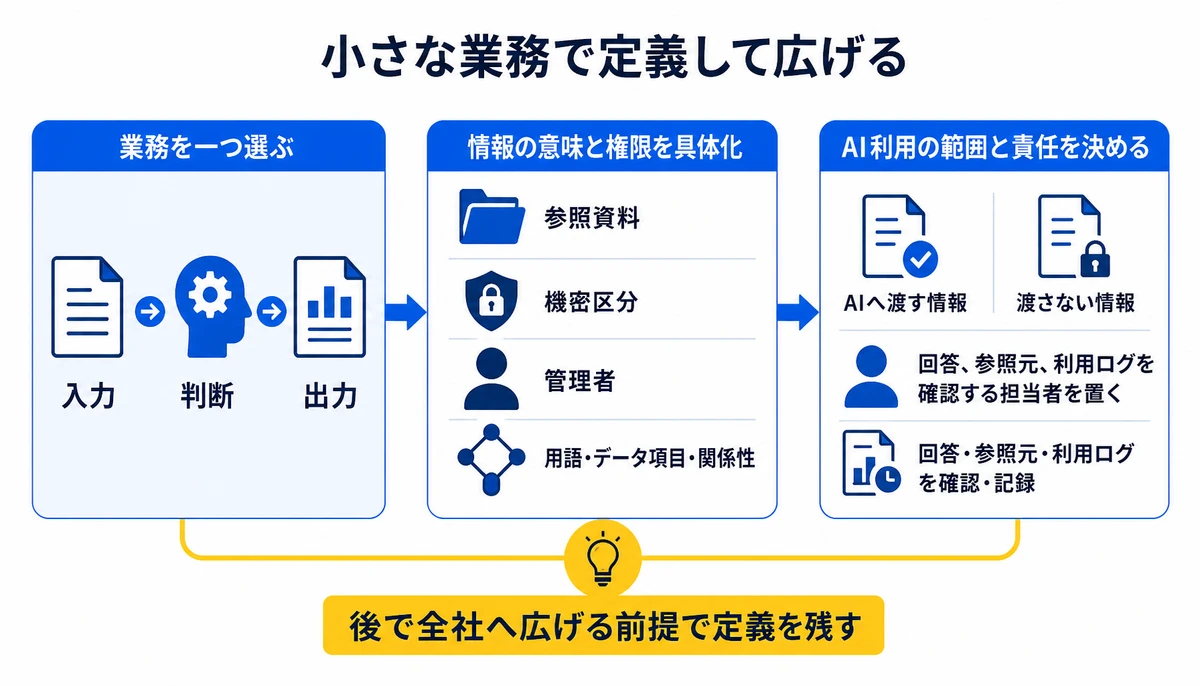
自社で始める場合は、いきなり全社データ基盤を完成させません。Claude Codeを使う業務を一つ選び、そこで必要な情報の意味と権限を具体化しましょう。
- 業務を一つ選び、入力、判断、出力を分解する
- 参照資料を列挙し、機密区分と管理者を記録する
- 用語、データ項目、資料間の関係性を定義する
- AIへ渡す情報と渡さない情報を分ける
- 回答、参照元、利用ログを確認する担当者を置く
次に、部門をまたいで使うデータの共通部分を見つけます。研究データだけでなく、業務手順や申請情報との関係も整理すると、社内ナレッジの再利用範囲を検討しやすくなるでしょう。
| 確認対象 | 先に決めること | 確認できる状態 |
|---|---|---|
| データの意味 | 用語と項目の定義 | 部門が変わっても解釈が揃う |
| アクセス権限 | 利用者と参照範囲 | 不要な機密情報を見せない |
| AIへの入力 | 渡す情報と除外情報 | 入力範囲を説明できる |
| 利用ログ | 記録項目と確認担当 | 利用状況を後から追える |
小さく始める場合でも、後で全社へ広げる前提で定義を残します。個人のプロンプトや一時的な加工だけに依存すると、担当者が変わった時に再現できません。

自社だけで進めると詰まりやすい境目をどう越えるか
この取り組みを自社だけで進めると、次のような境目で止まることがあります。JCRファーマの事例で示されたセマンティック化と基盤整備を、自社の業務へ落とす段階です。
- 研究部門と情報システム部門で、データ定義の責任者が決まらない
- 機密区分とAIへ渡す範囲を、業務ごとに切り分けられない
- 小さな試行の成果を、他部門で再現できる形に整理できない
外部の支援を使うと、業務タスクの棚卸しからデータ基盤、社内規約、定着までを一つの計画で確認できます。自社で判断する範囲と、専門家と設計する範囲も切り分けやすくなります。
BinxAIのみっちゃくんは、月額5万円からで、初期費用と追加費用はありません。API、サーバー、ツールの費用は実費です。
業務タスクの棚卸し、データ基盤の構築・改善、業務アプリ開発、AI推進や社内規約策定を支援します。AI研修、定着ワークショップ、AIアドバイザー、月次レポート、セキュリティ対応、社内展開にも対応しています。

よくある質問
Claude Codeを導入したら すぐに全社展開すべきですか?
すぐに広げるより、先に一つの業務で参照資料と権限を確認しましょう。AWSの公開事例でも、研究部門と情報システム部門を中心に活用を進めているとおり、起点を絞ることがポイントです。
データのセマンティック化では何を整理しますか?
用語、データ項目、資料同士の関係性の整理が出発点です。たとえば同じ言葉が部門ごとに違う意味を持つ場合、その違いを明示するところから始めましょう。
機密情報はAIに渡さない方がよいのでしょうか?
一律に決めず、情報の機密区分と業務目的で範囲を分けましょう。誰が何を参照できるか、利用ログを誰が確認するかも先に決めておくのが基本です。
導入効果はどの指標で確認すればよいですか?
利用者数だけでなく、研究データや社内ナレッジが別の担当者・別の部門で再利用されたかを見ましょう。再利用の定義を業務単位で決めると、評価がぶれにくくなるでしょう。
AWS生成AIの取り組みを小さく始めるには?
Claude Codeを使う業務を一つ選び、入力、判断、出力を分解するところが出発点。その後に参照資料、機密区分、AIへ渡す範囲を記録すると、次の基盤設計へつなげやすくなります。
JCRファーマの事例から見えるのは、Claude Code導入後の競争力がツール単体で決まらないということです。研究データと社内ナレッジを意味付きで整え、権限と運用を組み合わせて、AIが組織の知識を再利用できる状態へ近づけます。
まず今日、Claude Codeを使っている業務を一つ選び、参照している資料の機密区分と担当者を書き出してみてください。そこから整理が始まります。
本記事に挙げた他社の料金や制度は、執筆時点で公開されていた情報です。お申し込みの前に、各社の最新の内容をご確認ください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
AnthropicがCompliance APIをリリース 企業のAIガバナンスに必要なものとは
AnthropicがCompliance APIを発表し、Claude CoworkやClaude Codeの利用状況を企業のコンプライアンス管理へ接続しやすくしました。発表内容と、ログ・権限・保存期間・部門別ルールを整える実務の進め方を解説します。
汎用AIの次は業務特化Guidewire Qusarを読む
Guidewire Qusarを手がかりに、保険契約や保険金請求へAIエージェントを組み込む際の考え方を整理します。モデル性能だけでなく、業務データ接続、権限、承認、監査、ROIをどう設計するか、導入の順番と判断基準を紹介します。
GLM-5.3が更新 エージェントの性能とコストはどう変わるか
Z.aiが発表したGLM-5.3は、コーディングだけでなく長時間エージェントタスクやサイバーセキュリティ分析を評価対象にしています。発表内容を整理し、日本企業が実データで性能と運用コストを検証する観点を解説します。















