
NVIDIAが常時稼働AIエージェント向けモデルを投入 クラウドからエッジまでの配置を整理する
要約
NVIDIAが常時稼働するAIエージェント向けに、クラウドだけでなくデータセンターやRTX搭載端末、エッジへ配置できるモデル展開を示しました。Nemotron 3.5 Super VLとBoltの位置づけ、費用計算、データ境界、障害復旧を導入前に確認する視点を整理します。
NVIDIAが、常時稼働するAIエージェントを意識したモデル展開を示しました。対象は単発の質問応答ではなく、推論を重ねて業務システムやツールを操作する使い方です。
2026年10月17日時点で、企業が見るべき点はモデルの回答性能だけではありません。クラウドAPI、社内データセンター、RTX搭載端末、エッジのどこで処理するかが、導入後の費用と責任を左右します。
この記事の対象読者
次のような課題を持つ企業や組織に向けた内容です。
- AIエージェントを現場業務へ導入したい企業
- 機密データをクラウドへ送れない企業
- 製造や物流の映像データを活用したい企業
- GPU投資とAPI利用を比較したい企業
- 常時稼働するAIの運用責任を決めたい企業
NVIDIAが示したモデル展開
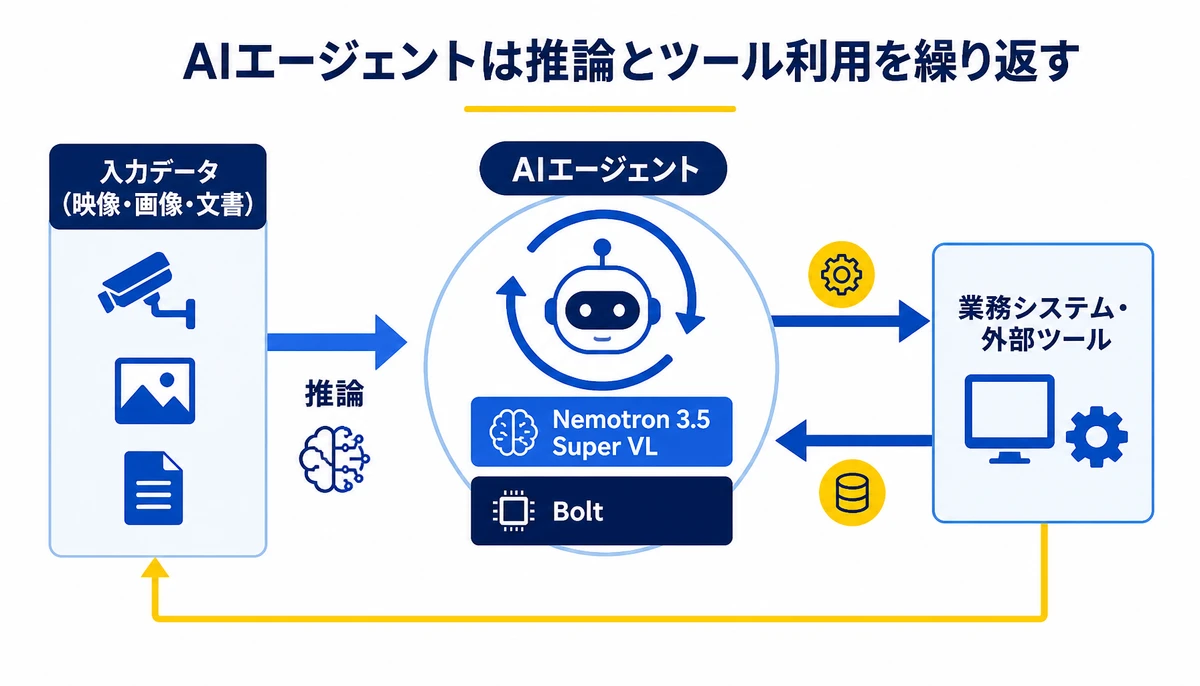
NVIDIAは、AIエージェントを推論やツール利用によって業務を実行するAIの活用領域として位置づけています。今回の展開も、チャット画面で回答するモデルではなく、業務の途中で判断と実行を繰り返す基盤として読むことができます。
ニュースの中心にあるのが、Nemotron 3.5 Super VLとBoltです。前者はマルチモーダルAIの処理を担うモデル群の位置づけで、後者は現場の端末やエッジでの利用を想定する選択肢として整理できるでしょう。
- Nemotron 3.5 Super VL、映像や画像を含む情報を推論するモデルの位置づけ
- Bolt、現場に近い場所で推論を動かすエッジAIの選択肢
- クラウドAPI、データセンター、RTX搭載端末、エッジを使い分ける配置
- AIエージェントが業務システムや外部ツールを呼び出す運用
企業側はモデル名だけを比較せず、どのデータを入力し、どの操作を許可するかまで確認する必要があります。

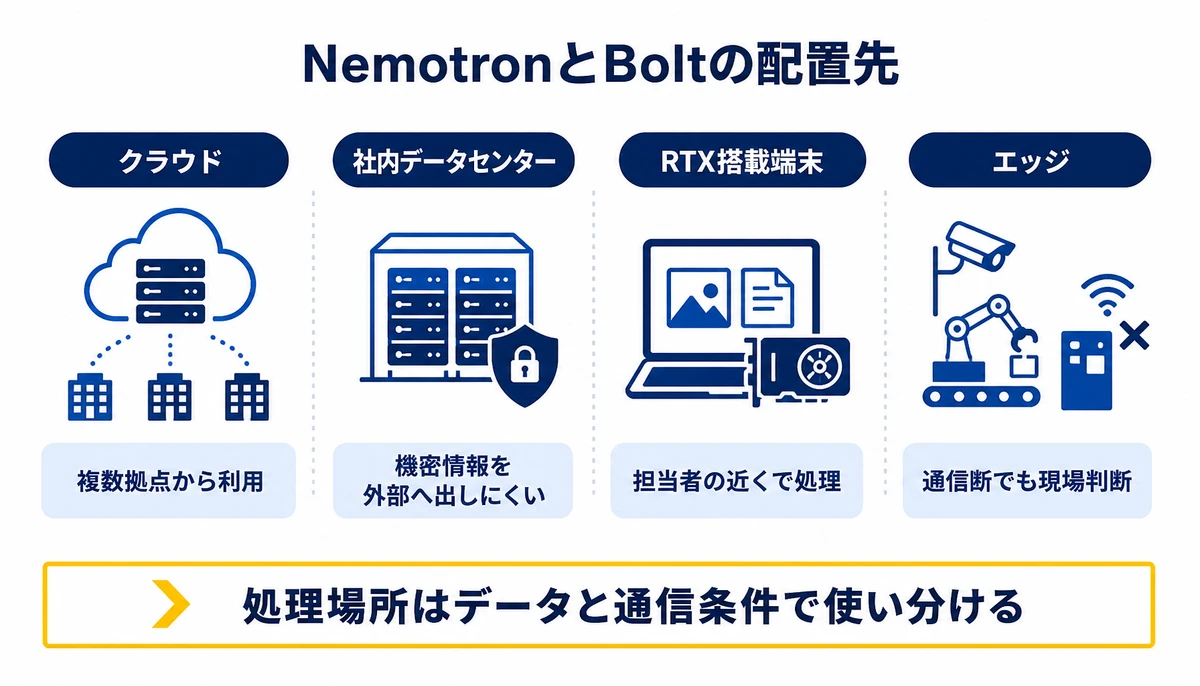
NemotronとBoltの配置先
Nemotron 3.5 Super VLを使う場面では、カメラ映像や画像、文書など複数の情報を組み合わせる設計が想定されます。製造ラインの異常確認や物流拠点の状況把握では、回答文よりも判断結果を既存システムへ渡せるかが焦点でしょう。
BoltのようなエッジAI向けの選択肢では、通信を経由せずに現場で処理できる構成を検討できます。通信が不安定な場所や、映像を外部へ送れない環境では、検知結果だけを上位システムへ渡す設計も候補です。
- クラウド、複数拠点から同じモデルを利用したい業務
- 社内データセンター、機密情報を外部へ出しにくい業務
- RTX搭載端末、担当者の近くで画像や文書を処理する業務
- エッジ、通信断が起きても現場判断を続けたい業務
BinxAIが現場で見てきた範囲では、配置先の議論がモデル性能の比較だけで終わると、本番直前に要件が動きやすくなります。入力データの境界と、停止したときに誰が何を判断するかを先に決めると、構成を絞りやすくなるでしょう。
常時稼働で変わる費用計算
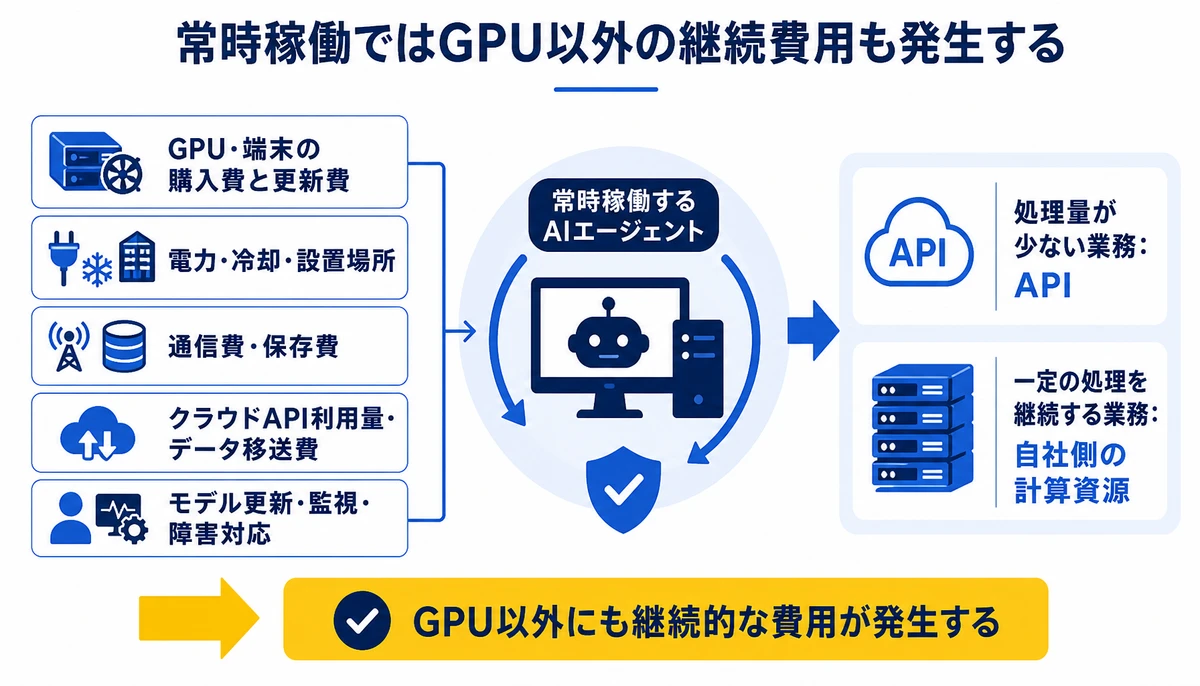
単発のチャットでは、利用回数や入力と出力の量を中心に費用を考えます。常時稼働するAIエージェントでは、処理を待機させる時間や監視の仕組みも運用コストに含める必要があります。
- 推論に使うGPUや端末の購入費と更新費
- 稼働中に発生する電力、冷却、設置場所の費用
- 映像やセンサー情報を送る通信費と保存費
- クラウドAPIを併用する場合の利用量とデータ移送費
- モデル更新、監視、障害対応を担う人員と時間
GPU投資とAPI利用を比べる際は、単価だけで決めないことが必要です。処理量が少ない業務ではAPIが扱いやすく、一定の処理を継続する業務では自社側の計算資源が候補になる場合があります。
最初の試算では、業務の入力件数、映像の保存期間、許容できる停止時間、モデル更新の頻度を並べます。これらを置かずに月額の比較だけをすると、本番後に通信費や保守費が膨らむ可能性があるため注意が必要でしょう。
本番前に決めるデータ境界と復旧
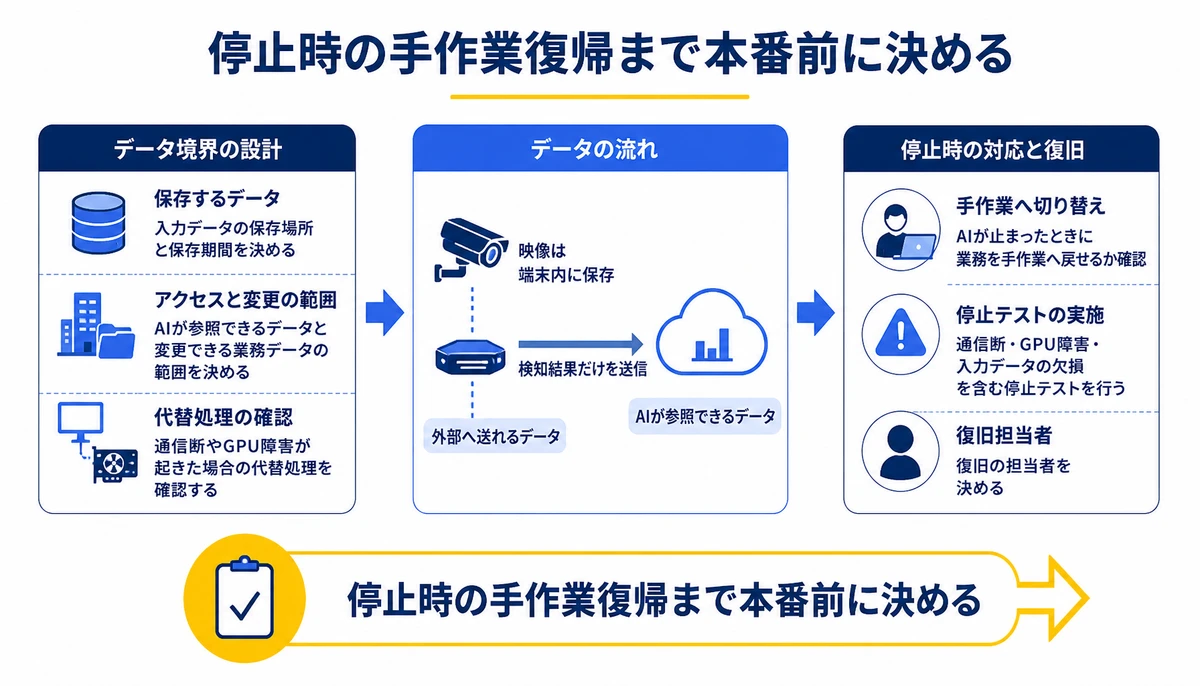
機密データをクラウドへ送れない企業では、どの情報を外部へ出せるかを項目ごとに分けます。映像そのものは端末内に残し、検知結果だけを送る設計も考えられるでしょう。
- 入力データを保存する場所と保存期間
- モデルが参照できる社内システムの範囲
- ツール実行で変更できる業務データの範囲
- 通信断やGPU障害が起きた場合の代替処理
- モデル更新の承認者と、更新後の検証担当
復旧設計では、AIが止まったときに業務を手作業へ戻せるかを確認します。自動発注や設備制御のように停止の影響が大きい処理は、通知だけを自動化する段階から始める方法もあるでしょう。

自社導入で詰まりやすい点
この構成を自社で進める場合、モデル選定より先に、映像や文書をどこまで扱うかを決める作業で詰まりやすくなります。クラウドとエッジの境界が曖昧なままだと、費用計算と障害時の責任分担も固まりません。
- 現場データの分類と、外部送信の可否が決まっていない
- 常時稼働に必要なGPU、通信、保存の条件を試算できていない
- 通信断やモデル更新後の復旧手順を検証できていない
外部の支援を使う場合は、モデルの提案だけでなく、現場の業務整理から依頼できるかを確認します。要件が動く前提で、構成の優先順位と見積の範囲を調整できる体制も判断材料になるでしょう。
BinxAI株式会社 | みっちゃくん
BinxAI株式会社のみっちゃくんは、提案の前に現場へ入り、課題の整理と現状の診断を済ませてから要件を固めます。一式の見積ではなく詳細な見積を出し、契約後に要件が動いても決めた範囲の中で優先順位を入れ替えて進む体制です。
企画、課題整理、要件整理から開発までを同じ担当が一気通貫で受け持ちます。本番環境への展開後は、運用の引き継ぎや内製化、担当者向けの研修まで支援する体制です。
- 課題の整理と現状の診断
- 要件定義と設計
- 開発と本番環境への展開
- 運用の引き継ぎと内製化の支援
- 担当者向けの研修

よくある質問
Nemotron 3.5 Super VLは何に使うモデルですか?
画像や映像などを含む情報を扱うマルチモーダルAIのモデルとして位置づけられています。製造や物流で使う場合は、認識精度だけでなく、結果を既存の業務システムへ渡せるかを確認します。
BoltはクラウドAPIの代わりになりますか?
業務によっては代替候補になりますが、すべての処理を置き換えられるとは限りません。通信条件、端末の計算資源、モデル更新の方法を比べ、現場で処理すべき部分を切り分けるのが先決でしょう。
常時稼働AIの費用は何を見積もればよいですか?
GPUや端末の費用だけでなく、電力、通信、保存、監視、更新、障害対応を含めます。API利用と自社設備を比較する際は、処理量と停止時の業務影響も同じ表に並べると判断しやすくなります。
本番前に決めるデータ境界とは何ですか?
AIが参照できるデータ、外部へ送れるデータ、保存するデータを分けた境界です。映像そのものを外部へ出さず、検知結果だけを送る構成も候補になります。
通信断やモデル障害にはどう備えますか?
停止時に手作業へ戻す手順と、AIを使わずに継続できる最低限の業務を決めます。復旧担当者、切り替え条件、更新後の検証方法を本番前に確認してください。
NVIDIAの展開は、AIエージェントをクラウド上のチャット機能だけでなく、現場に近い場所で継続運用する基盤として考えるきっかけになります。導入時は、モデルの比較と同時に、費用、データ境界、復旧、更新責任を業務単位で決めてください。
この記事の分類
同じ分類の記事をまとめて読めます。
次に読む記事
AIエージェントが増えた会社に必要な司令塔 接続と権限を一元管理する方法
AIエージェントやMCP接続先が増えると、個別のPoCだけでは権限や監査ログを管理しきれません。Salesforce Japanの発表を手がかりに、Agent FabricとOmni Gatewayの役割、棚卸しから本番移行までの確認項目を整理します。
データを外へ出さないAIエージェント運用 ローカルとクラウドの使い分け方
PerplexityのPortable Computerが示したローカルAIエージェントの可能性を整理します。24GB以上のVRAM要件、クラウドとの使い分け、端末権限と機密データの管理を確認し、検証時の判断軸を解説します。
Claude Coworkを安全に使うための権限とログ設計 実務の整理
Claude Coworkを長時間タスクや社内ファイル処理に使う企業向けに、クラウド実行とサンドボックスの境界、管理者による機能制御、権限の分け方、監査ログ、本番移行前の停止と復旧までを実務の設計項目として整理します。















